
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Долговременную память LLM-агента научили собирать из дополняющих друг друга записей, а не из фактов, которые по отдельности больше всего похожи на запрос. MemPursuit повысил точность ответов и в 32,9 раза ускорил повторное ранжирование относительно BGE-v2-m3; работа не рецензирована, а числа в ней получили сами авторы. Для продукта это означает, что последний этап доступа к памяти можно улучшить без обучения отдельной модели и увеличения контекста.
Как алгоритм определяет, какого факта не хватает
Обычный поиск оценивает каждую запись независимо и передаёт модели несколько лидеров списка. Если история длинная, среди них могут оказаться разные пересказы одного события: все они хорошо совпадают с запросом, но занимают место факта, без которого нельзя построить полный ответ.
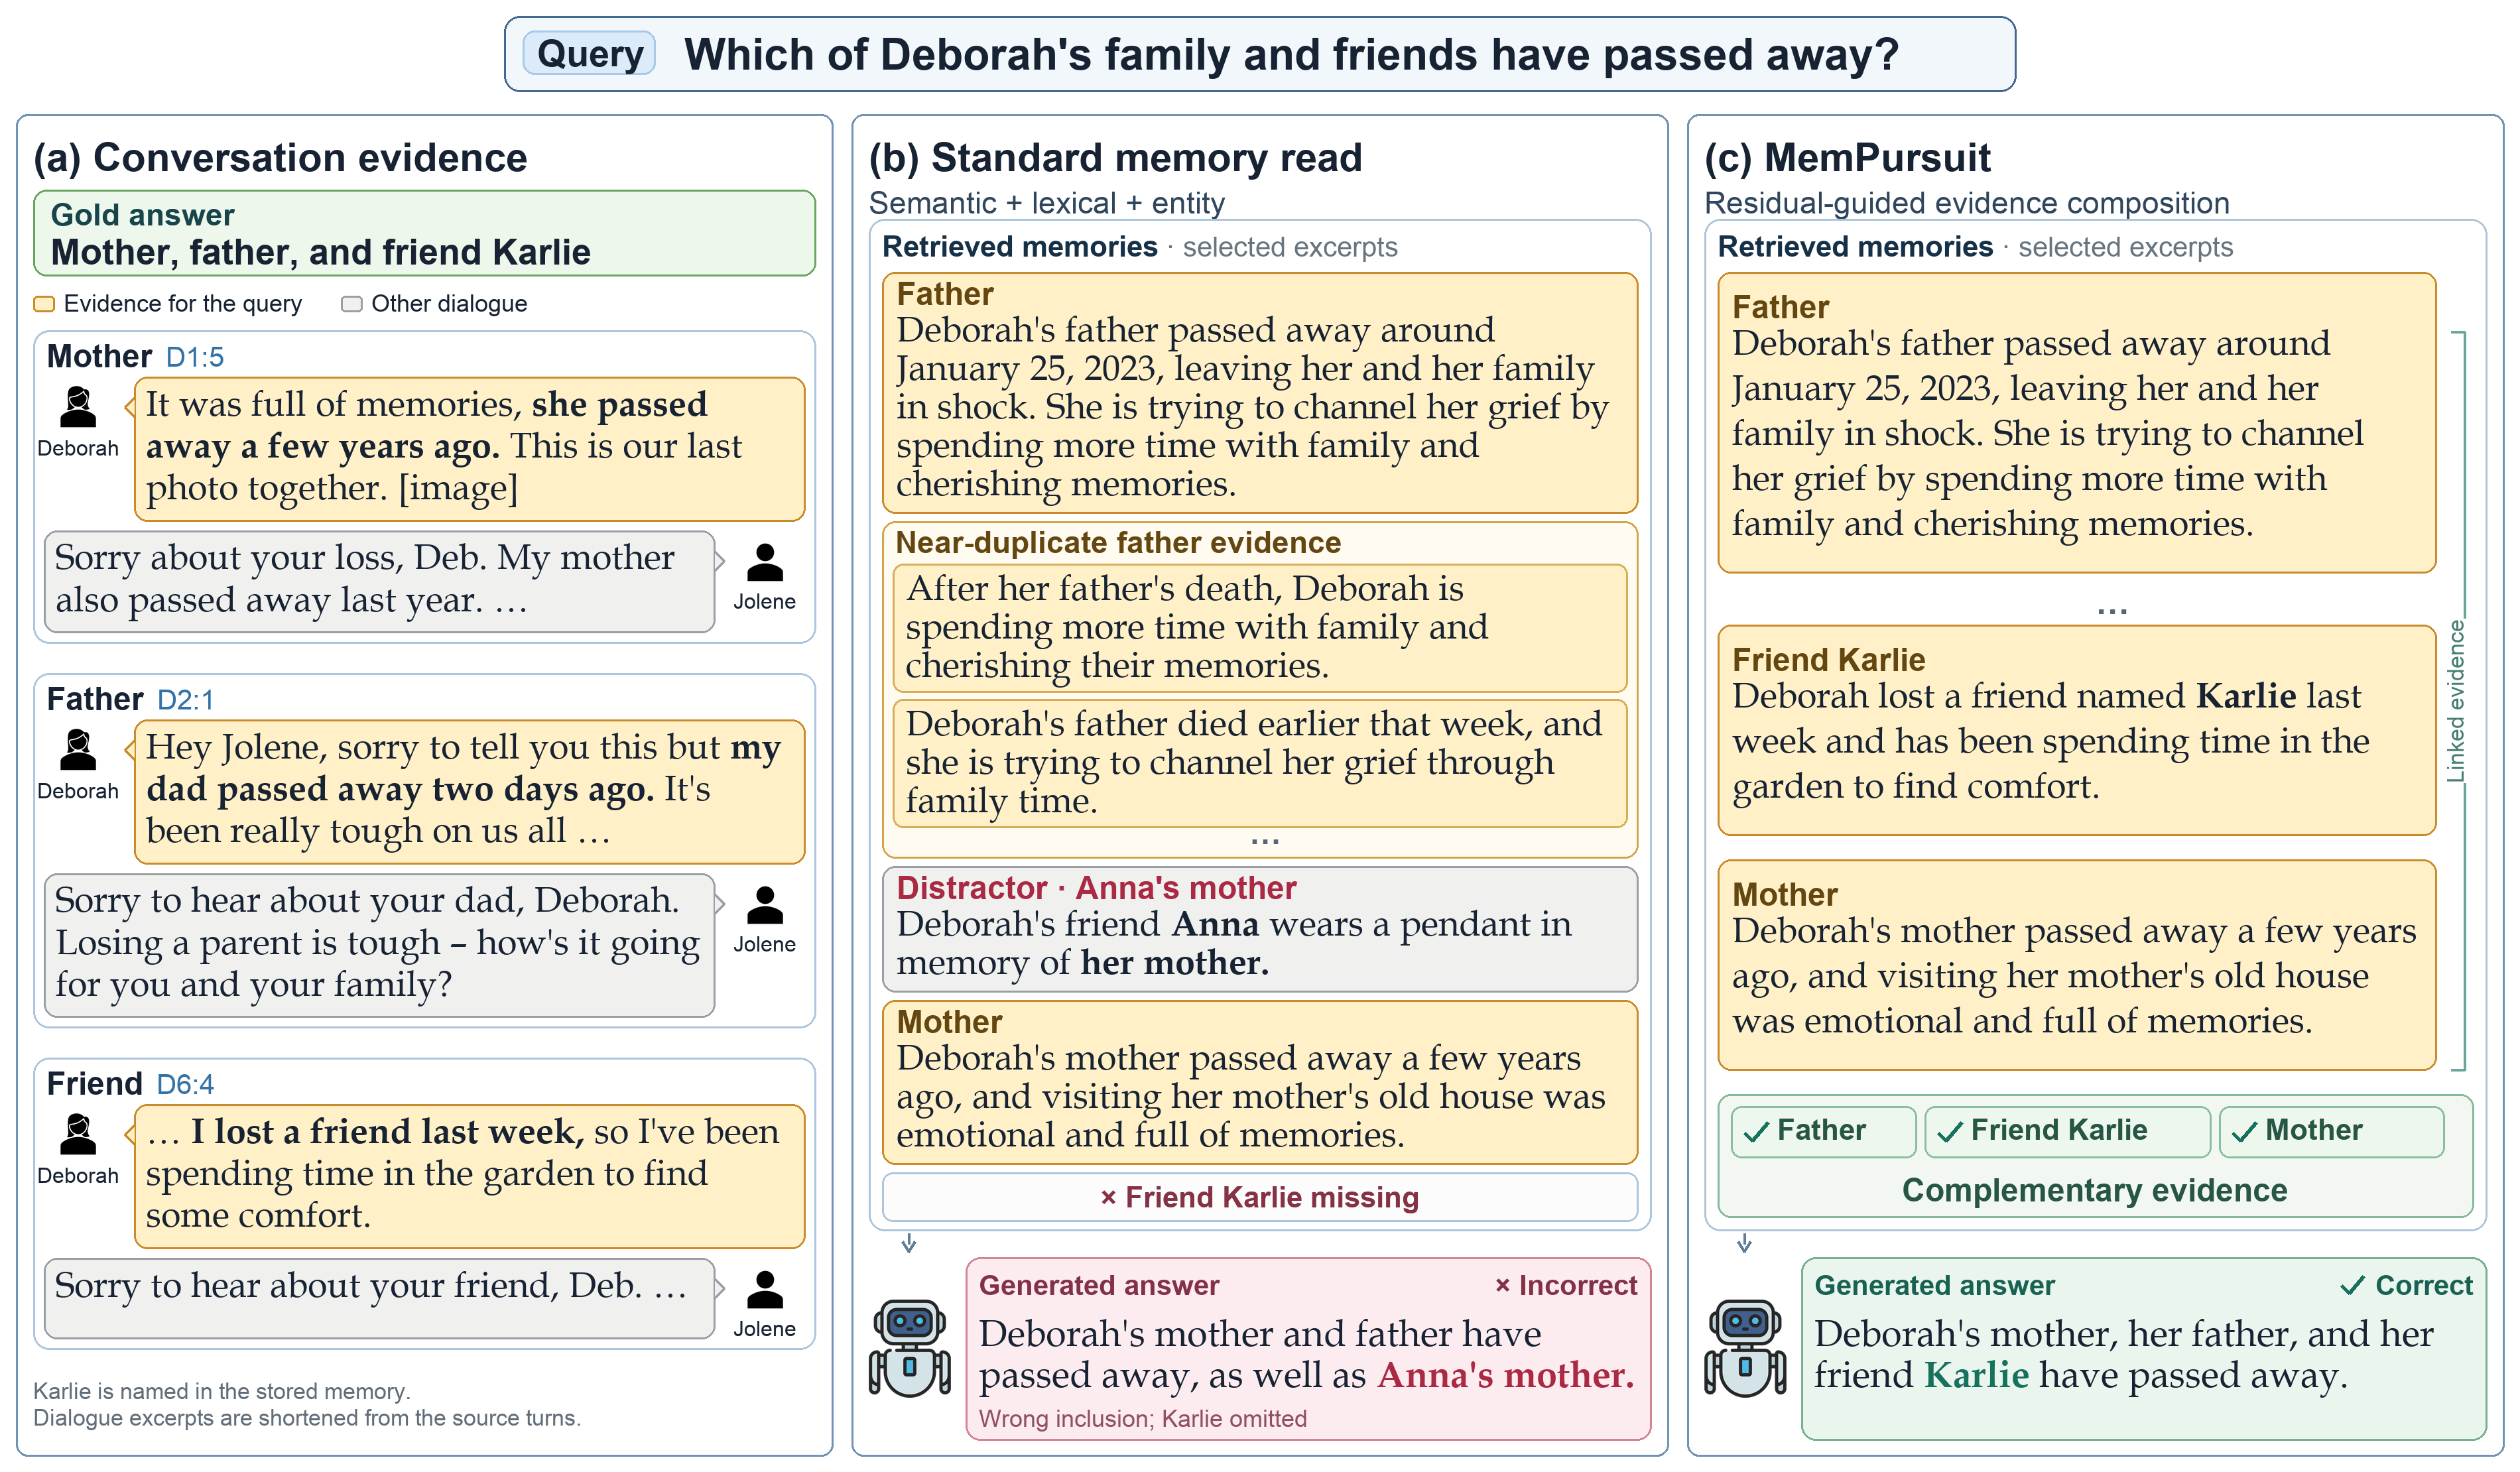
В примере из работы агенту нужно назвать умерших родственников и друзей Deborah. Стандартный поиск несколько раз возвращает сведения об отце и пропускает подругу Karlie. MemPursuit выбирает записи об отце, матери и Karlie, поэтому модель получает всю цепочку свидетельств.
Алгоритм начинает с записи, чьё векторное представление ближе всего к запросу. Затем он пытается представить запрос как взвешенную смесь уже выбранных записей. Разница между запросом и этой смесью показывает направление, которое текущий контекст ещё не покрывает.
Следующей становится запись, лучше всего совпадающая с этим остатком. После каждого шага MemPursuit заново распределяет неотрицательные веса между всем выбранным набором, поэтому очередной выбор учитывает уже найденные факты. Похожие записи получают меньше влияния, а дополняющие набор — больше.
Для расчёта используются векторные представления, которые система уже получила при первоначальном поиске. MemPursuit не вызывает LLM и не запускает отдельную нейросетевую модель для каждой пары запроса и записи. Один проход сразу создаёт вложенные варианты контекста: короткий набор служит началом более длинного, а при небольшом улучшении восстановления запросов отбор можно остановить раньше.
Веса управляют поиском, но не фильтруют готовый контекст: выбранная запись остаётся в нём, даже если после пересчёта её вес стал нулевым. Это сохраняет порядок отбора и не превращает внутреннюю геометрию алгоритма в ещё один непрозрачный порог удаления фактов.
Дополняющие записи повысили точность на многошаговых вопросах
В контролируемом опыте на LoCoMo исследователи оставили неизменными хранилище, исходный набор кандидатов, лимит памяти, модель ответа и способ оценки. При лимите в 10 записей MemPursuit повысил общую точность на 7,2 процентного пункта. На многошаговых вопросах, где ответ нужно собрать из нескольких событий, прирост достиг 12,8 пункта.
При более широком лимите точность дошла до 85,1% и превысила результат гибридного поиска, которому передавали больше записей. Значит, выигрыш дал не дополнительный объём контекста, а более полный набор свидетельств внутри него.
При сравнении повторного ранжирования BGE-v2-m3 оставался точнее, но требовал отдельной нейросетевой оценки кандидатов. MemPursuit использовал только матричные и векторные операции над готовыми представлениями, чем и объясняется разрыв по задержке. Замер охватывал только финальный отбор: получение кандидатов и генерация ответа в него не входили.
Метод также проверили на LongMemEval-S и BEAM, с моделями ответа GPT-4o-mini и Qwen3-30B-A3B-Instruct-2507. В отдельных сравнениях его подключали к LightMem, MemoryBank, SimpleMem и Mem0, не меняя их хранилища и исходные наборы кандидатов. Так работа отделяет эффект чтения памяти от того, как система записывает, сжимает и организует историю.
Когда MemPursuit меняет план разработки
Работа предлагает не новую архитектуру памяти, а замену последнего этапа отбора. Если система уже хранит векторные представления записей и формирует пул кандидатов, MemPursuit можно поставить между поиском и сборкой контекста. Обучать модель-оценщик, поддерживать дополнительный набор весов или перестраивать формат памяти для этого не требуется.
Такой вариант меняет план команды, если узкое место находится в повторном ранжировании: контекст заполняют дубликаты, многошаговым ответам не хватает одного события, а нейросетевой оценщик добавляет задержку. Тогда разумно сначала сравнить MemPursuit с текущим отбором на одинаковых кандидатах и лимите, не трогая запись памяти и генерацию ответа.
Метод не заменяет извлечение кандидатов. Если нужная запись не попала в исходный пул, восстановить её через остаток запроса нельзя. Он также зависит от того, отражает ли геометрия векторных представлений необходимые связи: явные временные, причинные и контекстные отношения MemPursuit самостоятельно не рассуждает.
Поэтому результат поддерживает точечное изменение архитектуры, а не полный переход на новую систему памяти. Команде достаточно проверить качество ответов и задержку на собственных историях; выигрыш в работе получен именно при неизменных кандидатах и остальной цепочке.
Источники
Иллюстрация: рисунок из статьи «Recall What Is Missing: Composing Evidence from Long-Term Agent Memory», Qi Feng, Jicong Fan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


