
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Портфельного LLM-агента научили проверять, помогает ли конкретный прошлый опыт, а не приписывать ему общее движение рынка. MemTrial в среднем по тестам поднял полезность портфеля — оценку результата с учётом доходности, риска и торговых издержек — на 21,2% относительно лучшего агента, который учится на опыте; работа не рецензирована, а числа в ней получили сами авторы. Для разработки это меняет роль памяти: её выводы стоит применять только после проверки на следующих, ранее не виденных периодах.
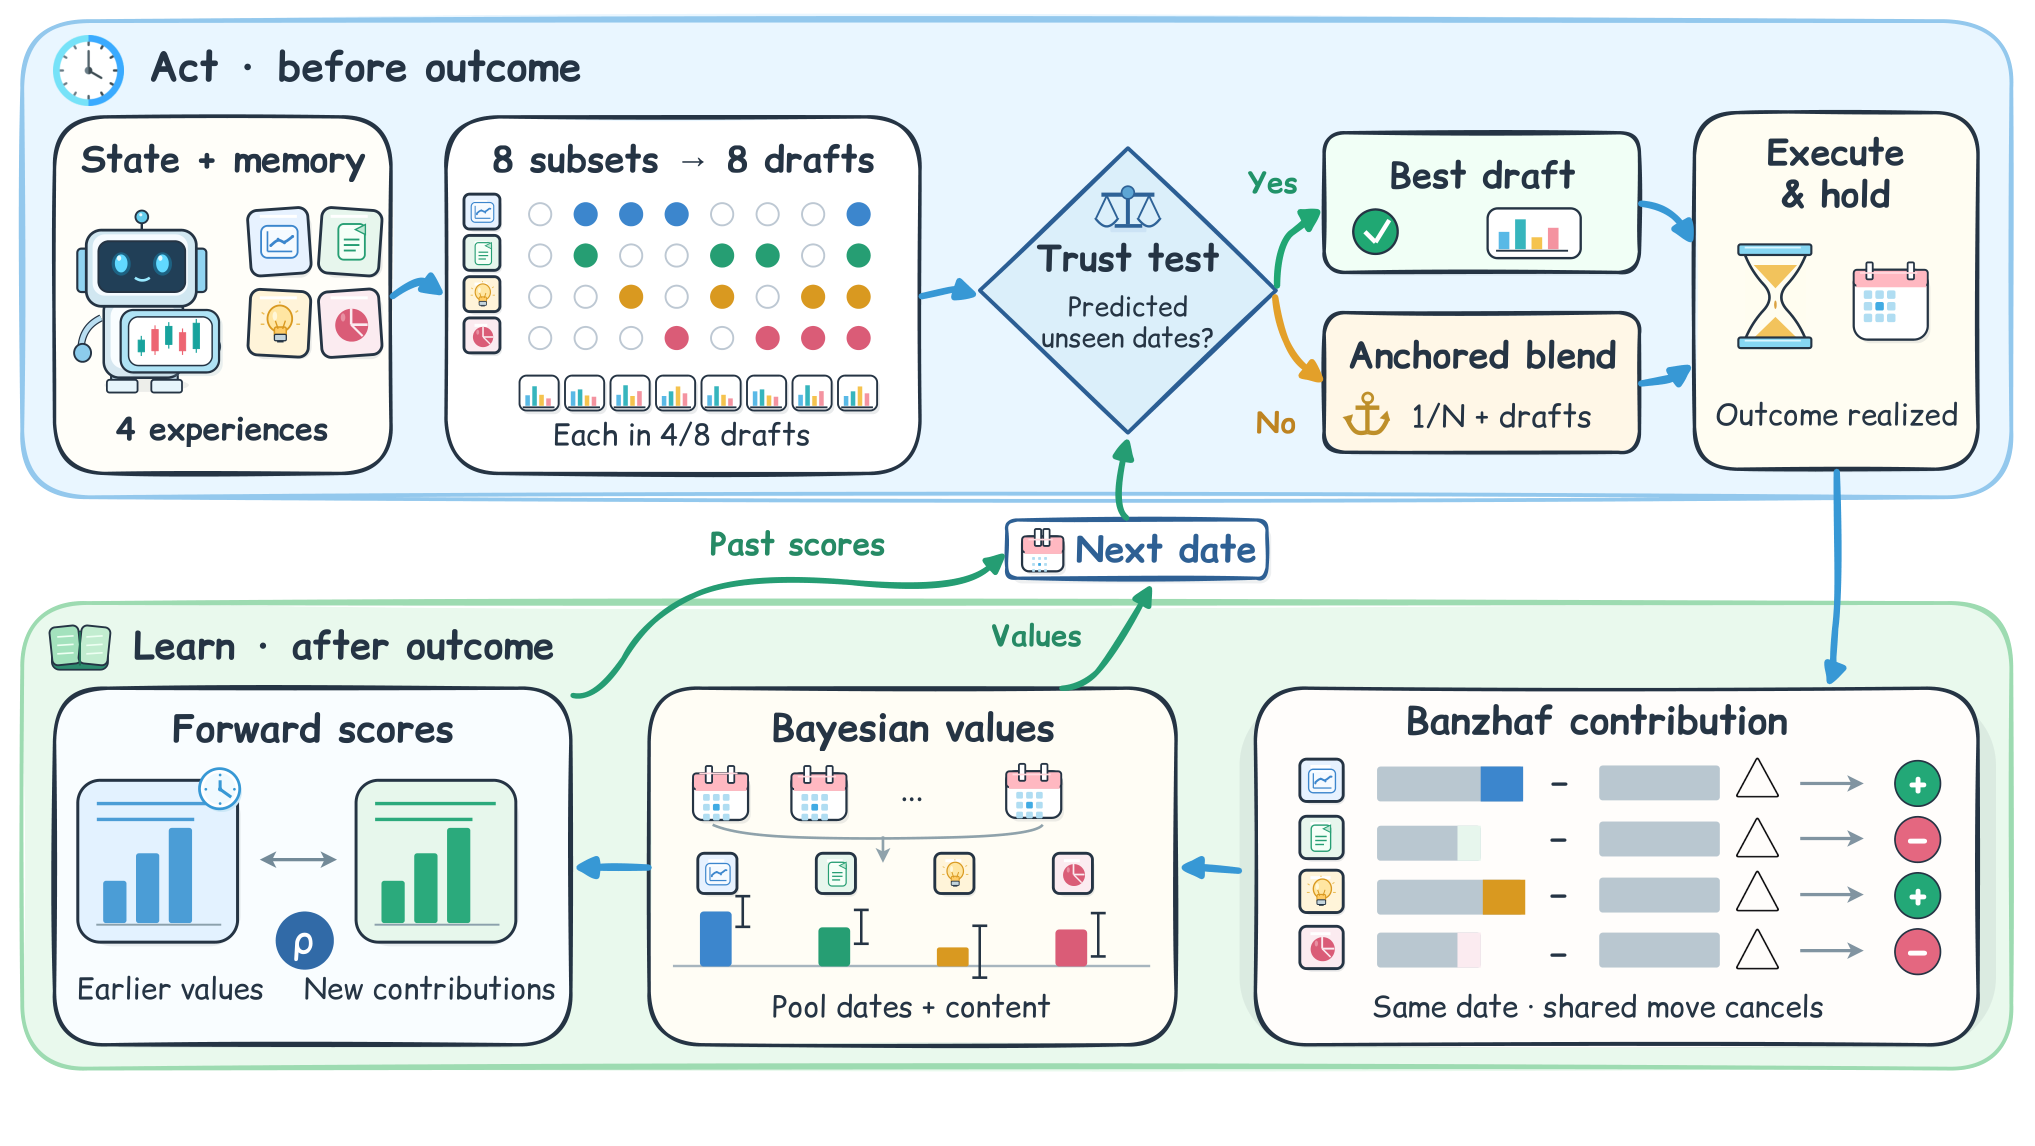
Guanghao Wu, Zhuo Cai и Shoujin Wang построили для каждого решения контролируемое сравнение. Агент извлекает четыре подходящих воспоминания и создаёт восемь вариантов портфеля с разными сочетаниями опыта. Для каждого воспоминания он вычисляет значение Banzhaf — среднюю разницу между результатами вариантов с этим опытом и без него; поскольку все варианты проходят через один рынок, общее движение цены вычитается.
Результат одной даты слишком зависит от случайного ответа модели. Поэтому MemTrial объединяет наблюдения по времени и похожему содержанию с помощью иерархической байесовской модели, а затем проверяет, предсказывают ли оценки вклад опыта на новых датах. Если доказательств не хватает, агент смешивает свои варианты с равновзвешенным портфелем, где каждому активу достаётся одинаковая доля.
Метод проверили на реальных PortBench, InvestorBench и ClassAlloc, а также в полусинтетической среде PlantedMem с известным качеством опыта. В PlantedMem он занял первое место среди 15 методов; на InvestorBench его испытали с восемью LLM, и во всех случаях он обошёл остальные подходы на основе LLM.
На PortBench и InvestorBench MemTrial отстал от равных долей не более чем на 2,2%, тогда как лучший другой агент с обучением на опыте — на 15–38%. При этом на реальных рынках оценки памяти проходили проверку максимум в 0,3% решений, а тот же защитный якорь помогал конкурентам не хуже. Значит, подтверждённый результат здесь — защита от вредной памяти, а не способность стабильно извлекать из неё прибыль.
Источники
Иллюстрация: рисунок из статьи «MemTrial: Learning When to Trust Memory in LLM Portfolio Agents», Guanghao Wu, Zhuo Cai, Shoujin Wang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


