
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Документ можно один раз подготовить так, чтобы разные LLM искали в нём сведения и отвечали на вопросы без повторного чтения всего текста. Residual-MII превзошёл чтение полного контекста при меньших затратах на механизм внимания; хотя препринт не рецензирован, числа в нём получили сами авторы. Для продуктов с большими стабильными архивами это открывает отдельный слой машинной памяти, но пока не отменяет хранение исходного текста.
Writer сжимает документ, Translator подключает конкретную модель
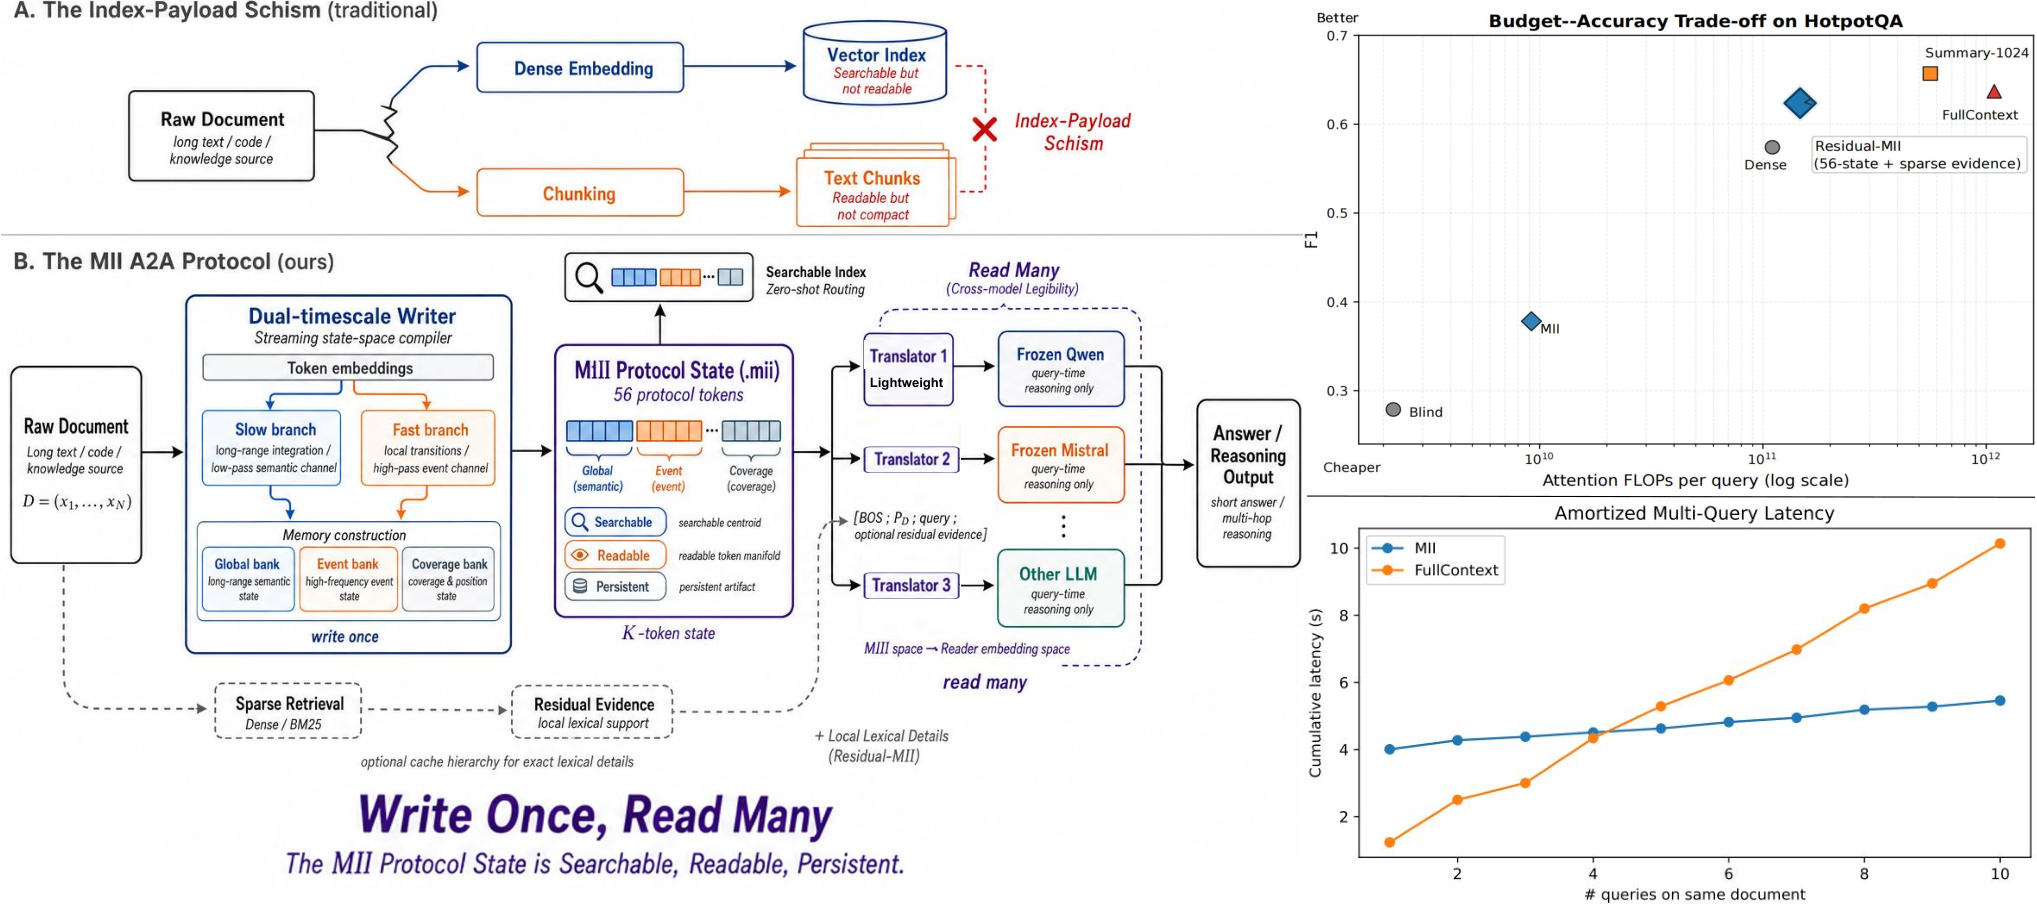
Yifan Wang из NexusLumenLabs и Dejing Dou из Fudan University предложили MII — формат состояния документа для обмена между моделями. Вместо текста Writer сохраняет непрерывные векторы в 56 позициях. Это не краткое изложение и не набор читаемых токенов: состояние рассчитано на обработку другой нейросетью.
Writer построен на Mamba и обрабатывает текст двумя ветвями. Медленная ветвь собирает связи по всему документу, быстрая отслеживает локальные изменения. Результат распределяется между тремя банками памяти: глобальный хранит общую структуру, событийный выделяет заметные переходы, а банк покрытия не даёт потерять спокойные участки текста.
Состояние не привязано напрямую к словарю модели, которая будет отвечать на вопросы. Отдельный Translator переводит его в пространство встраиваний Reader — замороженной LLM, которая читает подготовленный префикс. Для каждого семейства Reader нужен свой Translator, но заново компилировать документы не требуется.
Writer обучают одновременно сохранять геометрию для поиска, находить фрагменты по их положению и восстанавливать текст. Затем его замораживают и отдельно обучают Translator: тот должен направлять Reader к правильному ответу и не позволять модели подменять содержимое документа знаниями из собственных параметров.
Чистый MII передаёт Reader только сжатое состояние. Residual-MII добавляет несколько найденных фрагментов исходного текста: состояние задаёт общую карту документа, а фрагменты возвращают имена, формулировки и другие детали. Именно этот гибрид показал лучший итоговый результат.
Writer обучали на контекстах длиной 12 тысяч токенов. Основные замеры провели с Llama-3-8B на HotpotQA, где полный контекст ограничивали 7 тысячами токенов; перенос на более длинные документы проверяли на наборах LongBench вплоть до 28,4 тысячи токенов. Читаемость одного состояния также испытывали через отдельные Translator для Qwen, Mistral и Llama.
Residual-MII экономит вычисления, но чистое состояние теряет детали
На HotpotQA из 7 405 запросов Residual-MII с плотным поиском получил 46,68% по Exact Match — доле ответов, которые полностью совпали с эталоном. Чтение полного контекста дало 46,39%, тогда как гибрид использовал около 7% операций механизма внимания. Разрыв в качестве невелик, поэтому главный результат здесь — сопоставимый ответ при меньшем объёме обработки на каждый запрос.
Чистый MII уступил и полному контексту, и версии с найденными фрагментами. Сжатое состояние передаёт тему, связи и общий ход рассуждения, но хуже воспроизводит редкие сущности и точные слова. Формат пока работает скорее как плотная карта документа, чем как его самодостаточная замена.
Разбор банков памяти объясняет этот разрыв. Если убрать глобальный банк, модель почти перестаёт понимать документ даже при наличии правильного фрагмента текста. Событийный банк без исходного текста иногда мешает, но в Residual-MII помогает привязать локальные детали к общей структуре.
Поиск и чтение здесь действительно объединены в одном артефакте: его среднее представление можно использовать для маршрутизации, а полное состояние — для ответа. Однако точность обеспечивает двухуровневая схема, где рядом со сжатой памятью остаётся обычный поиск по тексту.
Для продукта это ветка прототипа, а не готовая замена RAG
MII лучше всего соответствует системам, где документы меняются редко, а запросов к ним много. Компиляция выполняется один раз, после чего каждый запрос работает с состоянием фиксированного размера. Выгода сокращается, если документы постоянно переписывают или к каждому обращаются лишь однажды.
Подход также интересен платформам, которые меняют модели или обслуживают несколько семейств LLM. Один документ не нужно пересобирать под каждую модель, но Translator всё равно придётся обучать отдельно. Поэтому заявленная переносимость пока означает общий формат с адаптером, а не файл, который любая LLM прочитает без подготовки.
Исходные документы и поисковый индекс из архитектуры убирать рано. Residual-MII использует текст для точных фактов, а фиксированная ширина состояния одинаково сжимает и насыщенные, и разреженные документы. В предварительном опыте перевод состояния в восьмибитный формат полностью разрушил качество ответов, что добавляет требования к хранению и передаче векторов.
Работа меняет планы на уровне эксперимента: слой компилируемой памяти стоит проверить рядом с существующим RAG, если основную стоимость создаёт повторное чтение длинных документов. Переносить на него весь контур знаний рано — сначала нужно измерить качество на собственных документах, стоимость компиляции и частоту обновлений, а также проверить Translator с выбранными моделями.
Источники
Иллюстрация: рисунок из статьи «Machine-Interpretable Information: Compiling Documents into Searchable and Readable Protocol States», Yifan Wang, Dejing Dou, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


