
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
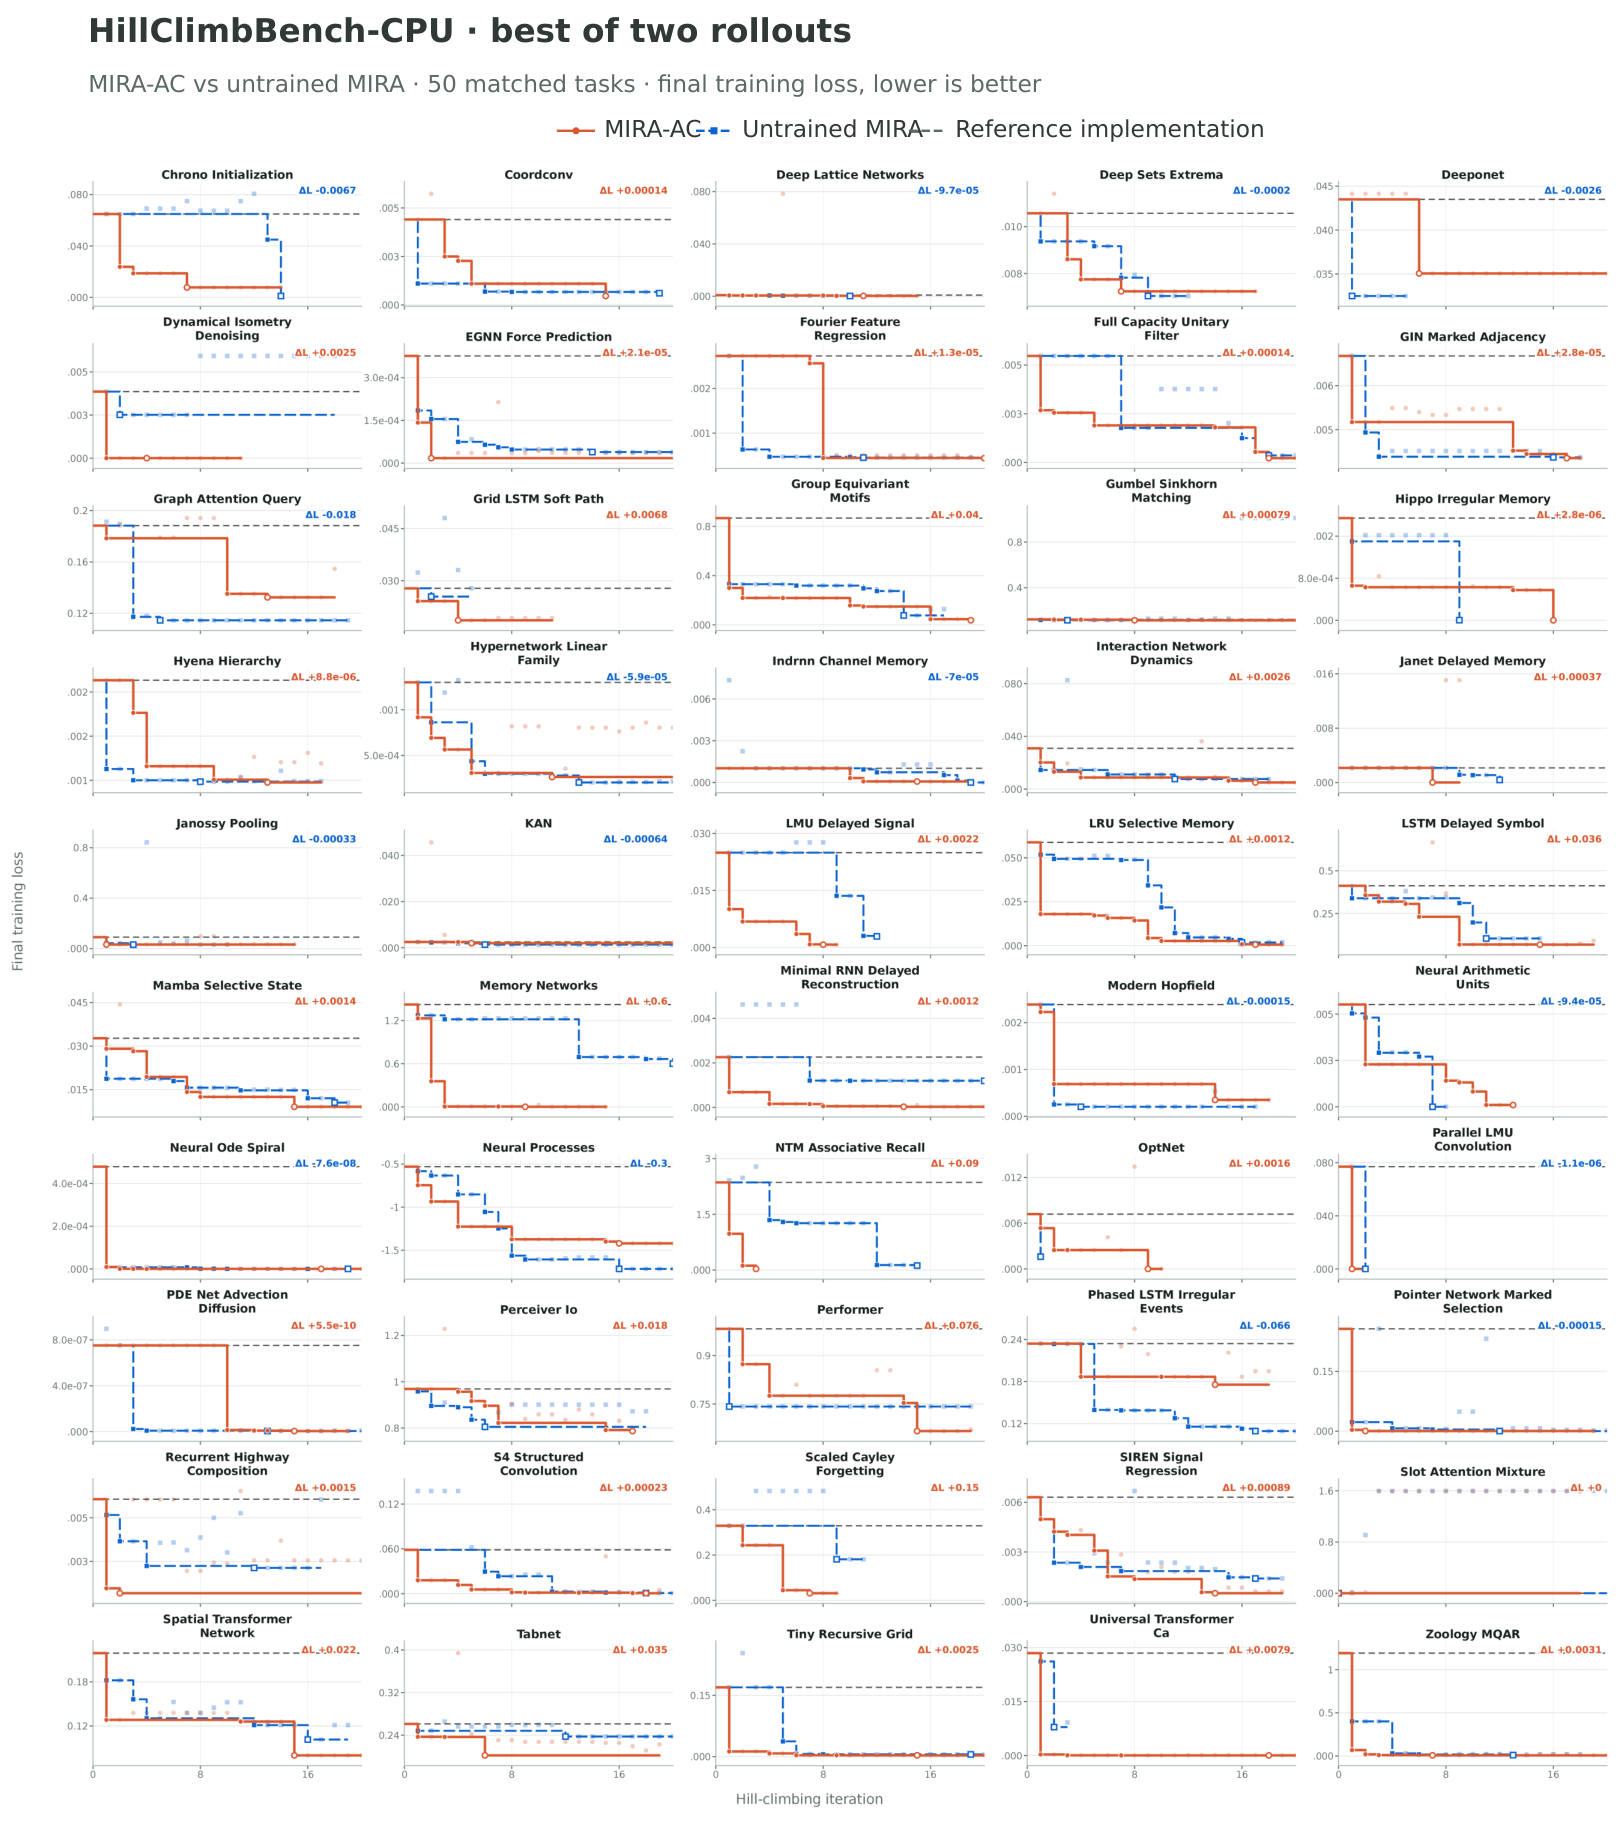
Исследовательского агента научили выбирать следующую проверку по последствиям предыдущих решений, а не просто продолжать длинную цепочку действий. В нерецензированном препринте, где числа получили сами авторы, обученная MIRA-AC показала более низкую минимальную ошибку, чем необученная MIRA, на 33 из 50 задач HillClimbBench-CPU. Для разработчиков агентов это переносит обучение с каждого вызова модели на редкие решения, которые определяют весь дальнейший ход работы.
Планировщик выдаёт задание отдельному исполнителю
MIRA делит исследование на внешний и внутренний контуры. Внешний контур изучает накопленные результаты и решает, что проверять дальше. Он формулирует рабочее задание с целью, способом проверки и критерием успеха либо завершает работу.
Каждое задание получает новый внутренний исполнитель на базе Codex. Он запускает эксперименты, вызывает инструменты, меняет код или доказательство и сохраняет выводы. После этого его контекст удаляется, а следующий исполнитель начинает с нового задания.
Память между такими запусками хранится не в истории диалога, а в постоянном Git-репозитории. Там лежат текущий результат, код, доказательства, отчёты об экспериментах и нерешённые вопросы. Внешний контур собирает из этого хранилища только сведения, нужные для очередного решения.
Так длинная работа исполнителя превращается для планировщика в один переход: было состояние исследования, выдано задание, получен новый результат. Модель не пытается удержать в одном контексте всю историю и не расходует обучение на каждый промежуточный токен или вызов инструмента.
Ценность шага считают по оставшемуся результату
Немедленный результат эксперимента плохо показывает его пользу. Неудачная проверка может исключить ложную гипотезу и открыть дорогу к правильной, а локальное улучшение — завести исследование в тупик. Поэтому MIRA-AC оценивает не сам последний эксперимент, а ожидаемый результат всей оставшейся работы.
Для обучения авторы восстанавливают законченный эпизод и смотрят, какой вклад дали решения внешнего контура. Промежуточная награда растёт, когда агент улучшает лучший найденный результат. Итоговая проверка проходит отдельно и во время исследования агенту недоступна.
Одна модель выполняет две роли. Как оценщик она предсказывает распределение возможного оставшегося результата, используя вероятности следующего токена для набора числовых меток. Как планировщик она выбирает следующую проверку или остановку. Отдельная модель-оценщик не нужна.
Одинаковую оценку пользы получают все токены, из которых состоит решение планировщика: его рассуждение и рабочее задание. Контекстный отбор, действия исполнителя, эксперименты и инструменты напрямую не обучаются. Это сокращает участок траектории, которому нужно назначить отложенную награду.
Оценка на границах между исследованиями оказалась точнее вариантов, которые предсказывали ценность внутри токенов. Предварительное обучение на разных средах также помогло адаптации. В примерах с доказательствами MIRA меняла опровергнутое направление и доходила до полного результата 7/7 там, где обычные запуски GPT-5.5 и Codex оставляли ключевые шаги незавершёнными.
Работа меняет архитектуру агента, но не выбор базовой модели
Практический вывод относится прежде всего к устройству системы. Если задача естественно распадается на проверки, стоит отделить выбор следующей проверки от её исполнения, хранить результаты вне контекста модели и записывать каждое решение как самостоятельное действие. Тогда можно менять исполнителя, не переписывая логику распределения исследовательского бюджета.
Подход особенно подходит задачам, где промежуточный результат можно дешёво измерять: поиску формулы, подбору архитектуры, исправлению причинной сети или автоматизированным экспериментам с кодом. MIRA-AC улучшила итоговые оценки во всех четырёх средах обучения, хотя получала награду от промежуточных метрик. Это показывает, что такая метрика может обучать стратегию, но не гарантирует совпадения с целевым результатом в другой предметной области.
Проверки охватывали доказательство теорем, исследование архитектур нейросетей, символическую регрессию, поиск физических закономерностей и байесовские причинные сети. Во всех средах использовали один внутренний контур на базе Codex. Обучали адаптеры LoRA, а не все параметры модели; эксперименты не охватывали исследования, где одна проверка длится часы или дни.
Поэтому работа пока не обосновывает автономную замену исследовательской команды. Она даёт более узкий инженерный шаблон: сделать решения о направлении работы явными, оценивать их после завершения траектории и обучать именно планировщик. Такой шаблон можно проверить поверх существующего агента раньше, чем вкладываться в обучение его полного цикла действий.
Источники
Иллюстрация: рисунок из статьи «Learning What to Investigate Next: Meta-Reasoning for Long-Horizon Research Agents», Ankur Samanta, Yonathan Efroni, Paul Sajda и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


