
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Система научилась выполнять длинные цепочки действий в Minecraft без экспертной разметки команд и вручную заданной награды. Хотя препринт не рецензирован и числа получили сами авторы, Mirror первой добыла железную кирку в таком режиме. Работа команды MIT показывает, как перенести часть затрат с записи действий эксперта на обычное видео и самостоятельные попытки агента.
Как ошибки превращаются в обучающие примеры
Mirror разделяет агента на видеопланировщик и модель перевода видео в действия. Планировщик получает текущее изображение среды и показывает возможное продолжение: куда повернуть камеру, какой блок разрушить, какой предмет создать. Вторая модель должна подобрать команды, которые приведут к показанному состоянию.
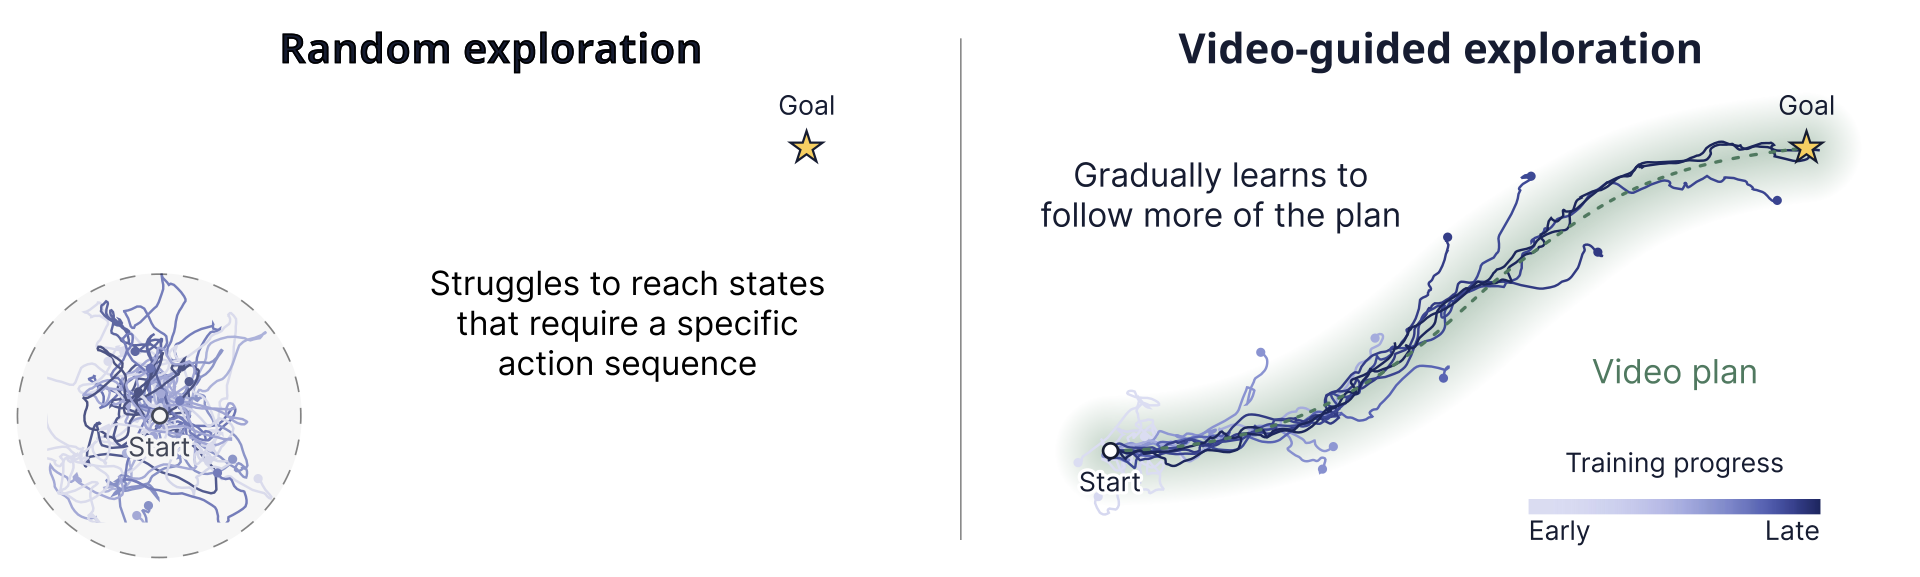
Обычно такую модель обучают на парах «видео — команда»: человек играет или управляет роботом, а система записывает изображение вместе с нажатыми кнопками и движениями. Mirror начинает без такого набора. Агент пытается выполнить видеоплан случайно и собственной пока неточной моделью, а затем сохраняет фактически отправленную команду вместе с получившимся кадром.
Даже неудачная попытка становится корректным примером. Если агент хотел сломать блок, но повернулся в сторону, система учится связывать этот поворот с реальным изменением изображения, а не с желаемым кадром из плана. По мере обучения она точнее повторяет начало плана и добирается до действий, которые раньше не встречала.
Случайность здесь нужна не только для разнообразия данных. Когда агент упирается в незнакомое действие, планировщик продолжает показывать один и тот же следующий переход. Одна из случайных команд со временем приводит к нужному результату, после чего пример попадает в набор обучения и действие перестаёт быть случайной находкой.
Планировщик каждый раз строит продолжение от состояния, в котором агент оказался на самом деле. Поэтому ошибка не заставляет систему следовать уже недействительному ролику: она получает новый маршрут из текущей точки.
Железная кирка стала границей самостоятельного обучения
Для Minecraft использовали адаптированный Cosmos3 с 14 млрд параметров. Его предварительно обучили на 2 946 часах игровых видео, а затем дополнительно настроили для Minecraft survival и задач BASALT. Это важная граница результата: Mirror убирает разметку действий, но не потребность в сильном видеопланировщике и видеоданных.
В BASALT модель перевода видео в команды обучали с нуля на самостоятельной игре. Уже после пяти часов взаимодействия Mirror обходила методы, которым были доступны экспертные действия или заданные разработчиками знания о задаче. Особенно заметно преимущество на длинных заданиях: например, агент должен построить водопад, отойти, выбрать подходящую позицию и сделать снимок.
В режиме выживания самостоятельного улучшения хватило, чтобы получить железную кирку, но не алмазы. В отдельном режиме обучения на готовом наборе с экспертными командами Mirror добывала алмазы почти в восемь раз чаще Dreamer V4. Этот результат нельзя приписывать обучению без разметки: условия двух экспериментов различаются.
Метод также проверили на Atari, OGBench и DeepMind Control. Всего набор охватывал 24 задачи с разными пространствами действий; с генерируемыми видеопланами Mirror обошла основные методы обучения по наблюдениям, а с эталонными планами приблизилась к результатам эксперта.
Некоторые команды нельзя однозначно восстановить по изображению: они не оставляют видимого следа. Проверка охватывает игры и программные среды управления, а самые длинные эпизоды всё ещё требуют отдельного планировщика подзадач. Поэтому перенос на физические системы остаётся следующим этапом, а небольшая доля размеченных действий может понадобиться там, где камера не показывает последствия команды.
Команды могут сократить сбор команд, но не убрать обучение в среде
Mirror меняет архитектурный выбор для продуктов, где агент должен действовать по визуальному примеру. Вместо единой модели, которая одновременно знает задачу, физику среды и команды конкретного устройства, можно вынести общие знания в видеопланировщик. Отдельная модель осваивает только управление данным роботом, симулятором или игрой.
Такой подход особенно полезен, если уже есть много видео выполнения задач, но мало синхронных записей с командами оператора. Видео можно использовать для планировщика, а соответствие между наблюдаемым движением и управлением агент соберёт через собственные действия. При смене устройства потребуется заново освоить команды, но не обязательно заново записывать все процедуры с участием эксперта.
Экономия зависит от цены взаимодействия со средой. В Minecraft неудачная попытка почти ничего не стоит, тогда как видеопланировщик требует крупной модели и длительного предварительного обучения. Работа поэтому не отменяет бюджет на данные и вычисления, а переносит его: меньше размеченных действий человека, больше неразмеченного видео, генерации планов и самостоятельных запусков.
Для текущих проектов вывод практический: не стоит отказываться от разметки команд только на основании этой работы. Mirror уже подтверждает жизнеспособность схемы в программных средах, но её выгоднее рассматривать как способ постепенно уменьшать долю экспертных траекторий. Первый кандидат для проверки — среда, где ошибки обратимы, действия хорошо видны на видео, а агент может многократно повторять попытки.
Источники
Иллюстрация: рисунок из статьи «Self-Improving Video-to-Action Models», Hyunwoo Ryu, Eric Ming Chen, Max Wilcoxson и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


