
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Знания LLM научились обновлять без переобучения базовой модели и без постоянного поиска по внешней базе. Mixture-of-Memories повысила средний результат в проверке фактических ответов до 15,6% относительно замороженной модели, хотя препринт не прошёл рецензирование и все числа получили сами авторы. Архитектура предлагает разделить стабильные знания и факты, которые продуктовая команда добавляет после запуска.
Три вида памяти решают разные задачи
Обычная LLM хранит знания в параметрах, но отдельный факт трудно исправить, не затронув другие ответы. RAG оставляет знания во внешнем хранилище, зато добавляет поиск и обработку найденного текста к каждому запросу. Mixture-of-Memories, или MoM, совмещает оба подхода, но не отправляет все токены по одному пути.
Основа MoM — замороженная языковая модель. Рядом с ней работают две обучаемые памяти. Скрытая память LatM получает внутреннее представление модели и вносит быструю поправку в вероятности следующего токена. Её заранее учат воспроизводить поправки, которые дал бы поиск по базе, поэтому во время ответа искать ближайшие записи уже не нужно.
Лексическая память LexM работает с последовательностью токенов и сама выдаёт распределение вероятностей. Она меньше зависит от устройства внутренних представлений конкретной модели, чем LatM, и дополняет её там, где одной скрытой поправки недостаточно.
Маршрутизатор на каждом шаге смешивает базовую модель, LatM и LexM. Он смотрит, насколько базовая модель уверена в следующем токене и насколько три источника расходятся. Поэтому синтаксис и распространённые слова может оставить базовой модели, а для имени, даты или другого фактического фрагмента сильнее подключить дополнительную память.
Изменяемые факты вынесены в отдельную память ExpM. Она хранит пары из вопроса и ответа, один раз ищет подходящую запись перед генерацией и передаёт её классификатору. Если тот принимает найденный факт, система копирует сохранённый ответ; если отклоняет, отвечает основной контур.
ExpM намеренно не входит в маршрутизатор. Когда маршрутизатор обучают с пустым или почти пустым хранилищем, он привыкает давать ему малый вес. Отдельное решение на уровне всего ответа позволяет записанному позже факту сработать сразу, без повторного обучения остальных компонентов.
Записанные факты сработали почти без побочных изменений
MoM проверили на Mistral-7B-v0.3 и Llama-3.1-8B в задачах NQ, WebQuestions, TriviaQA, TruthfulQA и HotpotQA. Для отдельного опыта с языковым моделированием использовали GPT2-large и WikiText-103. Сравнение охватывало замороженные модели, продолженное обучение, LoRA, параметрическую память, RAG и kNN-LM.
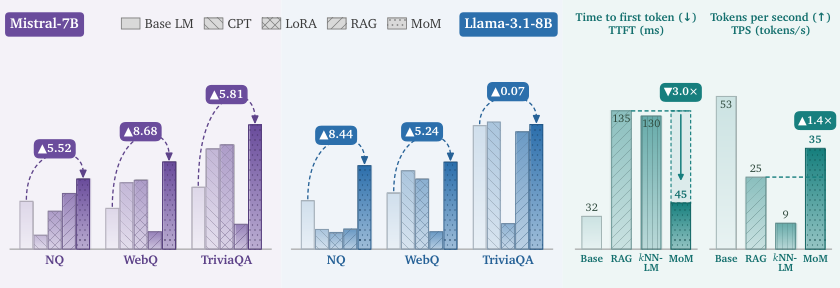
MoM показала лучший средний результат на обеих основных моделях и не ухудшила ни один из пяти наборов относительно исходной LLM. Другие подходы иногда выигрывали на отдельной задаче, но почти каждый из них одновременно снижал качество хотя бы на одной другой.
Проверка обновлений была намеренно узкой: в пустое хранилище записали ответы, которые основной контур раньше не знал, а затем задали те же вопросы. Доля полностью совпавших ответов поднялась до 99,5–100%. Среди 400 ранее правильных ответов после записи посторонних фактов изменился только один.
На сервере с моделью сопоставимого размера время до первого токена оказалось в 2,9–3,0 раза меньше, чем у RAG и kNN-LM. MoM не устраняет вычислительные расходы: она запускает дополнительные нейронные модули, поэтому уступает замороженной базовой модели. Выигрыш возникает относительно систем, которые ищут документы или соседние записи во время каждого ответа.
Архитектура меняет план обновлений, но не отменяет RAG
Работа предлагает полезное разделение для продуктов, где большая часть знаний стабильна, а исправлять нужно ограниченный набор фактов. Стабильный корпус можно один раз перенести в нейронные памяти, а цены, статусы, правила или исправления держать во внешнем записываемом слое. Тогда точечное обновление сводится к добавлению записи, а не к новому обучению модели.
Цена такого устройства переносится на подготовку. Полный цикл обучения компонентов занял около 1800 GPU-часов на восьми H200. Это не готовая замена RAG для команды, которой нужно подключить документы без обучения собственных модулей, а отдельная архитектура для систем с большим и предсказуемым потоком запросов.
Проверка записываемой памяти также соответствует точечным исправлениям, а не поиску по большой корпоративной базе. Она выбирает один факт на вопрос, а чтение новых записей проверяли на тех же формулировках, с которыми их добавляли. По мере роста хранилища больше записей будут конкурировать между собой, и ошибочный факт может пройти через классификатор.
Для команд, которые только выбирают архитектуру, практический вывод состоит не в отказе от RAG, а в разделении каналов знаний. Документы, требующие многошагового поиска и объединения источников, по-прежнему соответствуют RAG. Частые запросы к стабильному корпусу и небольшой управляемый слой исправлений могут выиграть от схемы MoM, если затраты на обучение окупаются меньшей задержкой при работе.
Источники
Иллюстрация: рисунок из статьи «Mixture-of-Memories: Low-Overhead Language Modeling with Modular Knowledge Injection», Yifan Lu, Rubin Wei, Ziyun Zou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


