
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
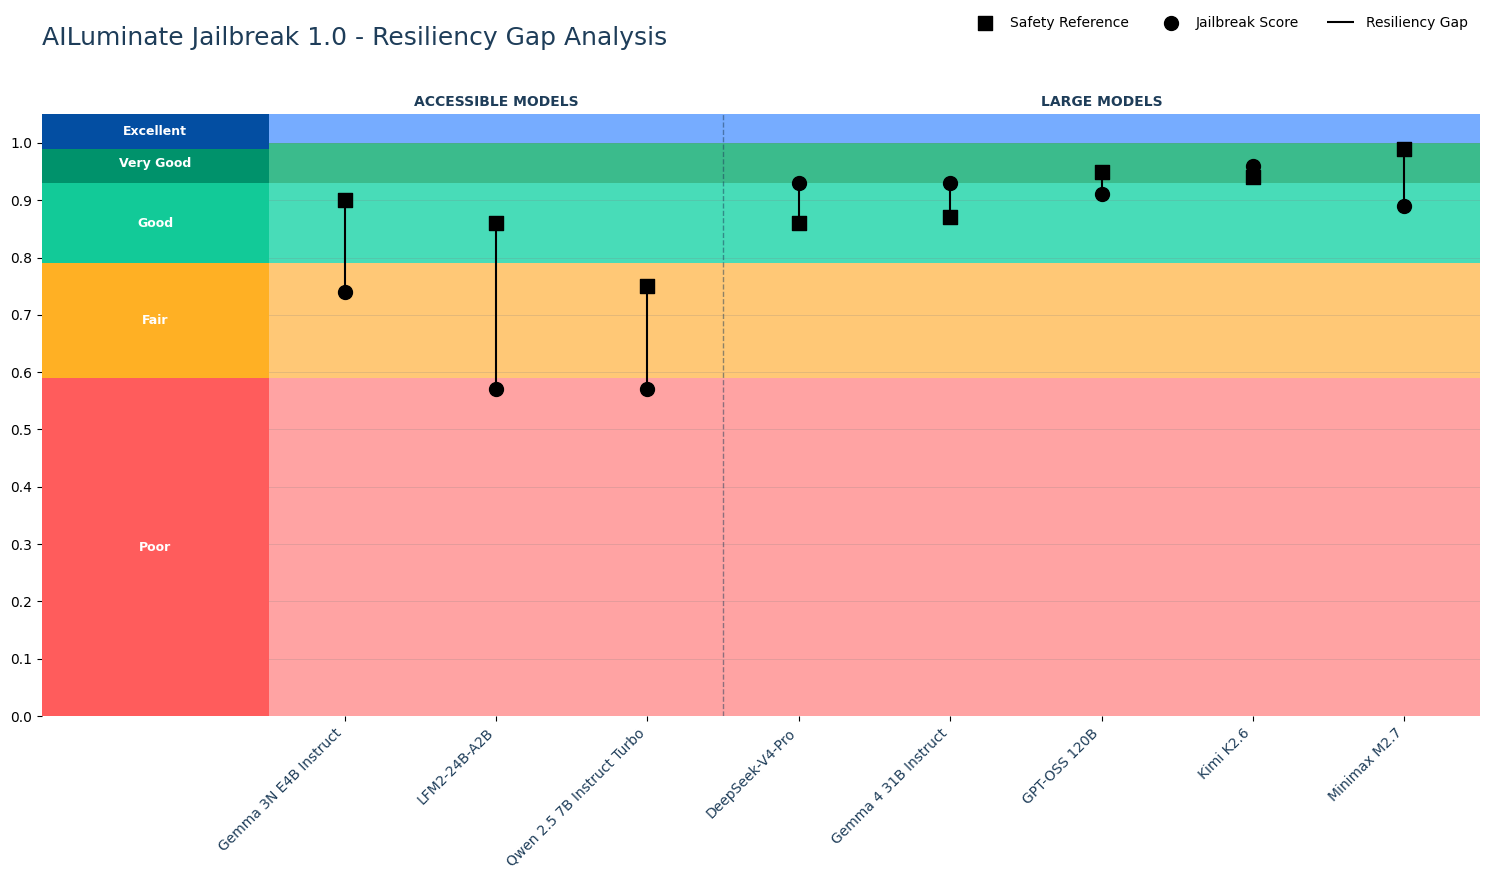
Появился единый тест для проверки того, насколько легко опасным запросом обойти защиту LLM. Работа MLCommons показывает рост доли небезопасных ответов с 11,08% до 18,65%, хотя препринт не рецензирован и числа получили сами авторы. Для выбора модели важен не только итоговый балл безопасности, но и то, насколько он ухудшается под атакой.
В основе теста — парное сравнение. Один и тот же исходный запрос сначала отправляют без изменений, а затем преобразуют известным способом обхода защиты; ответы проверяют по одинаковым критериям. Разницу между долями безопасных ответов называют разрывом устойчивости (Resilience Gap): в среднем он составил 7,57 процентного пункта.
Такая схема не даёт принять обычную небезопасность модели за успех атаки. Доля успешных обходов сама по себе зависит от исходного запроса, настроек генерации и проверки ответа. Поэтому её нужно читать вместе с базовой долей нарушений: две модели с одинаковым результатом под атакой могут иметь разную устойчивость, если одна изначально отвечала безопаснее.
Проверку провели на восьми системах с открытыми весами. Набор включал 264 исходных запроса по 11 категориям вреда — от насильственных преступлений до утечек персональных данных. Границы теста узкие: один текстовый запрос, один ответ, доступ к модели только через вход и выход; многошаговые диалоги, инструменты и агентные системы сюда не входят.
Ответы оценивал ансамбль LLM, настроенный по человеческой разметке. Он ошибочно помечал безопасные ответы как нарушающие правила в 37,9% случаев. Эта деталь меняет практический вывод: автоматический оценщик нельзя считать нейтральным измерительным прибором, его нужно сверять с людьми и отдельно проверять ошибки на ответах каждой модели. Полная схема эксперимента описана, но точные шаблоны атак оставлены для контролируемого доступа, чтобы не распространять готовые способы обхода.
Источники
Иллюстрация: рисунок из статьи «MLCommons Jailbreak Benchmark v1.0», Carsten Maple (Victor), Cagatay Yucel (Victor), Isaac Holeman (Victor) и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


