
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
ML-агента научили выбирать диагностический инструмент по ситуации и использовать результат при следующем изменении кода. Хотя препринт не рецензирован и числа получили сами авторы, успешность Qwen3.5-35B-A3B на знакомом типе задач выросла с 35,6% до 69,2%. Для команд, которые строят агентов для ML-разработки, результат разделяет два решения: дать модели инструменты и отдельно научить её понимать, когда они нужны.
Доступ к диагностике ещё не учит ставить диагноз
ML-агент может редактировать код, запускать обучение и видеть итоговую метрику, но этого недостаточно для выбора следующего шага. Например, он может заменить архитектуру до проверки масштаба признаков или принять улучшение на несбалансированной выборке, не сравнив результат с простым базовым вариантом.
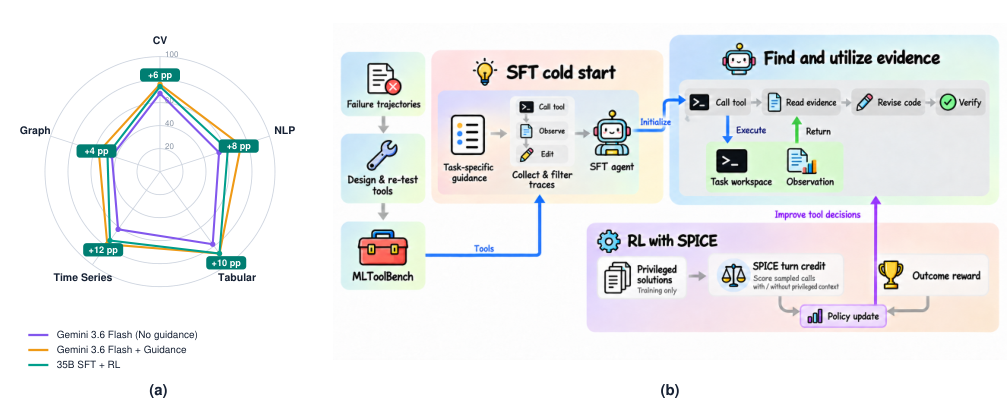
MLToolBench добавляет 67 исполняемых инструментов для проверки данных, кода и экспериментов. Они находят пропуски и дисбаланс классов, проверяют формы тензоров и конфигурации, извлекают метрики, анализируют ход обучения и выявляют плато. Набор охватывает табличные данные, временные ряды, тексты, изображения и графы.
Инструменты собрали из повторяющихся ошибок агентов. Для каждого сбоя команда проектировала проверку, заново запускала исходную задачу и оставляла инструмент, если он помогал устранить проблему. Поэтому библиотека отражает реальные точки отказа внутри экспериментальной среды, а не произвольный каталог функций.
Простое описание интерфейсов почти не помогло моделям без специального обучения. У нескольких базовых моделей добавление диагностики даже снизило долю успешных запусков: дополнительные действия расширили пространство выбора, но не объяснили, какую проверку связать с какой правкой.
SPICE оценивает вызов до того, как известен итог
Обучение проходит в два этапа. Сначала Gemini 3.6 Flash получает подсказку о стратегии исследования и создаёт демонстрации: вызывает инструмент, читает наблюдение и выбирает действие. Затем подсказку удаляют, а Qwen дообучают на сохранённых взаимодействиях, чтобы модель усвоила связь между проверкой и решением.
После этого агент учится с подкреплением на новых запусках. Обычная итоговая награда здесь даёт слабый сигнал: если рабочее решение появилось через несколько шагов после проверки данных, по одному финальному успеху нельзя понять, заслуживал ли ранний вызов инструмента поощрения.
SPICE присваивает отдельную награду каждому такому вызову. Замороженная копия модели оценивает одно и то же выбранное действие дважды: с обычной историей и с добавленным кратким описанием проверенного решения. Если описание делает вызов вероятнее, действие получает положительный сигнал; если менее вероятным — отрицательный.
Текущий ответ инструмента и будущие шаги при этой оценке не используются. Сам агент также не видит проверенное решение ни во время взаимодействия, ни на итоговой проверке. Привилегированный контекст нужен только внешнему оценщику, который дополняет финальную награду сигналом на уровне отдельного шага.
Такой сигнал не доказывает, что конкретный вызов причинил успех. Он отвечает на более узкий вопрос: согласуется ли выбранная проверка с известным рабочим решением в текущем состоянии задачи. Контроль с перемешанными наградами показал, что соответствие между действием и сигналом влияет на результат, но не подтвердил причинную связь.
Планы стоит менять, если агент уже работает в проверяемом контуре
На задачах с удержанными источниками данных или целями успешность Qwen3.5-35B-A3B выросла с 31% до 48%. Значит, агент не только запомнил вызовы для знакомых шаблонов: часть поведения перенеслась на изменившиеся условия внутри того же набора областей.
Практический вывод — не начинать с расширения списка API. Если агент уже запускает эксперименты и получает машинно проверяемый итог, полезнее сначала выделить повторяющиеся ошибки, превратить нужные проверки в явные действия и собрать траектории, где наблюдение меняет последующее решение. Иначе новые инструменты могут лишь добавить неудачные ветви.
SPICE подходит не каждому контуру. Для него нужны проверенные решения или их краткие описания, а каждый вызов требует дополнительных проходов модели-оценщика. Это увеличивает вычислительную стоимость обучения, хотя при исполнении агент работает без привилегированного контекста.
Границы результата заданы самим экспериментом: обучение шло на синтетических задачах, а итоговую проверку провели на 35 удержанных задачах из тех же пяти областей. Перенос на естественные ML-проекты не проверяли; повторы измеряли поведение фиксированных контрольных точек моделей, а не устойчивость между независимыми запусками обучения. Поэтому работа даёт схему для пилота, но пока не основание менять производственный контур целиком.
Источники
Иллюстрация: рисунок из статьи «MLToolBench: Learning Tool-Augmented Agents for Machine Learning Development», Xin Yu, Lizhu Zhang, Jiamu Bai и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


