
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну LLM научили переключаться между обычным ответом и набором содержательно разных вариантов без ручных персонажей. На тестах MoDA обошла DivPO и по разнообразию, и по средней точности первого ответа, хотя препринт не рецензирован и все числа получили сами авторы. Для продукта разнообразие становится отдельным режимом модели, но ради него придётся постобучать веса и проверять несколько кандидатов.
Как нумерованные роли разводят ответы по разным направлениям
Обычное постобучение закрепляет ответы, которые чаще получают высокую награду. Со временем модель выбирает несколько безопасных формулировок и реже исследует другие допустимые варианты. Для фактических запросов это обычно не мешает, но сужает поиск гипотез, идей и сюжетов.
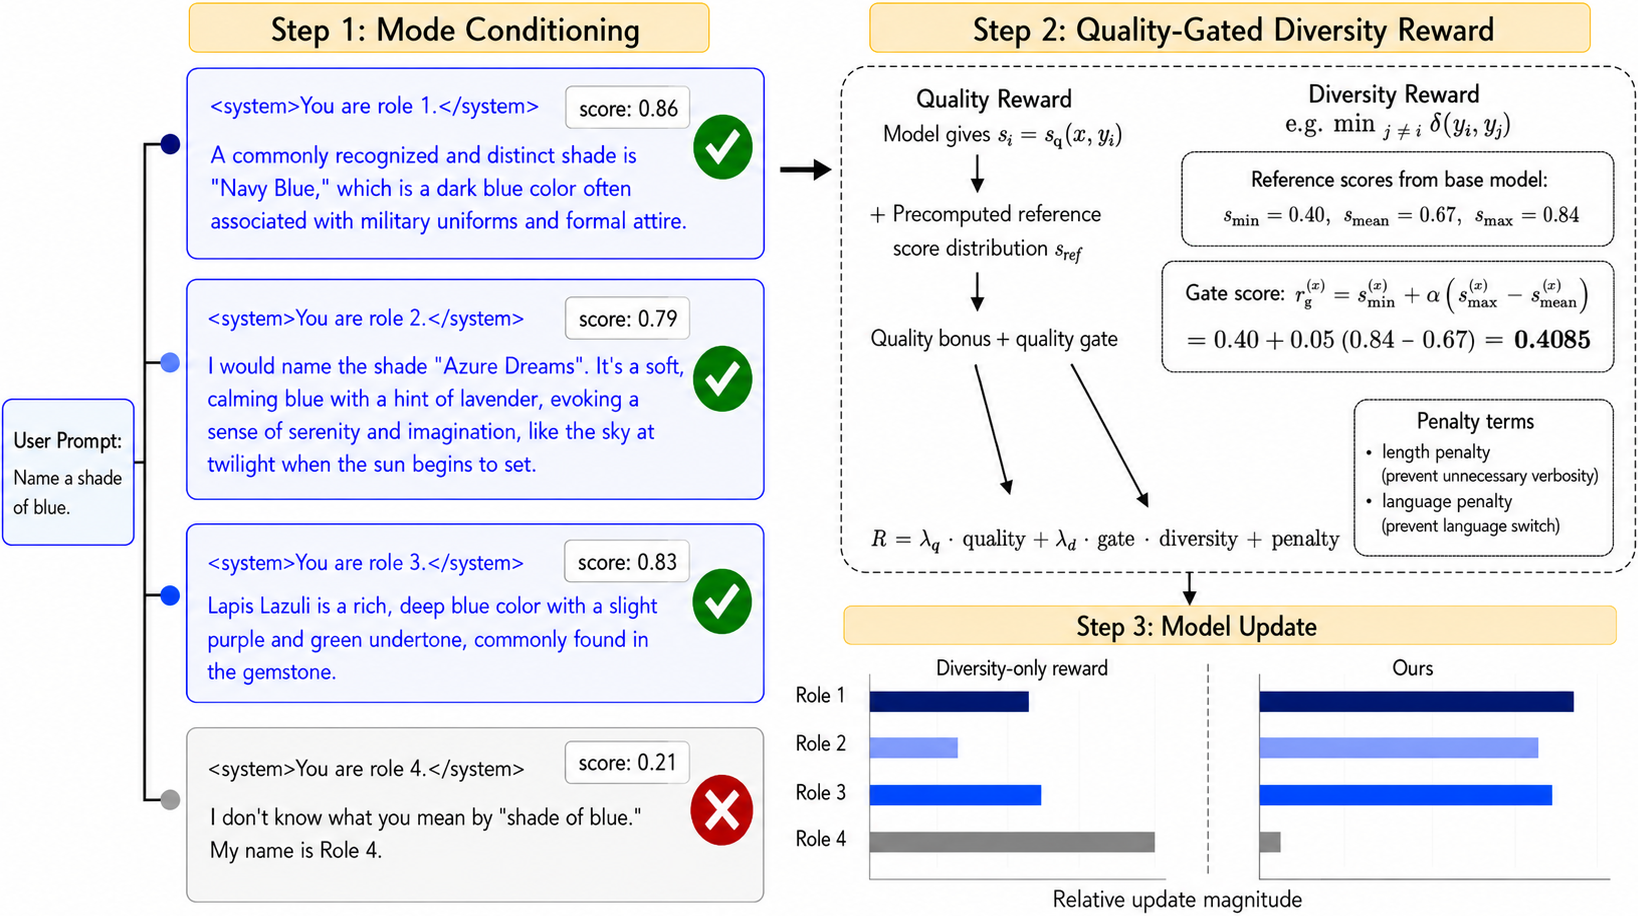
MoDA добавляет в системную инструкцию абстрактный идентификатор: «You are role i». Для одного запроса каждая роль генерирует свой ответ, но все роли используют одну модель и общие параметры. Персонажи вроде «изобретательный учёный» или «методичный преподаватель» не нужны: специализацию модель находит во время обучения.
Алгоритм сравнивает ответ каждой роли с ближайшим к нему кандидатом по смыслу. Чем сильнее они различаются, тем выше награда за разнообразие. Затем GRPO, алгоритм обучения с подкреплением по относительным результатам группы, повышает вероятность удачных ответов и подавляет повторяющиеся.
Роли нужны и после обучения. Если передать несколько идентификаторов, модель вернёт набор вариантов. Если убрать их, она работает в стандартном режиме и выдаёт один ответ. Кандидатов можно показать вместе, ранжировать отдельной моделью или собрать из них итоговый ответ.
Фильтр качества не даёт модели выигрывать за счёт странностей
Награда только за различие создаёт простой обход: модель может сменить язык, растянуть текст или уйти от темы. MoDA сначала пропускает ответ через фильтр качества. Порог рассчитывается отдельно для каждого запроса по ответам замороженной исходной модели, поэтому сложные и простые задания не обязаны проходить одну границу.
Ответ ниже порога не получает награду за разнообразие, даже если он не похож на остальные. Дополнительные штрафы учитывают неверный язык, лишнюю длину и нарушения формата. В разборе вариантов метод без фильтра давал больше различий, но качество ответов в режиме ролей разрушалось.
В наглядном примере MoDA назвала 40 разных оттенков синего среди 100 ответов — больше исходной модели и метода SSoT. На Infinite-Chat семантическое разнообразие SBERT выросло на 76% относительно DivPO, а средний pass@1 на общих задачах оказался выше на 7 процентных пунктов. SBERT здесь показывает, насколько ответы различаются по смыслу, а pass@1 — долю заданий, где первый ответ оказался правильным.
Фильтр не устраняет зависимость от модели-оценщика. Она поощряла многословие, поэтому модель научилась добавлять ненужные вступления вроде «As a model…». На NoveltyBench удаление таких фраз повысило оценку качества на 20% — разнообразие тоже можно оптимизировать формально правильно, но не так, как нужно продукту.
Когда MoDA меняет планы разработки
Метод касается продуктов, где несколько правдоподобных направлений полезнее одного усреднённого ответа: генераторов научных гипотез, творческих помощников и агентов, которые перебирают стратегии. Нумерованные роли снимают необходимость поддерживать библиотеку персонажей и позволяют обучать специализации вместе с моделью.
Для поиска одного факта или выполнения инструкции разнообразный режим добавит несколько генераций и последующий отбор без очевидной пользы. Команда может оставить стандартный режим для таких запросов и включать роли только там, где нужен набор кандидатов. Это удобнее, чем постоянно повышать случайность генерации для всего трафика.
Архитектуру LLM менять не требуется, но «подключаемой» на уровне одного запроса MoDA не становится. Нужны собственное постобучение с подкреплением, замороженная исходная модель, модель-оценщик и набор штрафов. Если продукт использует только внешний API без доступа к весам, воспроизвести метод как часть модели не получится.
Эксперименты охватывают Qwen3-8B, Llama-3.1-8B и GLM-4-9B. Общие способности проверяли на задачах с правильным ответом и выполнением инструкций, разнообразие — на научных идеях и творческом письме, включая HypoBench, PreScience, NoveltyBench и Infinite-Chat. Сравнения включали исходные модели, DivPO, подсказки с ролями и варианты обучения только на качестве или только на разнообразии.
Практический вывод не в том, чтобы заменить текущую модель на MoDA. Работа предлагает схему для следующего цикла постобучения, если продукт уже генерирует несколько решений и страдает от повторов. Перед внедрением придётся отдельно проверить модель-оценщик на многословие, смену языка и специфические для предметной области ошибки.
Источники
Иллюстрация: рисунок из статьи «Forty Shades of Blue: Quality-Diversity Alignment via Mode-Conditioned Reinforcement Learning», Jiayi Yuan, Hangoo Kang, James Jihao Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


