
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Мультимодальную модель научили по ходу ответа самой выбирать между текстовым поиском, поиском изображений и обратным поиском по картинке. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, ModalSearcher-8B обошёл Qwen3-VL-8B в среднем на 16,2 процентного пункта. Для поисковых агентов это меняет архитектуру: изображение становится не только входными данными, но и инструментом, который модель вызывает при нехватке визуальных свидетельств.
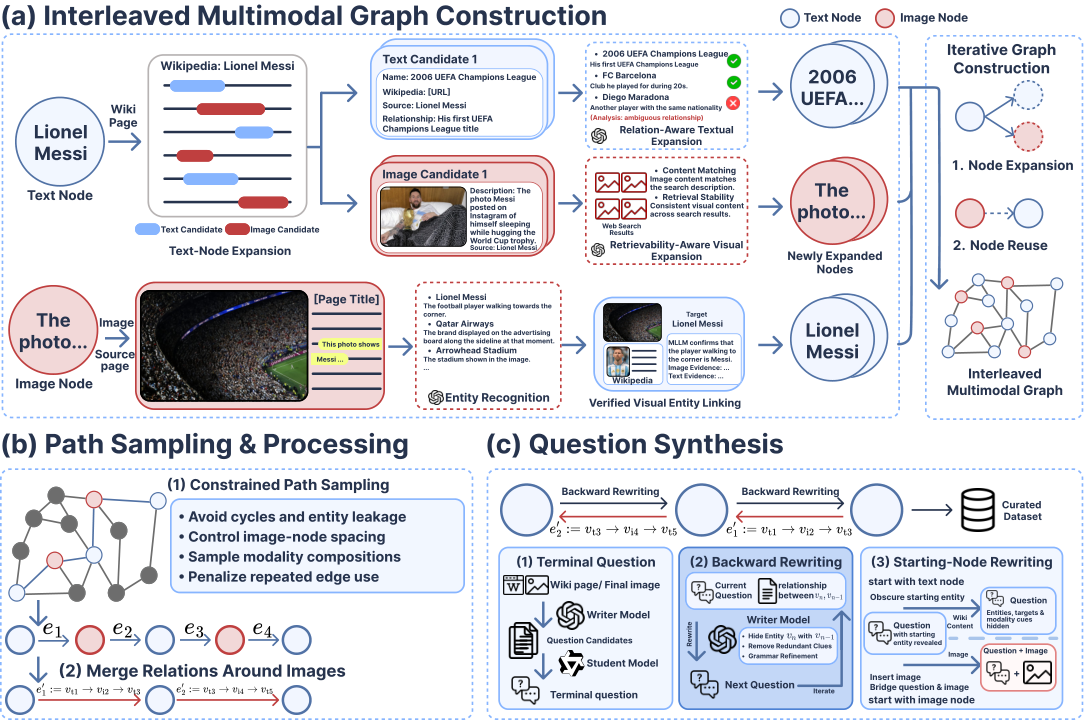
Данные для обучения собрали через граф, где текстовые сущности связаны с другими сущностями и изображениями. Из графа выбирали цепочки с разным порядком текстовых и визуальных шагов, а затем переписывали вопросы с конца к началу: скрывали имена и цели поиска, но сохраняли подсказки, необходимые для однозначного ответа. Поэтому вопрос не сообщает модели, когда нужно искать картинку.
ModalSearcher-8B обучали в два этапа. Сначала модель осваивала работу с инструментами на готовых траекториях, затем обучение с подкреплением корректировало многошаговые решения в реальном веб-поиске. Во время ответа граф ей недоступен: агент видит только найденные материалы и решает, продолжать рассуждение, открыть страницу или вызвать один из видов поиска.
Средний результат на пяти наборах мультимодальных вопросов составил 57,0 балла. Рост сохранился на отдельно созданных VisBrowse и BrowseComp-V3, где нужно активно находить новые изображения. Когда у ModalSearcher убрали оба визуальных инструмента, точность на проверках с активным поиском упала до 12,5 процентного пункта — значит, прибавку дал не только формат обучающих вопросов.
Собственный ModalSearch-Bench включает 300 проверенных экспертами заданий: часть решается по исходному изображению, часть требует найти новое. Его построили тем же конвейером, что и обучающие данные, но на отдельном графе; перенос дополнительно проверяли на внешних наборах. Для разработки такого агента недостаточно подключить поиск картинок к API: нужны обучающие траектории, где модель сама обнаруживает нехватку визуальных данных и выбирает подходящий инструмент.
Источники
Иллюстрация: рисунок из статьи «ModalSearcher: Weaving Visual Evidence into Autonomous Cross-Modal Deep Search», Zhihan Yin, Ruyi Li, Chengyu Fang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


