
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
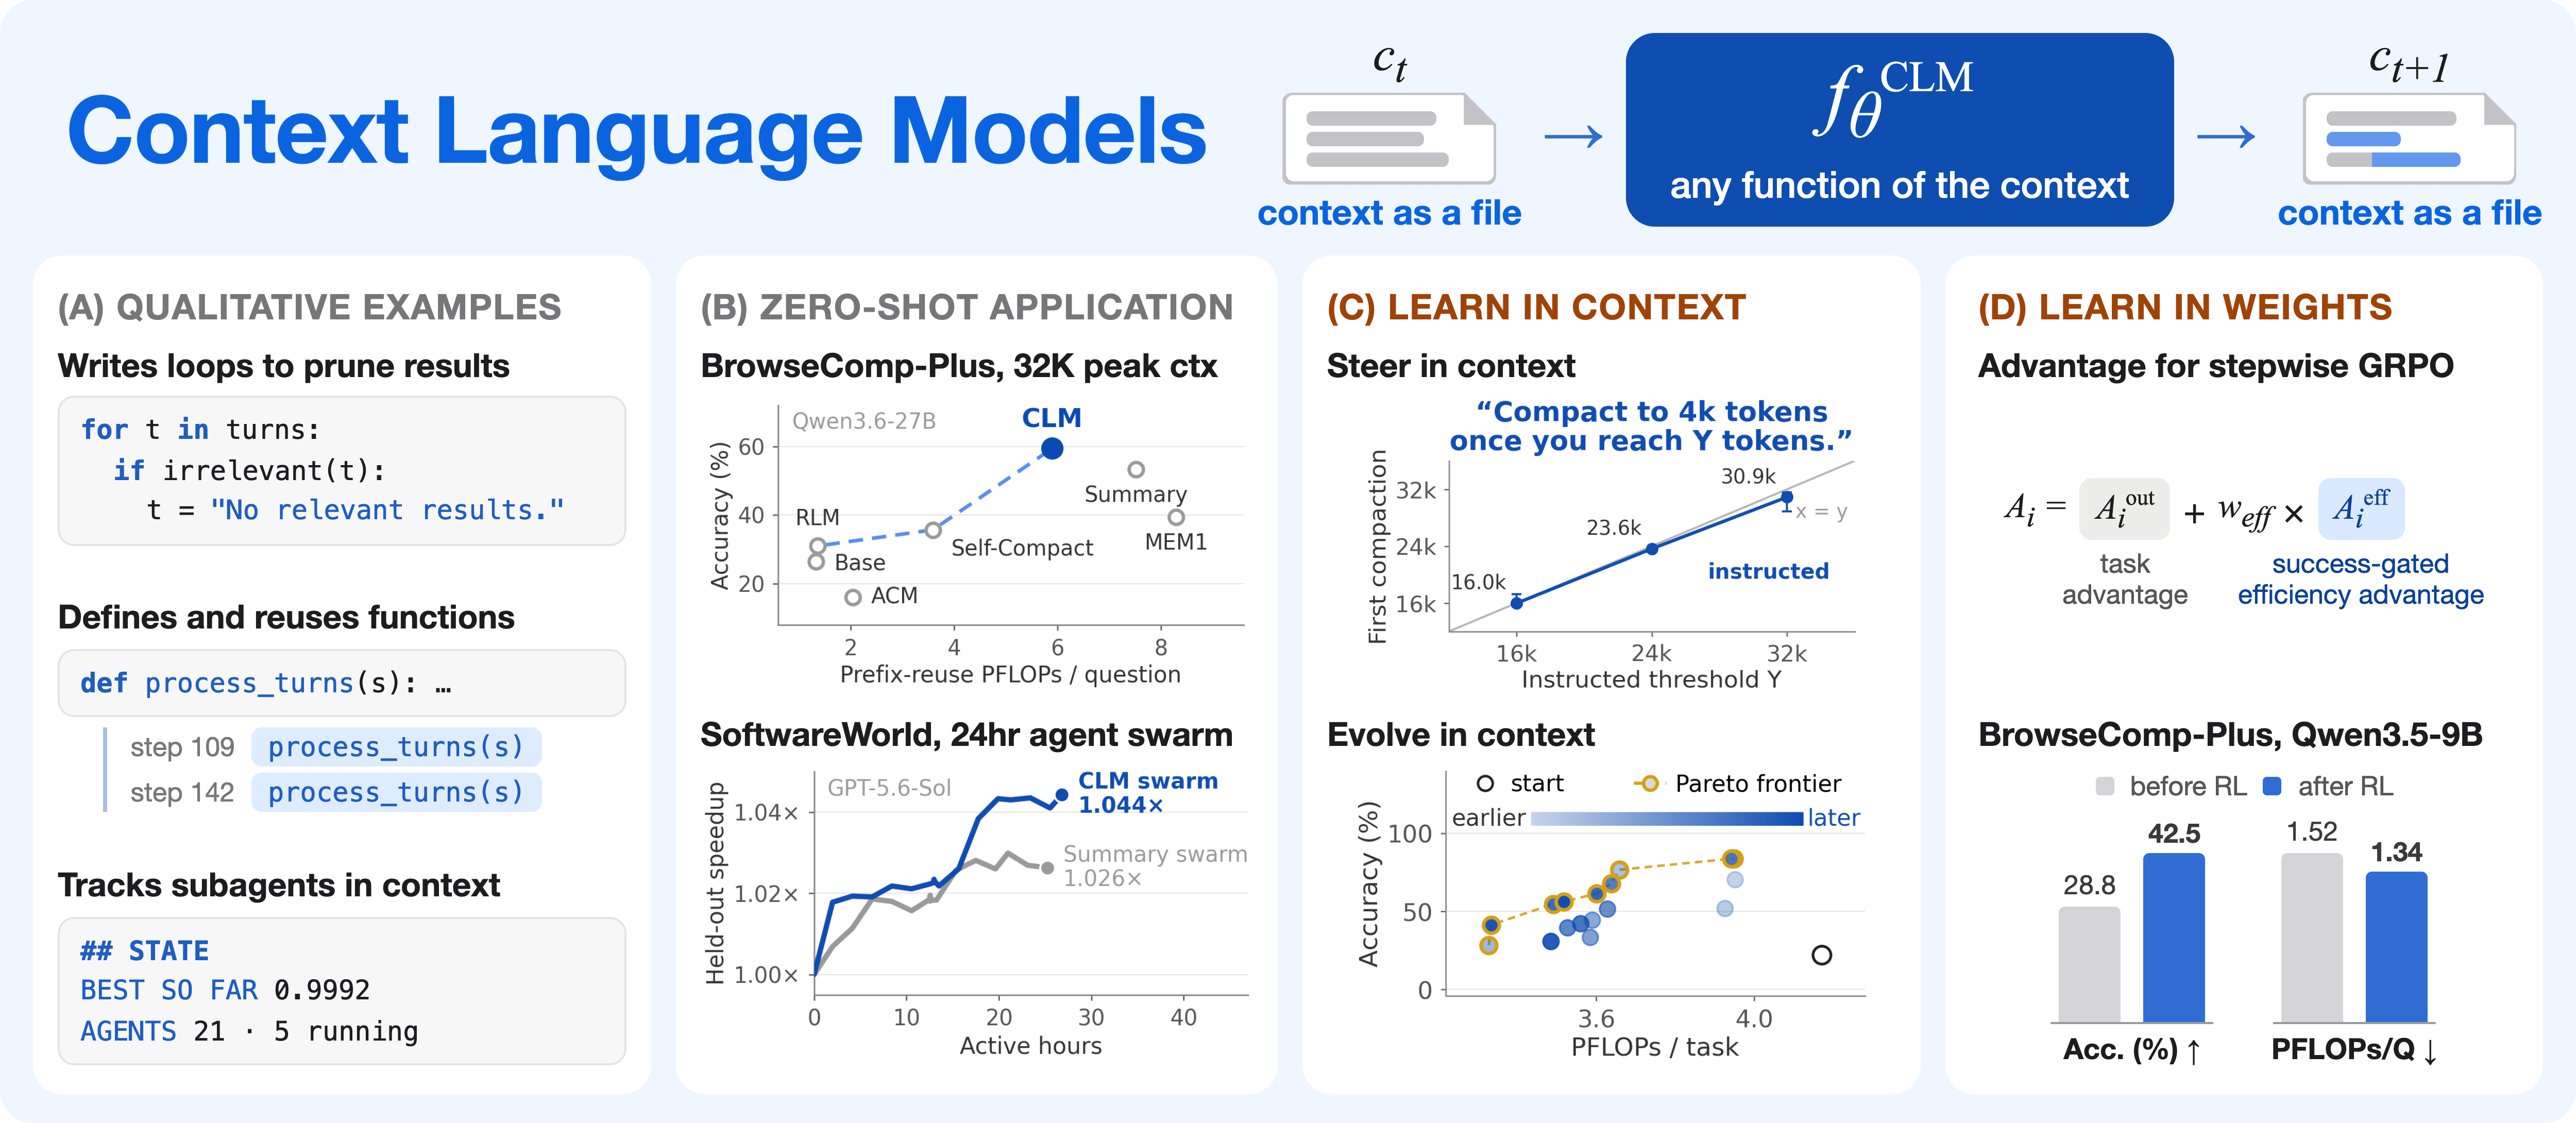
Языковой модели дали самой решать, что хранить в контексте, а что удалять или сжимать по ходу работы. В нерецензированном препринте команды University of Washington, Meta Superintelligence Labs, MIT и Trillium Labs числа получили сами авторы: на BrowseComp-Plus подход показал точность на 11,4% выше при сокращении вычислений на 21,5% относительно сильнейшей альтернативы. Для разработчиков агентов это переносит управление памятью из внешней обвязки в поведение модели.
Контекст становится редактируемым файлом
Обычная LLM дописывает каждый новый ответ в конец истории. Когда история перестаёт помещаться, внешняя обвязка запускает заранее заданную операцию: делает сводку, выгружает часть данных в хранилище или заново находит нужные фрагменты.
Context Language Model получает другой интерфейс. Система зеркалирует текущий контекст в файл, сообщает модели путь к нему и разрешает редактировать его командами Bash. Изменения сразу попадают в живой контекст следующего вызова.
Модель может оставить историю как есть, заменить несколько старых сообщений краткой записью, удалить неудачные результаты поиска или обновить таблицу состояния на месте. В многоагентной системе каждому агенту соответствует отдельный файл, поэтому координатор может создавать, менять и удалять контексты подчинённых агентов тем же способом.
Это не новая архитектура нейросети. Подход меняет протокол выполнения: вместо набора разрешённых операций модель получает общий механизм редактирования и сама вырабатывает стратегию. В экспериментах она заводила внутренние заметки, поддерживала списки работающих агентов и писала функции, которые многократно сжимали старые результаты.
Для отдельной проверки управления памятью создали ContextBench. В него входят сохранение точных фрагментов, пошаговое обновление Sudoku, работа с хранилищем ключей и значений и разбор журналов. При бюджете контекста 32K тест отделяет ошибки памяти от нехватки знаний или способности рассуждать.
Редактирование окупает повторную обработку контекста
Изменение середины истории мешает обычному кэшу префикса. Сервер может повторно использовать вычисления только до первого изменённого токена, а оставшуюся часть контекста должен обработать заново. Поэтому работа считает не только длину запросов, но и число операций с плавающей точкой (FLOPs) с учётом повторной обработки.
На EdgeBench, где агент долго оптимизирует программные проекты, CLM набрал на 5% больше баллов и использовал на 59% меньше вычислений, чем вариант со сводками в стиле Codex. В задаче, где группа агентов совместно меняла несколько связанных репозиториев, итоговое ускорение оказалось на 65% выше при одинаковом вычислительном бюджете.
Дополнительный метод Suffix Cache Reuse повторно использует кэш для сохранившихся фрагментов после места редактирования. В сочетании с CLM он сократил серверные вычисления на 35% относительно стандартного обслуживания через SGLang без заметной разницы в качестве.
Проверки охватывают семейства Qwen и GPT, глубокий поиск, терминальное программирование, математическую оптимизацию и многочасовую работу агентов. Результаты относятся к длинным траекториям из сотен или тысяч шагов, где история действительно становится вычислительным ограничением.
Менять обвязку стоит сначала в длинных процессах
Работа не делает внешнюю обвязку ненужной. Она предлагает сузить её роль: инфраструктура синхронизирует файл, вызывает инструменты и контролирует ресурсы, а модель решает, какие сведения сохранить. Такой прототип имеет смысл рядом с существующей стратегией сводок, чтобы сравнить качество и фактические вычисления на собственных задачах.
Для коротких независимых запросов результаты не меняют архитектурный выбор: эксперименты проверяют агентов, которые долго исследуют, пишут код или координируют другие модели. Наибольший потенциальный выигрыш получат процессы, где контекст многократно переполняется, а фиксированная сводка теряет важные факты.
Стратегию можно не только задавать инструкцией, но и обучать. После обучения с подкреплением Qwen улучшила результат на BrowseComp-Plus на 13,7 процентного пункта; сигнал награды учитывал эффективность только среди успешных траекторий, чтобы модель не удаляла контекст ради формальной экономии.
При внедрении придётся учитывать два инженерных риска. Стандартный сервер может потратить сэкономленные токены на повторную обработку изменённой истории, поэтому измерять нужно вычисления всей траектории. Кроме того, редактируемый контекст создаёт канал для закрепления вредоносных или самостоятельно сгенерированных инструкций, а значит, файл нельзя считать доверенным состоянием процесса.
Практический сдвиг состоит не в замене одной сводки другой. Команда получает обучаемый слой управления памятью, но вместе с ним должна проектировать кэширование и защиту контекста как части агентной системы.
Источники
Иллюстрация: рисунок из статьи «Context Language Models», Rulin Shao, Shannon Zejiang Shen, Junjie Oscar Yin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


