
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Мультимодальную модель вознаграждения научили обучать без размеченных людьми пар предпочтений. Хотя препринт команды MIT, Cornell, Scale AI и Harvard не рецензирован и все числа получили сами авторы, версия на базе Qwen3-VL-32B сравнялась с GPT-4o или обошла его на трёх бенчмарках, включая преимущество в 6,6 процентного пункта на VL-RewardBench. Это даёт дешёвый способ собрать оценщик, но высокий результат на бенчмарке ещё не означает, что он выберет лучший ответ конкретного продукта.
Оценка берётся из промежуточного слоя замороженной модели
Модель вознаграждения получает изображение, запрос и ответ, а затем выдаёт одно число: чем оно выше, тем предпочтительнее ответ. Вместо дообучения всей зрительно-языковой модели авторы заморозили Qwen3-VL и добавили линейный выходной слой к её внутренним представлениям.
Для каждого ответа система усредняет состояния его токенов в выбранном слое Qwen3-VL. Линейный слой учится ставить настоящую подпись к изображению выше её испорченной версии. У варианта на базе Qwen3-VL-2B обучаются только 2 048 параметров, а вычислительные затраты составляют примерно одну тысячную от полного дообучения основы.
Ключевой выбор здесь — глубина, с которой берутся признаки. Последний слой оказался хуже промежуточного на 5,8 процентного пункта. Оптимальная глубина зависела от основы: её отдельно искали для моделей семейства Qwen3-VL и GLM-4.1V.
Размеченные предпочтения всё же участвуют в рецепте, но не в обучении линейного слоя. Multimodal RewardBench использовали, чтобы выбрать глубину, поэтому его результаты служат настройкой, а перенос проверяли на VL-RewardBench и MMRB2. Корректнее говорить не о полностью безразметочном процессе, а об обучении без размеченных пар с небольшим размеченным контуром выбора архитектуры.
Искажённые подписи задают, что именно модель считает ошибкой
Положительным примером служит подпись из веб-данных. Отрицательный пример получают автоматически: заменяют цвет, число, размер или пространственное отношение, переставляют части текста либо подставляют продолжение другой подписи. Например, «две коричневые лошади у красного забора» превращается в почти идентичную фразу с синим забором.
Такая правка сохраняет автора, стиль и почти всю длину текста. Модель не может решить задачу по побочному признаку вроде многословности и должна извлечь из внутреннего слоя связь между изображением и изменённым фактом. При одинаковом количестве обучающих пар эти автоматические искажения дали на 3–5 процентных пунктов больше, чем размеченные пары RLAIF-V.
Но набор искажений фактически определяет саму функцию вознаграждения. Два линейных слоя обучили на разных частях одного банка примеров: на стандартном бенчмарке они показали почти одинаковый результат, а при поиске галлюцинаций разошлись на 6,4 пункта. Один оценщик лучше замечал правки, видимые через признаки CLIP, другой — изменения, которые CLIP пропускал.
Отсюда следует практическая проблема: точность на парных сравнениях не раскрывает, за какой признак оценщик начисляет баллы. При выборе лучшего из нескольких ответов бенчмарковый рейтинг моделей вознаграждения не совпадал с их полезностью, а простой оценщик по правдоподобию ответа иногда работал не хуже обученного слоя.
В рабочем контуре оценщик нужно учить на ошибках своей модели
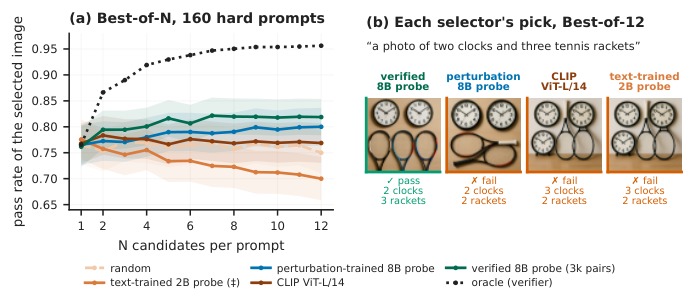
Авторы добавили один цикл самонастройки. Базовая модель генерировала несколько кандидатов, дешёвые проверяющие процедуры отмечали удачные и ошибочные варианты, после чего тот же линейный слой переобучали на новых парах. Теперь отрицательные примеры изображали не искусственную порчу подписи, а реальные ошибки модели, которую оценщик должен обслуживать.
При ранжировании подписей такой слой снизил показатель CHAIR на 5,1 пункта. Эта метрика считает упоминания объектов, которых нет на изображении. В отдельном опыте с генерацией изображений доля результатов, прошедших автоматическую проверку, выросла на 5,4 пункта. При этом обновлённый оценщик стал хуже на всех стандартных бенчмарках вознаграждения.
Для продуктовой команды работа меняет порядок проверки, а не выбор основной модели. Линейный слой на замороженной основе можно использовать как дешёвый прототип и обучить без заказа парных оценок у людей. Затем его следует проверять на кандидатах собственной модели и на той ошибке, которую продукт действительно должен уменьшать: галлюцинациях, неверных атрибутах или несоблюдении условий запроса.
Эксперименты охватывают семейство Qwen3-VL, GLM-4.1V, подписи к изображениям, визуальные вопросы и генерацию изображений. Практические замеры построены вокруг выбора лучшего ответа из набора кандидатов. Рецепт особенно применим там, где правильность можно недорого проверить автоматически; именно проверяющая процедура тогда задаёт полезную для продукта функцию вознаграждения.
Источники
Иллюстрация: рисунок из статьи «Unsupervised Multimodal Reward Modeling», Yueying Li, Jingxuan Fan, Kiant\'e Brantley и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


