
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
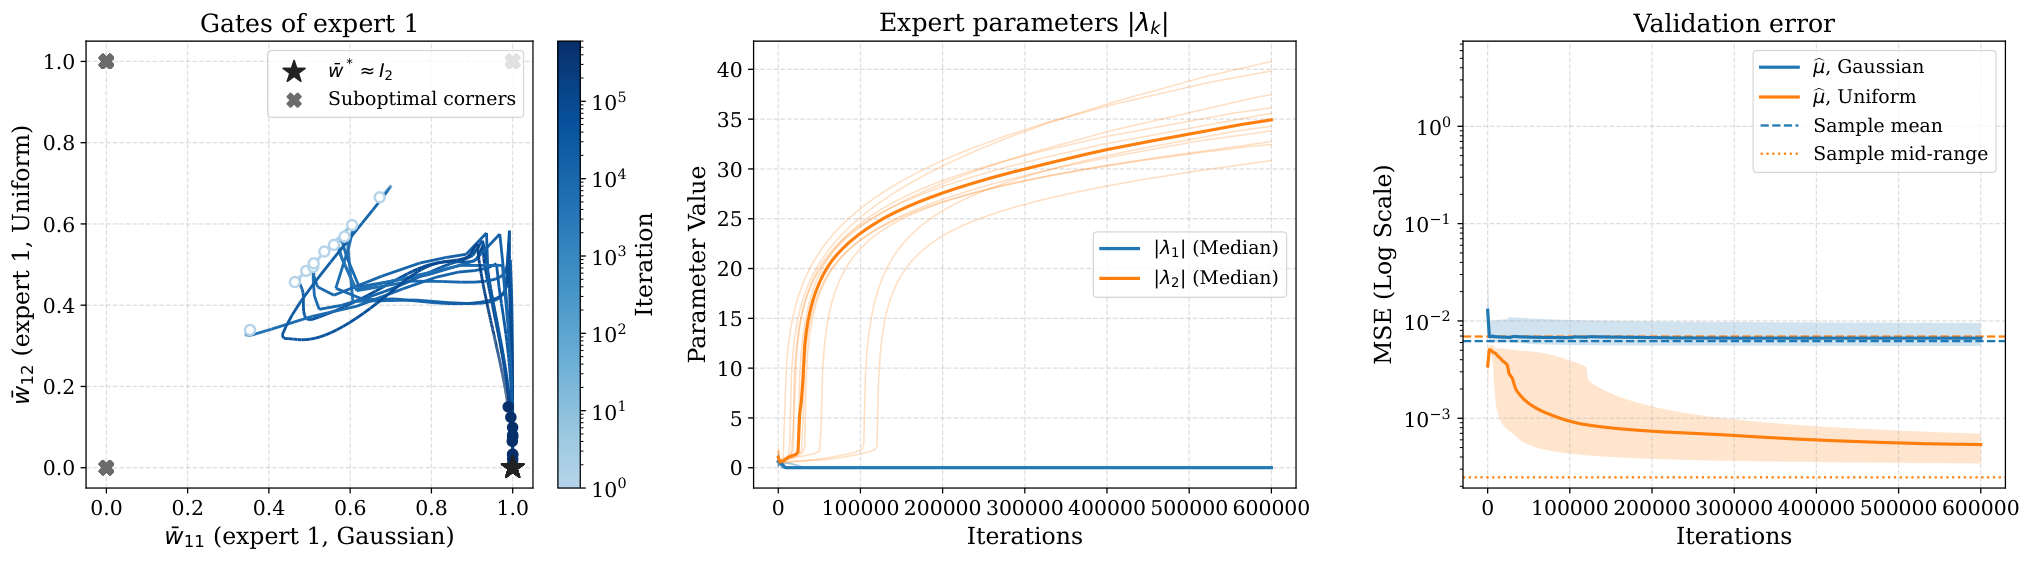
Модель научилась выбирать способ оценки среднего по форме выборки, хотя при обучении ей не сообщали тип распределения. Хотя препринт не рецензирован и все числа получили сами авторы, модель сохранила оптимальную ошибку порядка 1/n для Gaussian и почти достигла 1/n² для uniform. Работа предлагает механизм, который может объяснить статистическую адаптивность PFN-подобных моделей.
Механизм внимания строит экспоненциально взвешенное среднее. При нулевом весе оно совпадает с обычным средним, а при больших положительных и отрицательных весах приближается к максимуму и минимуму выборки. Поэтому одни и те же блоки дают признаки для распознавания распределения и создают несколько оценок-кандидатов.
Следующий слой выполняет маршрутизацию: определяет форму распределения и назначает ей подходящего эксперта. Для Gaussian он выбирает среднее, для uniform — оценку по крайним значениям. Сначала обучение устраняет систематическое смещение, затем эксперты специализируются; для гарантии требуется порядка n1+ε обучающих задач без учёта логарифмических множителей.
Softmax-смесь экспертов автоматически нормализует веса: их сумма всегда равна единице. Поэтому сдвиг всех наблюдений на одну величину сдвигает ответ ровно на неё же. GLU должен отдельно выучить эту нормализацию, из-за чего его обучение делится на быстрый этап устранения смещения и более медленный выбор эксперта.
Проверка охватывает одномерную оценку положения для Gaussian, uniform и симметричной Gaussian mixture с уменьшающимся разбросом компонентов. Теория разбирает двух экспертов и поэтапное обучение в упрощённой архитектуре; эксперименты также воспроизводят специализацию при совместном обучении. Результат объясняет возможный внутренний механизм адаптации, но не измеряет качество готового TabPFN на прикладных табличных задачах.
Источники
Иллюстрация: рисунок из статьи «Adaptive Mean Estimation by In-Context Learning: A Gradient-Flow Analysis», Martin Eppert, Krishna Balasubramanian, Subhro Ghosh и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


