
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковые модели часто теряют иерархию выражения, когда пересказывают его другой модели обычным текстом. В препринте Apple, который не проходил рецензирование, все числа получили сами авторы: лучшая пара — GPT-5 как генератор и Gemini-3.1-Pro как извлекатель — сохранила структуру в 92,9% случаев. Для конвейера из нескольких моделей это означает, что модели на входе и выходе стоит выбирать по отдельности, а критичную структуру по возможности передавать не прозой.
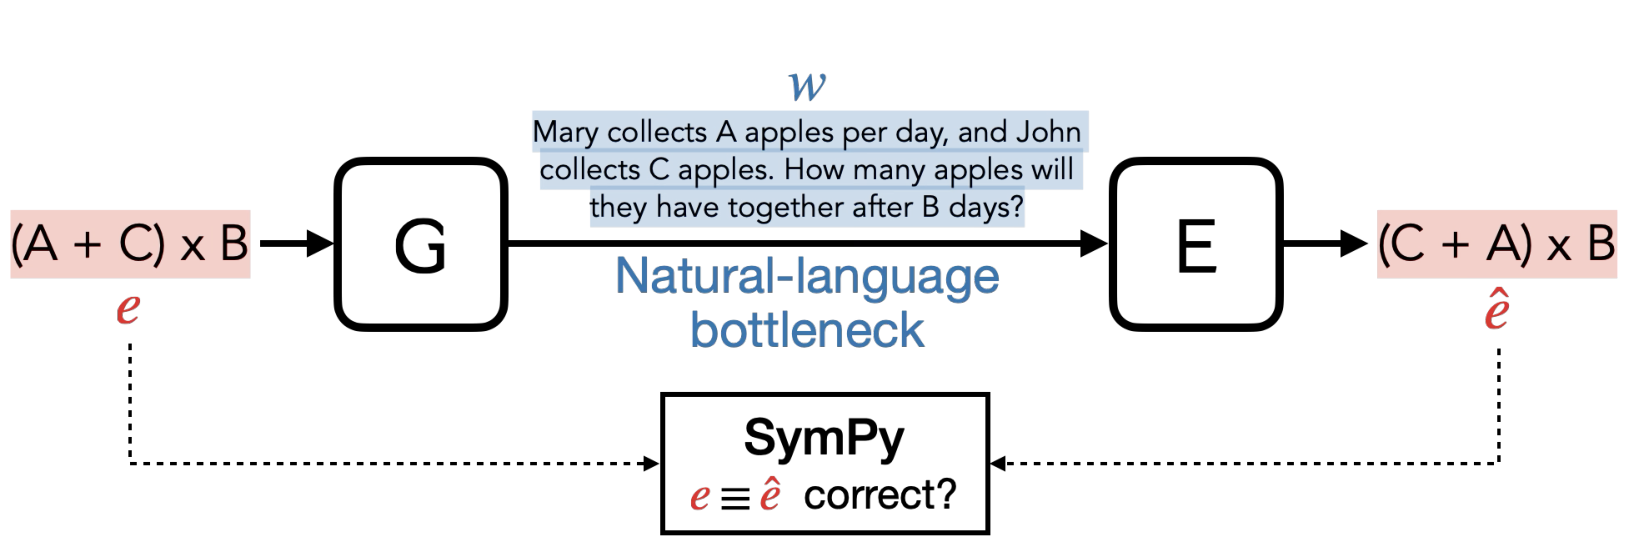
В эксперименте одна модель превращала арифметическое выражение с древовидной структурой в текстовую задачу без математических символов. Другая модель читала только эту задачу и восстанавливала исходное выражение. SymPy проверял точное символическое равенство, поэтому переставленные слагаемые считались правильным ответом, а потерянная операция — ошибкой.
Перестановка моделей между ролями меняла точность вплоть до 60,4 процентного пункта. Не менее 73,6% неудачных проходов возникли на этапе генерации: модель либо описывала другое выражение, либо оставляла неоднозначность, которую уже нельзя было исправить при чтении. Поэтому сильный извлекатель не компенсирует плохо составленный промежуточный текст.
Структурный формат помогал сохранить больше информации. У крупных моделей Qwen3 извлечение из JSON или S-выражений было точнее, чем из текста, на 18–20 процентных пунктов. Практический вывод касается архитектуры: если между агентами нужно передать дерево операций, план или вызов инструмента, свободный текст создаёт отдельный источник ошибок даже при корректной работе моделей по обе стороны.
Проверка охватила 16 моделей и 2450 английских задач с арифметическими деревьями разной глубины и формы; основной результат также повторили на логических выражениях. Режим рассуждения отключили, а запросы не настраивали под отдельные модели. Поэтому работа измеряет передачу проверяемой структуры в контролируемой задаче, а не качество произвольного взаимодействия агентов.
Источники
Иллюстрация: рисунок из статьи «The Communication Bottleneck: A Round-Trip Study of Tree-Structured Expression Serialization in Language Models», Xavier Suau, Alex Ferrando de las Morenas, Luca Zappella и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


