
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
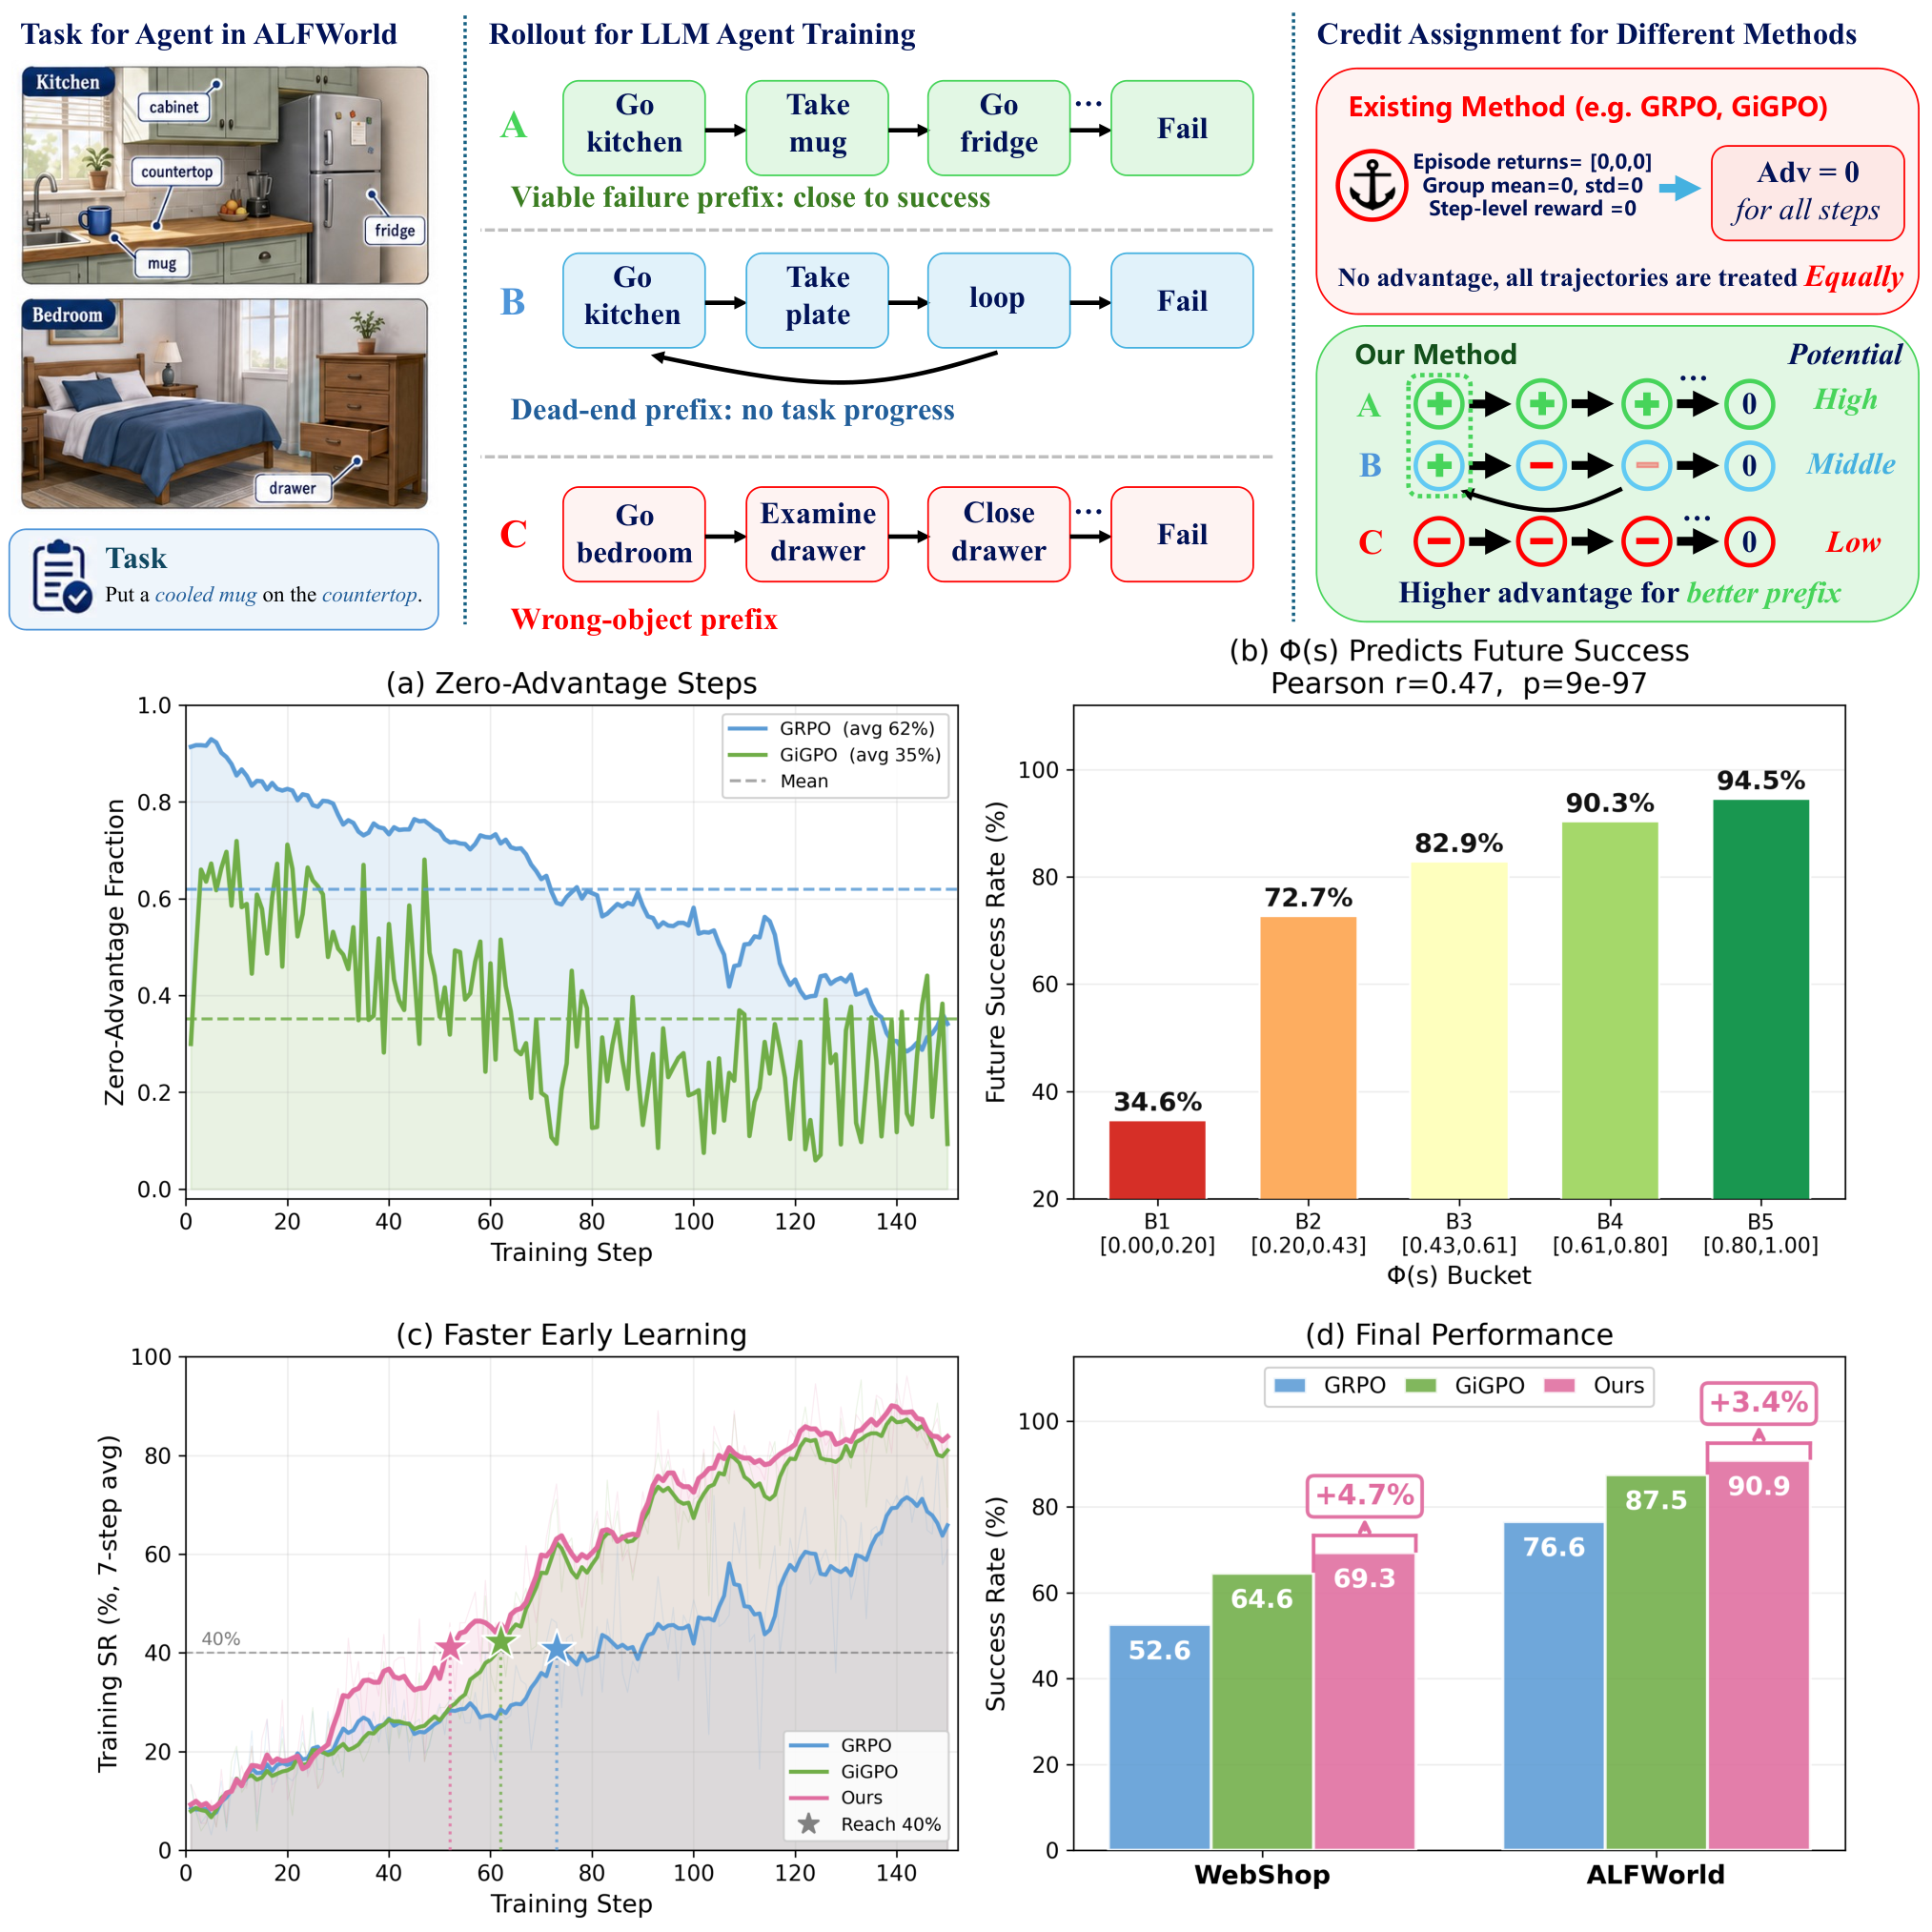
LLM-агента научили использовать полезные начальные шаги даже тогда, когда вся попытка закончилась провалом. Qi Zhou и Yuanfan Li назвали метод MVPO и получили на WebShop прирост успешных выполнений на 5,3 процентного пункта относительно GiGPO. Препринт не рецензирован, а числа получили сами авторы; метод может ускорить раннее обучение агентов, которым награду дают только за полностью выполненную длинную задачу.
Почему провалы дают нулевой сигнал
При обучении с подкреплением агент выполняет задачу несколько раз, получает награду и обновляет правила выбора действий. В длинных задачах награда часто приходит только в конце: например, когда агент нашёл товар с нужными свойствами и оформил покупку. Если он ошибся на последнем шаге, вся попытка получает такой же ноль, как бессмысленное блуждание в начале.
GRPO сравнивает итоговые награды нескольких попыток. Когда все попытки провалились, сравнивать нечего: их относительные оценки полезности становятся нулевыми, поэтому модель не учится отличать перспективные действия от бесполезных.
GiGPO переносит сравнение на отдельные шаги. Метод находит повторяющиеся состояния и сопоставляет результаты продолжений из одной точки. Но если все продолжения снова заканчиваются одинаково, оценка также обнуляется.
В начале обучения на WebShop нулевую оценку получали более 90% шагов GRPO и около 65% шагов GiGPO. При этом внутри неудачной траектории уже может быть правильное начало: агент выбрал нужный раздел, нашёл подходящий предмет или выполнил часть условий, но затем свернул не туда.
MVPO рассматривает префикс — начальную часть траектории — отдельно от конечного результата. Поэтому попытка «найти кружку, взять её, подойти к холодильнику, но не завершить задачу» становится полезнее попытки, где агент взял другой предмет или зациклился между локациями.
Как MVPO оценивает жизнеспособность префикса
Сначала метод превращает состояние среды в краткое описание прогресса. Оно может включать текущую фазу задачи, найденные и взятые предметы, выполненные условия, обнаруженные сведения и повторяющиеся действия.
Затем MVPO объединяет эквивалентные состояния из разных попыток. Для этого он использует структуру Union-Find: она быстро собирает состояния с одинаковыми признаками прогресса или те, которые среда считает равнозначными. Такие группы позволяют накопить статистику, даже если точные тексты наблюдений различаются.
Каждая группа получает потенциал жизнеспособности. Он растёт, если достигнутые промежуточные этапы часто предсказывают дальнейший прогресс или успех, и падает, если состояние связано с циклами. Важность этапов метод выводит из накопленных попыток, а не задаёт им постоянную ручную награду.
Разница потенциалов между соседними состояниями превращается в оценку действия. Переход к более перспективной группе получает положительный сигнал, возврат или вход в тупик — отрицательный. Редкие группы сглаживаются общей статистикой, чтобы единичная попытка не стала решающей.
Этот сигнал не заменяет обычное сравнение. Если продолжения из повторяющегося состояния дали разные результаты, MVPO использует их реальные награды. Потенциал включается только там, где повторяющиеся продолжения получили одинаковый результат; уникальные состояния остаются нейтральными. По мере роста доли успешных попыток вклад потенциала уменьшается, поскольку позднее он может добавлять шум.
Метод остаётся без отдельной модели ценности: он меняет способ вычисления полезности шага, но не добавляет ещё одну нейросеть для предсказания будущей награды.
Когда метод меняет план обучения агента
Основное сравнение провели на Qwen2.5-1.5B-Instruct. При одинаковой длине обучения MVPO обошёл GiGPO на 4,4 процентного пункта успешных задач в ALFWorld и на 5,3 пункта в WebShop. Дополнительный расчёт оценок занял не более 0,20% времени шага GiGPO, однако полный шаг обучения в таблице оказался до 12% длиннее из-за различий на других этапах, прежде всего при генерации траекторий.
Работа меняет план команды, если агент обучается на длинных последовательностях действий, получает редкую итоговую награду и в начале почти всегда проваливается. В таком режиме полезно сохранять не только успешные траектории, но и признаки промежуточного прогресса, эквивалентность состояний и сведения о циклах.
MVPO нельзя добавить как универсальную замену GRPO одной настройкой. Для новой среды нужно определить признаки прогресса, промежуточные этапы и правила объединения состояний. Если наблюдения плохо структурированы или прогресс нельзя надёжно описать, группы станут шумными и потенциал перестанет отражать шанс на успех.
Метод проверяли на ALFWorld, WebShop и задачах поиска ответа с Qwen2.5. Эти условия покрывают управление в текстовой среде, покупки и поиск, но не доказывают такой же эффект в произвольных рабочих процессах. Для коротких задач с частой наградой выигрыш должен быть меньше: там обычным методам уже хватает прямого сигнала.
Для агента, который только вызывает готовую модель через API и не обучает собственную политику, работа ничего напрямую не меняет. Для команды с собственным контуром обучения она предлагает практический критерий: если большинство собранных попыток заканчиваются одинаковым нулём, их не стоит целиком выбрасывать — сначала нужно проверить, различим ли полезный прогресс внутри траекторий.
Источники
Иллюстрация: рисунок из статьи «Learning from Viable Failure Prefixes: Milestone Viability Potential Policy Optimization for Long-Horizon LLM Agents», Qi Zhou, Yuanfan Li, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


