
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Крупные языковые модели не дают автоматического преимущества в массовой классификации коротких текстов. Даже небольшая генеративная LLM обрабатывала документы в 40–486 раз медленнее, чем Complement Naive Bayes на центральном процессоре. Командам с размеченными данными стоит сначала проверить классический алгоритм на своей задаче, хотя препринт не рецензирован и все числа получили сами авторы.
Граница зависит от задачи и количества разметки
Команда UC San Diego и Lawrence Berkeley National Laboratory сравнила Complement Naive Bayes с моделями семейств Qwen, gpt-oss, GLM и Kimi размером от 27 млрд до триллиона параметров. В сравнение также вошли DistilBERT и дообученная модель для классификации.
Complement Naive Bayes — вариант вероятностного классификатора, рассчитанный в том числе на несбалансированные классы. Авторы подавали ему пары соседних слов и взвешивали слова через TF-IDF: часто встречающееся в конкретном документе слово получает больший вес, если оно редко встречается в остальном корпусе.
Методы проверяли на англоязычных Amazon Polarity, AG News и 20 Newsgroups. Это задачи с короткими текстами и одной правильной меткой: тональность отзыва или тема документа. Такой набор хорошо показывает массовую маршрутизацию писем, отзывов и заявок, но не переносится напрямую на многоязычные тексты, длинный контекст и задачи, где ответ нужно сгенерировать.
Основная метрика — точность, то есть доля верных ответов. Её дополнили взвешенной F1, которая учитывает точность и полноту по каждому классу. LLM работали без примеров или с несколькими примерами в запросе, а классические модели и DistilBERT обучались на постепенно растущем наборе меток.
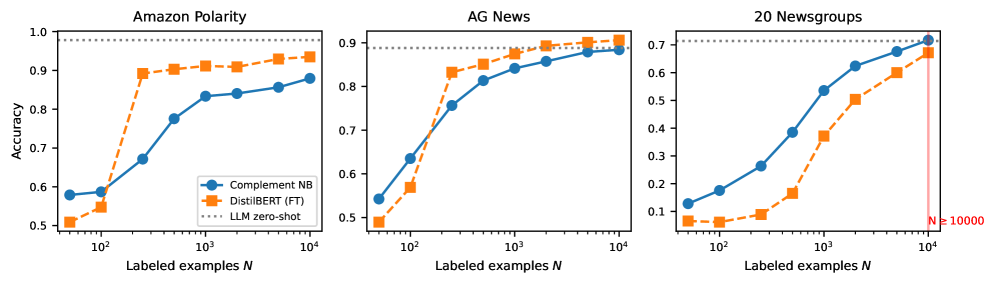
На тематической классификации граница приблизилась к 10 тысячам размеченных документов. На AG News Complement Naive Bayes набрал 89,1% точности против 89,0% у LLM без примеров; разница оказалась в пределах погрешности. На Amazon Polarity классический алгоритм не догнал LLM даже при максимальном проверенном объёме разметки, поэтому единого порога для всех корпусов нет.
Цена складывается из инференса и риска запомненного теста
Высокий результат LLM на Amazon Polarity нельзя отделить от происхождения данных. Этот корпус давно доступен публично и мог попасть в обучающие наборы моделей. На менее распространённой классификации тональности финансовых сообщений Complement Naive Bayes набрал 81,7%, а LLM без примеров — 73,0%.
Разрыв в скорости связан не только с размером моделей. При генерации ответа LLM снова читает веса из памяти GPU, а разреженная модель с TF-IDF помещается в кеш центрального процессора и выполняет короткие матричные операции. Пакетная обработка помогала лишь до насыщения пропускной способности памяти, поэтому увеличение пакета не устраняло разрыв.
Энергия на один документ у классического алгоритма оказалась примерно на два порядка ниже. Это оценка по паспортной мощности процессора, поэтому она скорее задаёт верхнюю границу для Complement Naive Bayes, чем преувеличивает его преимущество.
Выбирать один метод для всего потока необязательно. Авторы направляли в LLM только документы, в которых Complement Naive Bayes был не уверен. На AG News перевод 24% запросов поднял точность до 89,6% и обошёл оба отдельных метода: центральный процессор обработал основную массу, а GPU получил спорные случаи.
Планы меняются для продуктов с разметкой и большим потоком
Работа не предлагает заменить любую LLM на Naive Bayes. Она меняет порядок проверки архитектуры: наличие размеченной истории становится первым условием выбора, а размер доступной языковой модели — вторичным.
- Если меток нет, LLM остаётся начальной точкой: её можно запустить без обучения и получить базовое качество.
- Если накоплена разметка, стоит обучить Complement Naive Bayes и построить кривую качества при разных объёмах данных. Переход оправдан там, где классический алгоритм укладывается в допустимую потерю качества.
- Если ошибки различаются по цене, одной общей точности недостаточно. Следует отдельно посчитать ошибки по классам и назначить им стоимость: например, пропущенная срочная заявка может быть дороже ошибочной маршрутизации обычного письма.
- Если часть документов остаётся сложной, можно ввести порог уверенности и отправлять в LLM только их. Такой каскад позволяет управлять расходом GPU через долю перенаправленных запросов.
Авторы реализовали эту схему как оператор Helm для Kubernetes. Он выбирает конечную точку по заданным порогам качества, задержки и пропускной способности, а решение и рабочие метрики передаёт в Prometheus. Это не универсальная политика из коробки: порог нужно получить на собственном корпусе и пересматривать после изменения данных.
Для высоконагруженной классификации писем, отзывов, обращений или научных документов LLM больше не стоит считать вариантом по умолчанию. Рациональный план — сначала измерить дешёвую базовую модель, затем сравнить стоимость ошибок и только после этого выделять GPU всему потоку либо его сложной части.
Источники
Иллюстрация: рисунок из статьи «LLMs or Naive Bayes? Old Gems or New Ways», Mohammad Firas Sada, Dmitry Mishin, John Graham и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


