
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дерево поиска по длинному документу может улучшать ответы без LLM-сводок: достаточно использовать его как маршрут и передавать модели исходные фрагменты. В препринте BITS Pilani, который не прошёл рецензирование и содержит замеры самих авторов, NavTree обошёл извлекающую версию RAPTOR на 4,4 процентного пункта при бюджете 1024 токена. Команды могут проверить такую схему до того, как добавлять генерацию сводок в индексацию.
Дерево нужно для маршрута, а не для пересказа
Обычный плоский поиск независимо оценивает каждый фрагмент и выбирает самые близкие к запросу. На длинном документе верх выдачи может заполнить один его участок, хотя для ответа нужны сведения из нескольких глав.
RAPTOR решает эту проблему деревом: объединяет фрагменты в группы, создаёт для них сводки с помощью LLM и разрешает поиску возвращать как исходный текст, так и сводные узлы. Здесь смешаны две функции. Структура дерева помогает перейти к нужной части документа, а текст внутренних узлов занимает контекст модели, которая формирует ответ.
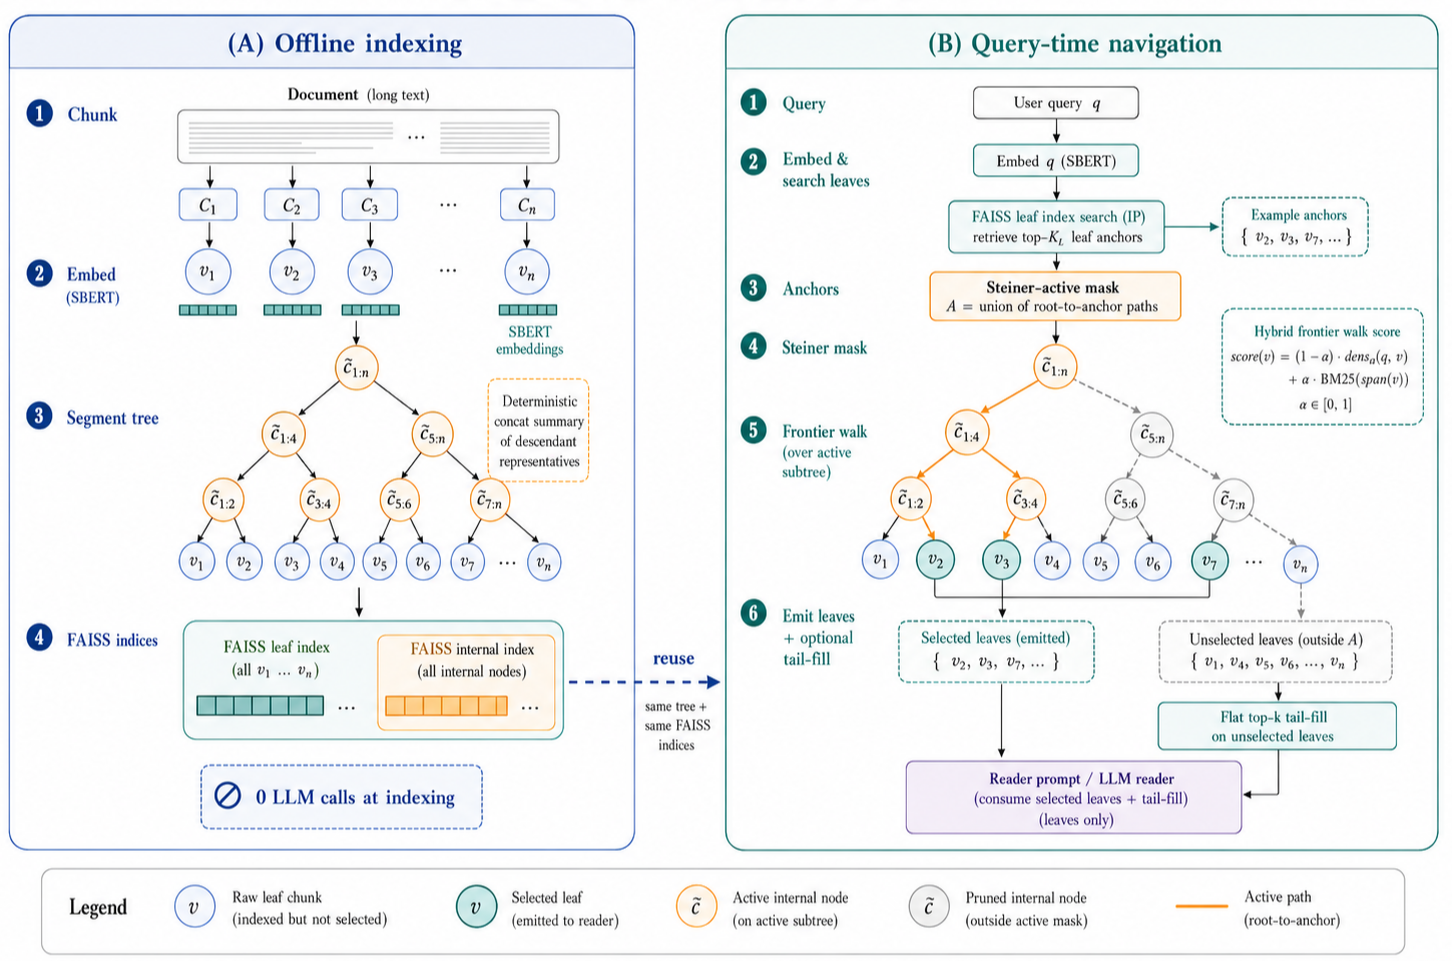
NavTree разделяет эти функции. Внутренние узлы направляют поиск, но никогда не попадают в итоговый контекст. Индекс строится так:
- Документ делят по границам предложений на фрагменты и превращают каждый фрагмент в вектор.
- Над фрагментами строят сбалансированное двоичное дерево. Текст внутреннего узла собирают из характерных предложений его потомков по фиксированному правилу, без LLM.
- Векторы листьев и внутренних узлов сохраняют в отдельных индексах FAISS.
- Для запроса сначала находят наиболее близкие листья. Пути от корня к ним задают часть дерева, по которой разрешено двигаться.
- Поиск выбирает ветви по сочетанию смысловой близости и лексической оценки BM25. В ответ уходят только листья, а остаток доступного контекста заполняют лучшими фрагментами из плоской выдачи.
Последний шаг не даёт дереву недоиспользовать контекст. Если обход выбранных ветвей нашёл мало подходящих листьев, система возвращается к глобальному списку фрагментов.
Сводка выигрывает один узел, но проигрывает общий бюджет
Сама по себе сводка не хуже исходного текста. В отдельной проверке сводный внутренний узел позволил правильно ответить в 55,7% случаев, а лучший лист под ним — в 50,4%. Разница возникает, когда в контекст нужно уложить несколько частей документа.
Сводный узел пересказывает сразу группу фрагментов, но вытесняет листья из других ветвей. NavTree тратит весь бюджет на дословный текст и чаще приносит модели дополнительные свидетельства из разных участков. Поэтому преимущество проявляется на объёмном контексте, а при месте только для одного узла качественная сводка может оказаться полезнее.
В основной сетке NavTree стал лучшим иерархическим методом в 6 из 8 сравнений. На QuALITY разрыв с извлекающей версией RAPTOR вырос до 5,4 процентного пункта при самом большом бюджете, но с лучшим плоским поиском NavTree оказался в пределах погрешности. На многошаговых вопросах он стал единственным иерархическим методом, который статистически значимо обошёл BM25 в прямом сравнении классов.
Методы проверяли на англоязычных QuALITY, QASPER, NarrativeQA-summary и LongBench-SD, а многошаговый поиск — также на HotpotQA, 2WikiMQA, MuSiQue и полной версии NarrativeQA. В основных опытах использовали одинаковые разбиение документов, кодировщик, шаблон запроса и gpt-4o-mini; отдельно результат сверили с gpt-4o, открытыми моделями и более сильным кодировщиком. Среди соперников были BM25, плоский векторный и гибридный поиск, а также извлекающая и генеративная версии RAPTOR.
Менять архитектуру стоит для длинного многошагового поиска
Работа меняет планы команд, которые собирались генерировать сводку для каждого внутреннего узла большого индекса. NavTree обходится без вызовов LLM при индексации, тогда как RAPTOR вызывает модель для каждого такого узла. Для корпуса из миллиона документов оценка затрат на генеративную индексацию превышает 60 тысяч долларов.
Практический первый шаг — оставить существующие фрагменты и векторный индекс, добавить над ними сбалансированное дерево и запретить внутренним узлам попадать в контекст. Такой прототип проверяет отдельно ценность навигации. Генеративные сводки стоит добавлять после этого и только для режима с очень тесным контекстом, где один сжатый узел действительно заменяет несколько листьев.
Полностью заменять плоский поиск результаты не требуют. На QuALITY NavTree лишь сравнялся с сильной гибридной схемой, а на QASPER при малом бюджете плоские методы выигрывали. Если вопросы обычно относятся к одному месту документа или весь документ уже помещается в контекст, дополнительное дерево вряд ли окупит сложность.
Наиболее подходящий сценарий — длинные англоязычные документы и вопросы, для которых нужно собрать факты из удалённых разделов. Для других языков и нетекстовых данных работа выводов не даёт.
Источники
Иллюстрация: рисунок из статьи «Tree Navigation Without LLM Summaries: A Matched-Cost Study of Hierarchical Retrieval for Long-Document QA», Priyank Jayraj, Poonam Goyal, Navneet Goyal, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


