
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Слабую модель научились использовать как источник ошибок, от которых более сильный ученик должен уходить при дистилляции. В препринте NAVER AI Lab, который не проходил рецензирование и приводит замеры самих авторов, новый метод стабильно обошёл обычное обучение только на генерациях ученика. Для команд с собственным контуром дообучения это означает, что менять функцию награды может быть не обязательно: дополнительный сигнал появляется на этапе генерации данных.
Слабая модель показывает, какие токены нужно подавлять
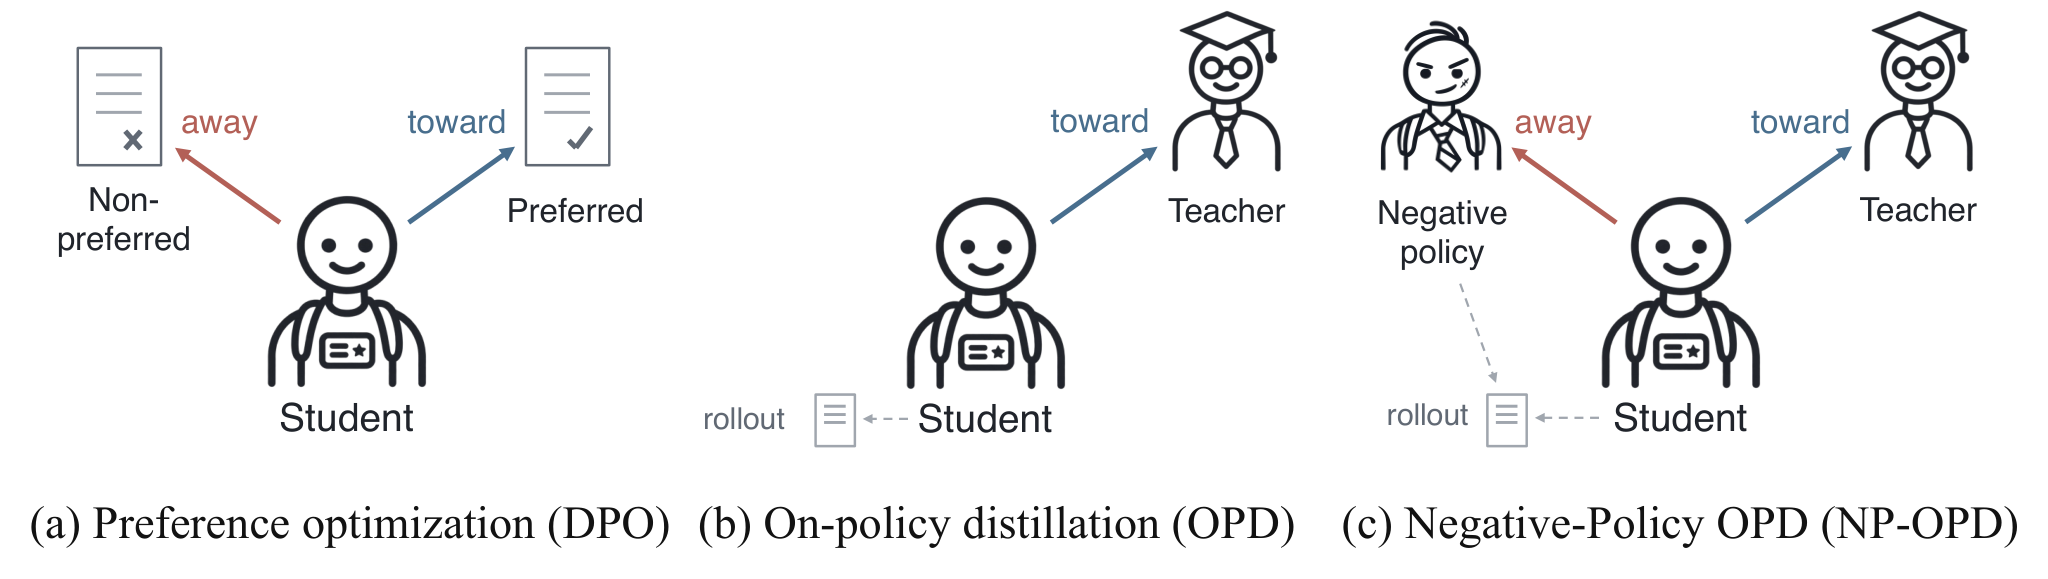
При дистилляции на собственных генерациях (on-policy distillation, OPD) модель-ученик сначала строит ответ. Затем более сильная модель-учитель оценивает каждый выбранный токен, а ученик корректирует его вероятность в сторону распределения учителя.
Такой подход сохраняет поведение ученика лучше, чем обучение только на готовых ответах учителя. Но у него есть слабое место: учитель задаёт направление, к которому следует двигаться, и не предоставляет отдельного примера поведения, от которого нужно уходить.
Проблема заметнее, когда учитель намного сильнее ученика. Их распределения вероятностей мало пересекаются, поэтому генерации ученика редко заходят в области, где учитель мог бы дать наиболее полезную подсказку. Простое усиление положительного сигнала не добавляет в обучающие данные отсутствующие ошибки.
NP-OPD подмешивает ответы отдельной модели из той же семьи, которая меньше ученика и хуже решает задачи. Учитель оценивает эти ответы тем же способом, что и собственные генерации ученика. Функция награды и направление дистилляции не меняются.
Токены, которые слабая модель выбирает чаще учителя, попадают в обучение чаще и в среднем получают отрицательную оценку. Ученик снижает их вероятность. При этом токен не подавляется только из-за своего происхождения: если учитель его предпочитает, обучение по-прежнему усиливает его.
Метод проверяли на Qwen3 разных размеров и на Gemma-4, в режимах с развёрнутым рассуждением и без него. Обучение охватывало тринадцать проверок по математике, программированию и естественным наукам. NP-OPD сравнивали с обычной OPD при одинаковом сигнале учителя, а также совмещали с ExOPD и OPD2.
Отрицательный пример дал больше, чем искусственное ухудшение ученика
В режиме без развёрнутого рассуждения NP-OPD улучшил средние результаты во всех трёх предметных областях и на разных размерах ученика. У модели среднего размера оценка по задачам на код выросла на 10,9 пункта относительно обычной OPD. На математике и естественных науках направление результата сохранилось.
В режиме с рассуждением прирост оказался скромнее, но сохранился для стандартной OPD и её вариантов. Это поддерживает основную идею работы: эффект даёт не новая формула награды, а выбор модели, которая создаёт обучающие последовательности.
Отдельный опыт проверил, можно ли обойтись без второй модели и намеренно ухудшать генерации ученика. Повышенная случайность и запрос решать задачу на уровне школьника дали прирост не более одного пункта, тогда как отдельная слабая модель добавила 3,4 пункта. Удаление слоёв во время генерации не обеспечило стабильного улучшения.
Анализ токенов совпал с результатами проверок: NP-OPD сильнее подавлял варианты, которые слабая модель предпочитала учителю, и уменьшал сходство ученика с отрицательной моделью. Простое добавление шумных ответов работало хуже, чем последовательные ошибки отдельной модели с более низкими способностями.
Планы стоит менять только командам с собственным дообучением
Если команда уже использует OPD, работу стоит рассматривать как локальную замену источника генераций. Не нужно проектировать новую награду или отказываться от ExOPD и OPD2: часть пакета формирует ученик, часть — заранее выбранная слабая модель, а учитель проверяет оба источника.
Это упрощает экспериментальное внедрение. Генерации отрицательной модели можно подготовить заранее и повторно использовать во время обучения. В вычислительном контуре появляется дополнительная модель и хранилище её последовательностей, но сама модель должна быть слабее и меньше ученика.
Выбор отрицательного примера нельзя свести к любой модели с плохим качеством. В работе использовали меньшую модель из той же семьи, чьи ошибки оставались связаны с поведением ученика. Искусственный шум дал меньший эффект, поэтому при проверке метода следует сравнивать несколько подходящих слабых моделей, а не только менять случайность генерации.
Для команд, которые ограничиваются готовым API или обычным дообучением на парах «запрос — ответ», работа планов не меняет. NP-OPD требует доступа к вероятностям токенов учителя и ученика, собственному циклу генерации и обучению в стиле методов с подкреплением. Практическая ценность появляется там, где такой контур уже есть и команда ищет улучшение без переработки награды.
Источники
Иллюстрация: рисунок из статьи «On-Policy Distillation with Negative-Policy Rollouts», Jaehui Hwang, Dongyoon Han, Sangdoo Yun и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


