
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Архитектуру Transformer научились оценивать и подбирать по одной спецификации — без создания модели, данных и градиентов. Работа Chenyu Zhu, Ruoyu Zhao и Zhichao Lu из City University of Hong Kong предлагает метрику NSC; при структурном сокращении LLaMA-7B поиск оказался примерно в 5900 раз быстрее сильнейшего метода сравнения, хотя работа не рецензирована и числа в ней получены самими авторами. Такой подход позволяет отсеять часть вариантов до дорогого обучения или проверки на калибровочной выборке.
Как спецификация превращается в оценку
Число параметров показывает размер модели, а вычислительная стоимость во FLOPs — объём операций. Обе величины пропускают структуру: глубокая узкая сеть и неглубокая широкая могут укладываться в один бюджет, но по-разному распределять вычисления между вниманием, головами и полносвязными блоками.
Neural Spectral Capacity, или NSC, оценивает формы весовых матриц. В основе лежат сингулярные значения: они описывают, насколько матрица растягивает сигнал по разным направлениям. Для каждой матрицы метод вычисляет спектральную ёмкость через логарифм определителя, а затем складывает оценки по слою и всей сети.
Вычислять сами сингулярные значения не нужно. При стандартной случайной инициализации закон Marchenko–Pastur задаёт ожидаемый спектр через размеры матрицы и дисперсию весов. Поэтому NSC получает результат непосредственно из спецификации: ширины слоёв, размеров полносвязных блоков, числа голов и выбранной схемы инициализации.
Головы внимания учитываются раздельно, иначе метрика не различала бы варианты с разным их числом. Свёртки представляются как матрицы, а эмбеддинги, смещения, нормализации и нелинейные функции в оценку не входят. NSC не моделирует реальный прямой проход сети: канал передачи информации здесь служит математическим способом определить оценку.
Аддитивность позволяет применить NSC-DP — поиск методом динамического программирования. Если для каждого слоя задан набор вариантов и стоимость каждого варианта, алгоритм выбирает их сочетание с наибольшей суммарной NSC при ограничении на параметры или вычисления. Он находит глобальный максимум только для этой метрики и внутри заданного пространства, а не гарантированно лучшую модель после обучения.
Где NSC различает похожие архитектуры
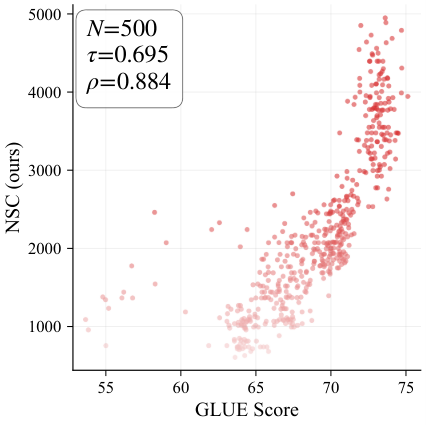
Метрику проверили на семи семействах Transformer и свёрточных сетей. Она должна была предсказать порядок архитектур по качеству после обучения и превзошла число параметров, FLOPs и несколько методов оценки без обучения.
На FlexiBERT коэффициент рангового совпадения Кендалла составил 0,505 для пар, у которых число параметров отличалось менее чем на 10%. Само число параметров на тех же парах дало 0,082. Этот тест особенно близок к реальному выбору под бюджет: грубые показатели почти одинаковы, а различия создаёт устройство сети.
В отдельном поиске NSC-DP подобрал конфигурацию Transformer-XL для WikiText-103 за 2 секунды на одном процессорном ядре. После обучения она обошла спроектированную вручную базовую архитектуру. Конкурирующим оценкам требовалось создавать случайно инициализированные сети, прогонять входные данные и искать варианты эвристически.
Границы проверки заданы тремя сценариями: ранжирование готовых спецификаций, проектирование Transformer-XL и структурное сокращение LLaMA через обученную надсеть LoNAS. Результаты показывают связь NSC с итоговым качеством в этих пространствах, но не превращают её в универсальную замену обучению и прикладным тестам.
Как это меняет план архитектурного поиска
NSC можно поставить перед дорогим этапом экспериментов. Команда сначала описывает допустимые ширины, глубины, размеры полносвязных блоков и варианты голов, задаёт ресурсный бюджет, а затем оставляет для обучения несколько конфигураций с высокой оценкой. Наибольшую пользу метод даёт там, где кандидаты близки по размеру и FLOPs: обычные показатели уже не помогают их упорядочить.
Для структурного сокращения подход снимает ещё одно требование — калибровочные данные не нужны для выбора подсети. В опыте на восьми задачах бытового рассуждения NSC-DP выбрал конфигурацию с целевым размером 5,7 млрд параметров и обошёл W-PCA в среднем на 1,64 процентного пункта. Поиск также не обращался к предобученным весам, хотя качество выбранной конфигурации затем проверяли на весах LoNAS.
Практический план меняется не на этапе окончательной проверки, а раньше. Вместо случайного или эволюционного перебора можно получить воспроизводимый оптимум NSC для каждого доступного бюджета и направить GPU только на перспективные варианты. Обучение, измерение задержки на целевом оборудовании и проверка на данных продукта всё равно остаются: NSC оценивает распределение архитектурной ёмкости, а не качество конкретной функции после обучения.
Метод лучше всего подходит для дискретного пространства, где сеть собирается из вариантов слоёв, а бюджет и оценка складываются по компонентам. Если ключевой эффект возникает только из взаимодействия нескольких слоёв или особенностей обученных весов, аддитивная метрика может его не увидеть. Поэтому NSC-DP разумно использовать как дешёвый первый фильтр, а не как последнее слово при выборе архитектуры.
Источники
Иллюстрация: рисунок из статьи «Neural Spectral Capacity: Measuring and Designing Architectures from Network Specification Alone», Chenyu Zhu, Ruoyu Zhao, Zhichao Lu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


