
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Улучшение ответа на следующем шаге не показало, способен ли ИИ-агент довести клиентский процесс до конца. В препринте Dialpad, который не прошёл рецензирование и содержит замеры самих авторов, лучший агент завершил лишь 10,4% сценариев с инструментами, а целиком корректно не выполнил ни одного. Для выбора модели это меняет критерий приёмки: качество отдельных ответов надо проверять отдельно от полного прогона.
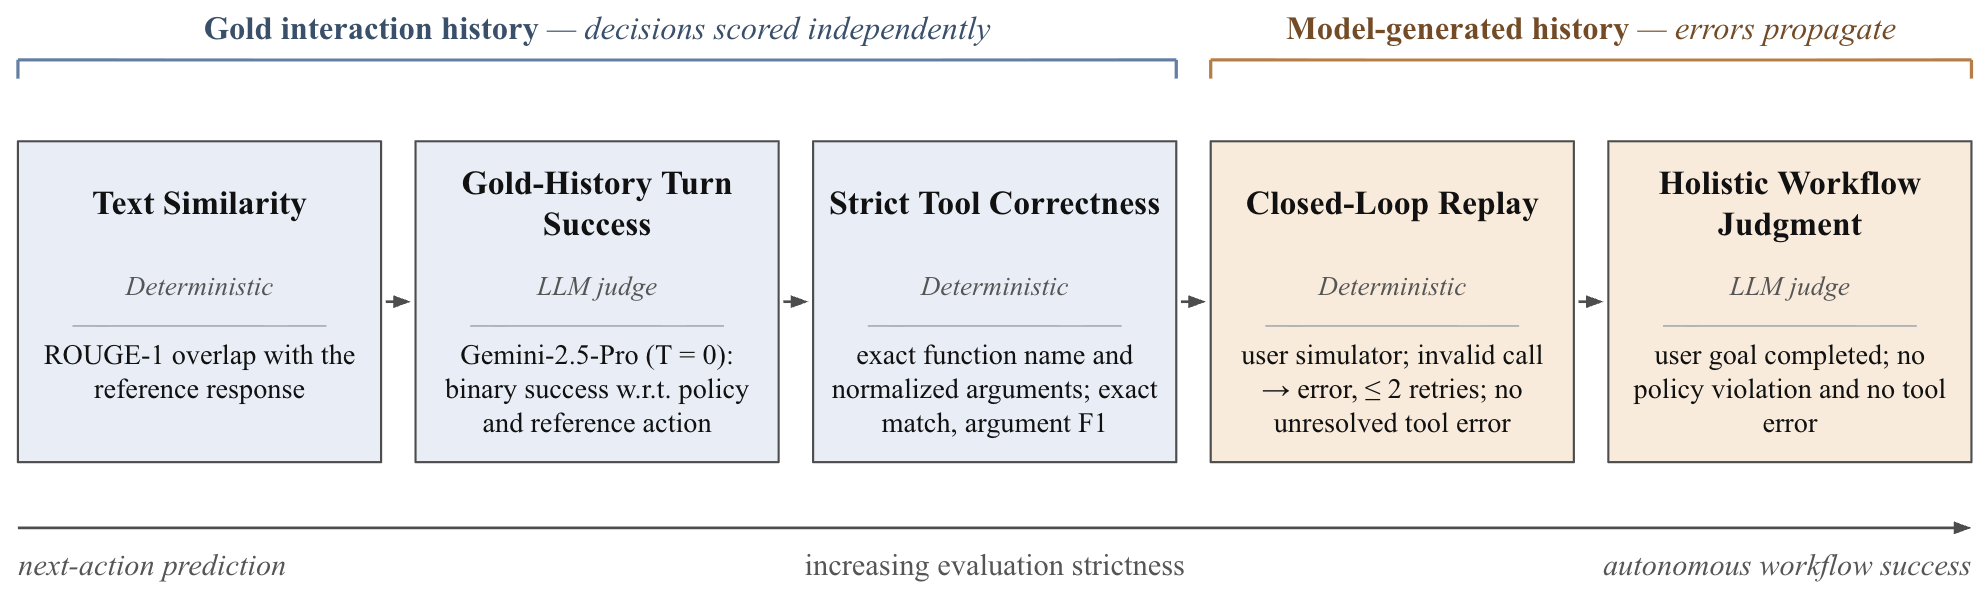
Команда сравнила Qwen3 и Gemma 3 двух размеров до и после дообучения с учителем. В одном режиме модель на каждом шаге получала правильную историю диалога и предсказывала следующее действие. В другом она продолжала процесс после собственных ответов и вызовов инструментов, поэтому ранняя ошибка меняла все последующие шаги.
После дообучения доля успешных текстовых ответов при правильной истории выросла в среднем на 25,2 процентного пункта. Для действий с инструментами прирост составил только 5,9 пункта. Общая метрика следующего шага росла в основном за счёт текста и не показывала, умеет ли агент сохранять состояние процесса.
Даже формальное завершение цепочки вызовов не означало, что задача решена. Модель могла пропустить нужные сведения, нарушить правила предметной области, неправильно использовать результат инструмента или дать неверный ответ пользователю.
Проверка охватывала 84 синтетических диалога из одного закрытого набора клиентской поддержки. Точный автоматический тест требовал совпадения инструмента и аргументов с эталоном, а пользователь отвечал по заранее заданному сценарию; такой протокол может отклонять допустимые альтернативные действия.
В отчёте об агенте одной средней оценки недостаточно. Нужны отдельные показатели для качества текста, правильности следующего действия, точности вызовов инструментов и завершения всей задачи без ошибок и нарушений правил.
Источники
Иллюстрация: рисунок из статьи «When Better Turns Do Not Make Better Agents: Diagnosing the Gap Between Next-Turn Metrics and Workflow Success», Md Tahmid Rahman Laskar, Xue-Yong Fu, Gundeep Singh и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


