
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Система ответов по нормативным документам научилась отличать действующий документ от устаревшего или неприменимого до того, как формирует ответ. Хотя препринт Liuyin Wang, Shuaipeng Jin, Jiwei Shi и Jensen Hsu не рецензирован, а числа получили сами авторы, система с такой проверкой набрала 97,7 балла против 88,1 у готового сервиса поиска по файлам. Для продукта на законах, регламентах или условиях обслуживания это переносит часть работы из подсказки для LLM в схему данных и обработку документов.
Похожий фрагмент ещё не подтверждает ответ
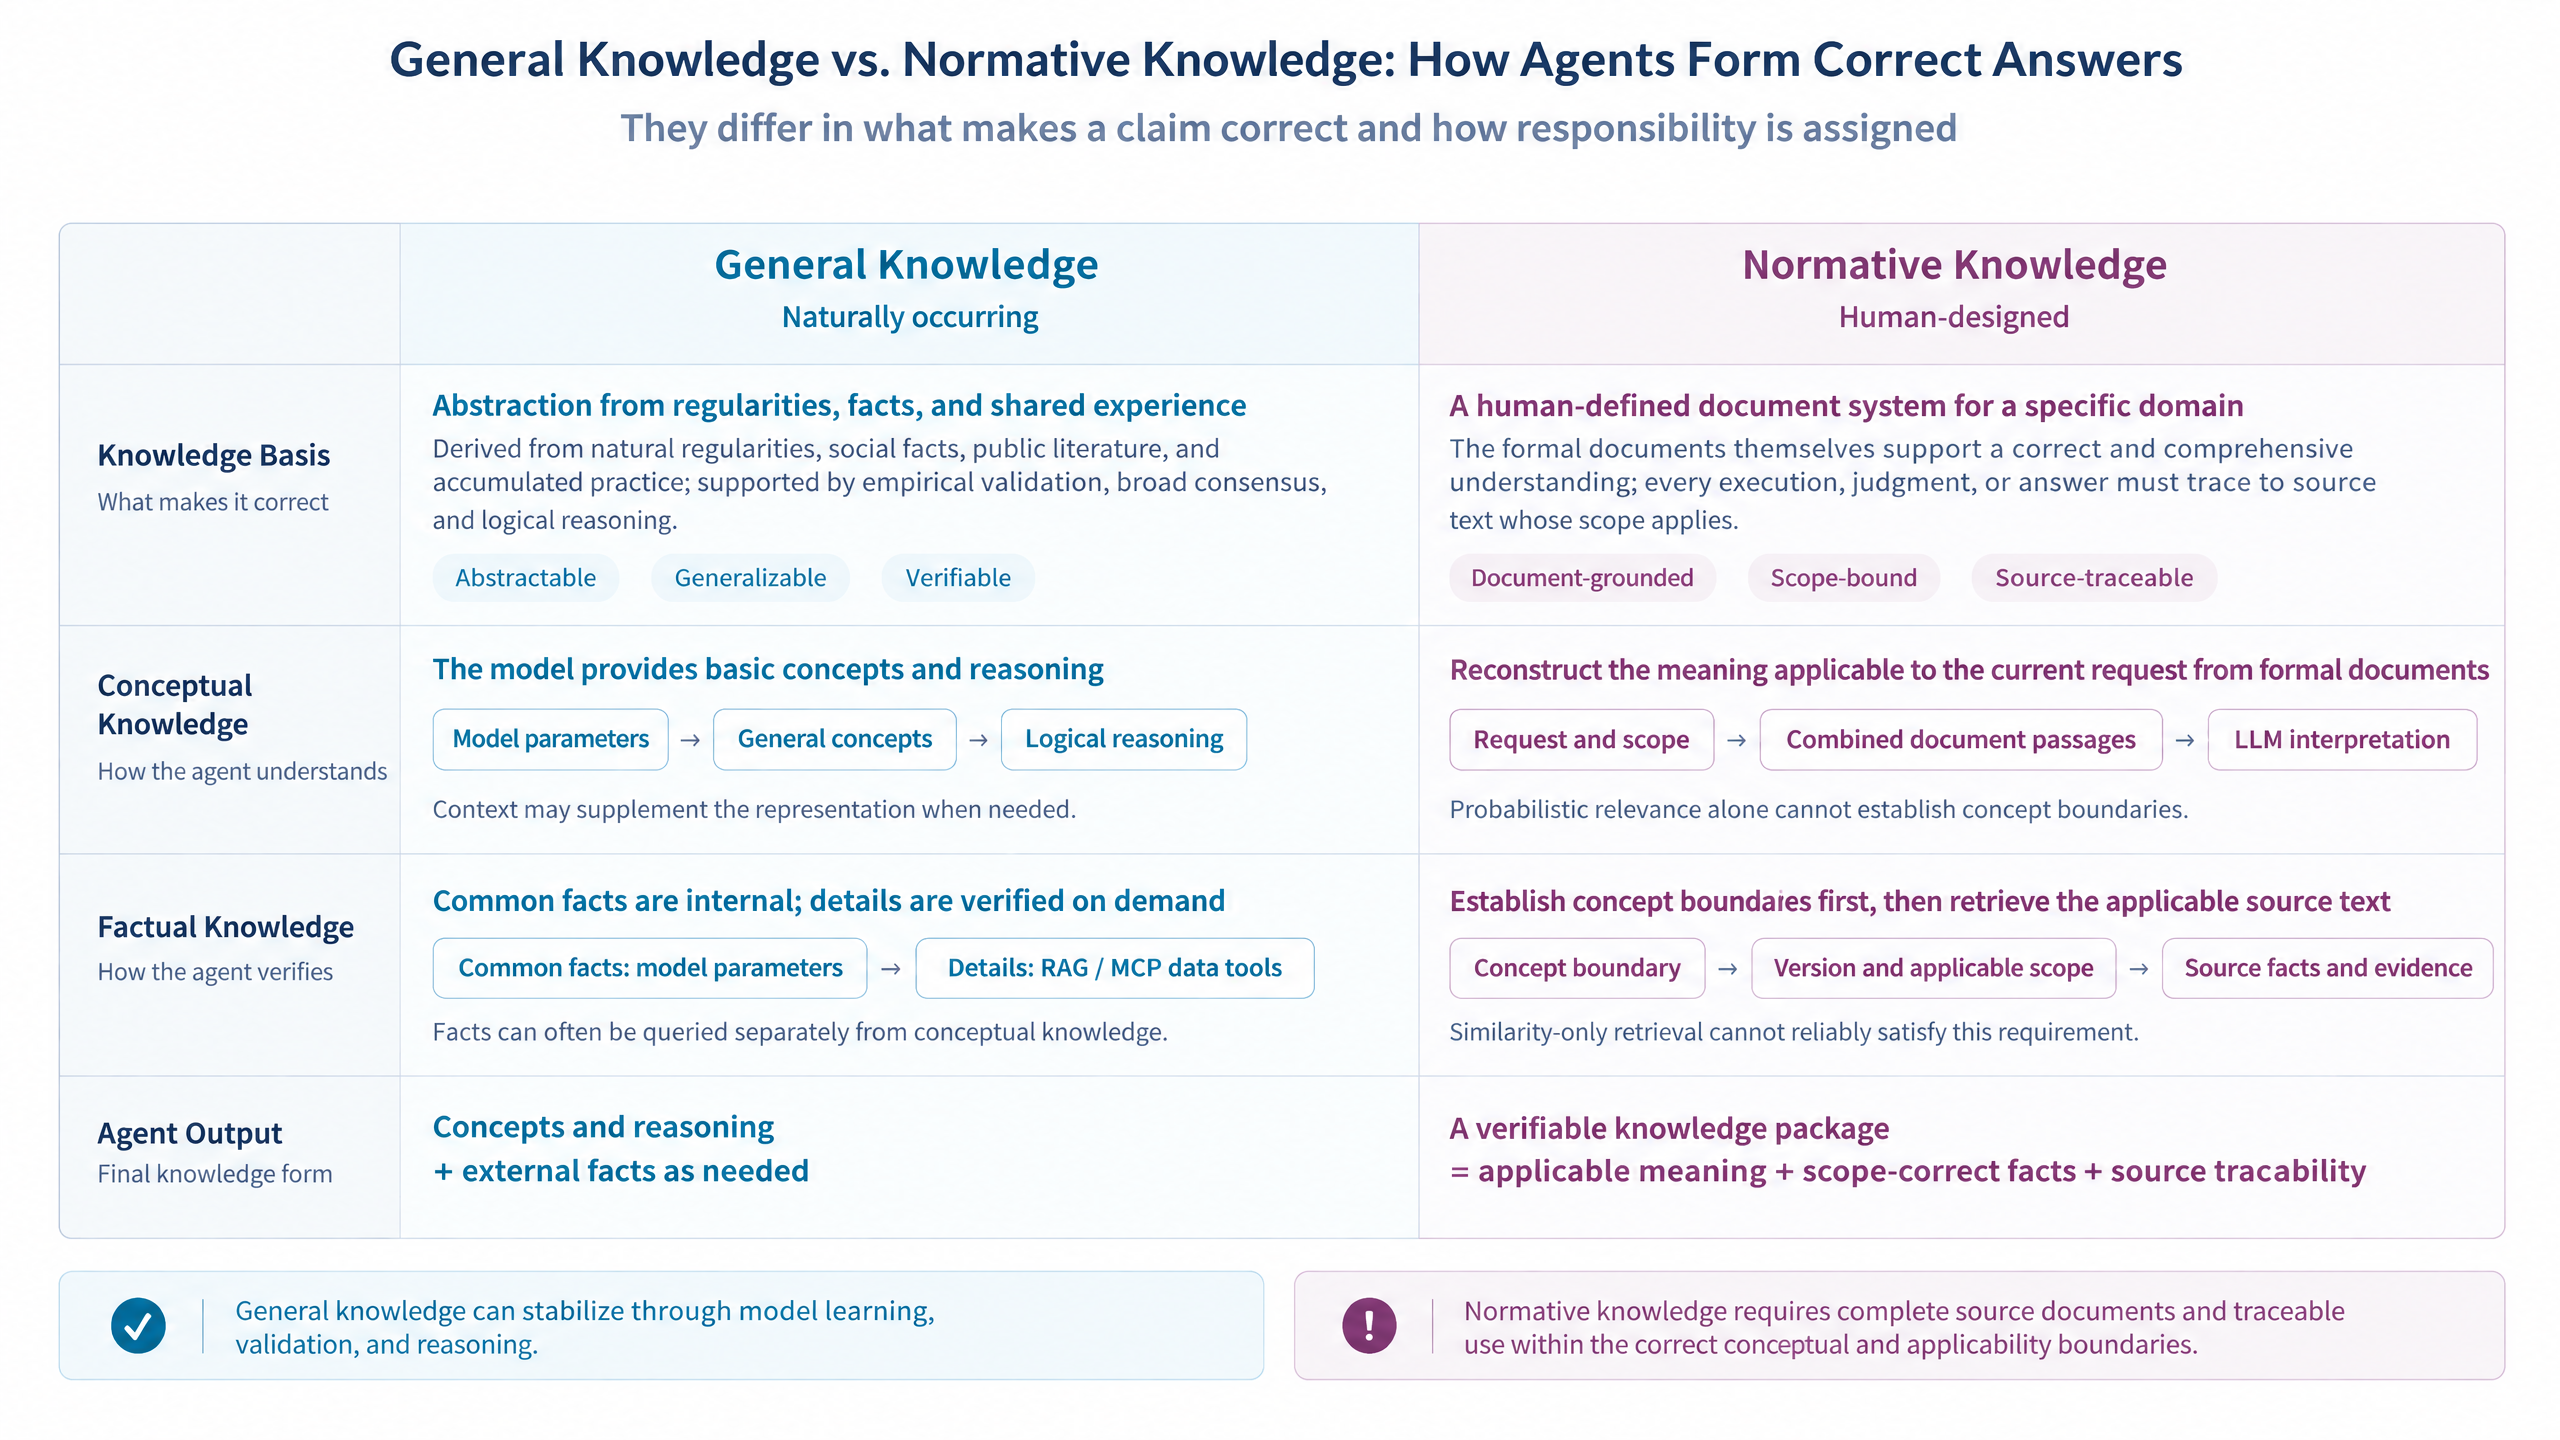
Поиск по смысловой близости хорошо находит фрагменты с нужными словами, но не устанавливает, можно ли применять их к конкретной ситуации. Почти одинаковые положения могут относиться к разным городам, категориям заявителей или периодам. Один документ мог заменить другой, а отдельный пункт — утратить силу раньше остального текста.
Эти признаки часто лежат не в самом фрагменте. Система должна учитывать орган, который выпустил документ, дату вступления в силу, территорию, регулируемый субъект и связи между версиями. Добавленная в текст пометка тоже не гарантирует результата: модель может предпочесть более близкий по формулировке, но устаревший источник.
Проверку провели примерно на 73 000 нормативных документах из китайских государственных сервисов. В выборку вошли 200 вопросов с эталонным документом-источником для каждого; при отборе вопросов скрипт не читал ответы и оценки систем. Даже эта выборка опиралась на 191 отдельный источник, поэтому задача не сводилась к поиску нескольких часто повторяющихся положений.
Оценивали ответ, который получает пользователь, а не промежуточную точность поиска. В набор вошли простые вопросы по одному положению, сложные запросы с несколькими условиями и случаи, когда доступные документы подтверждают лишь часть ответа. Обе системы работали с одним корпусом и проходили одинаковую процедуру оценки.
Обязательные условия сработали лучше мягкого ранжирования
DeepKnown извлекает атрибуты при загрузке документа: орган, номер, тип, даты публикации и вступления в силу. Затем система связывает версии и размечает область действия по территории, времени и регулируемому субъекту. Извлечение помогает выполнять модель, а человек проверяет результат.
Документы делятся по собственной структуре статей, а не на фрагменты фиксированной длины. Благодаря этому один фрагмент не пересекает положения с разными условиями действия. Атрибуты хранятся в отдельных полях, поэтому при появлении новой версии можно обновить связь между документами, не переписывая весь текст для поиска.
Перед ранжированием система применяет обязательные условия и исключает источники, которые точно не подходят по версии или области действия. Если уверенности в извлечённом атрибуте недостаточно, он влияет только на порядок результатов. Когда подходящих доказательств не хватает, фильтры ослабляются по одному в заданной последовательности; если этого недостаточно, система отказывается от содержательного ответа вместо правдоподобной догадки.
Разрыв сохранился даже на простых вопросах и составил 7,9 балла; на сложных он вырос до 10,3. Среди ответов готового сервиса, получивших нулевую оценку, 6 оказались пустыми, 2 не содержали цитат, а 7 ссылались на документы, но давали неверный вывод. Последний тип ошибки особенно важен: наличие настоящей ссылки само по себе не подтверждает, что документ действует и относится к запросу.
Планы меняются на этапе подготовки корпуса
Для первого прототипа готовый сервис загрузки и поиска по файлам остаётся коротким путём: он берёт на себя разбиение текста, индекс, поиск и формирование ответа. Работа показывает, почему такой прототип нельзя считать проверенной производственной архитектурой для нормативного корпуса. Подсказка модели не заменяет явные правила применимости.
Команде придётся заранее определить поля для дат, территорий, субъектов, статуса и связей между версиями. Нужен процесс, который обновляет эти признаки при добавлении документов, проверяет их перед поиском и сохраняет ссылку от каждого утверждения к конкретному положению. Отказ отвечать при недостатке подходящих источников также становится частью логики продукта, а не пожеланием в подсказке.
Сравнивать варианты стоит на полном рабочем корпусе и по конечным ответам. Отдельно полезно учитывать пустые ответы, ответы без цитат и содержательные ошибки с цитатами: они возникают на разных этапах и требуют разных исправлений.
При этом работа сравнивает две системы целиком. Они различаются не только правилами версий и области действия, но также моделями, индексами, обработкой документов и шаблонами ответа. Результат подтверждает преимущество DeepKnown в одном китайском корпусе и одной паре систем, но не позволяет приписать весь разрыв только слою правил.
Источники
Иллюстрация: рисунок из статьи «Version- and Scope-Aware Question Answering over Normative Documents: A Deployed System and an End-to-End Evaluation at Production Scale», Liuyin Wang, Shuaipeng Jin, Jiwei Shi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


