
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
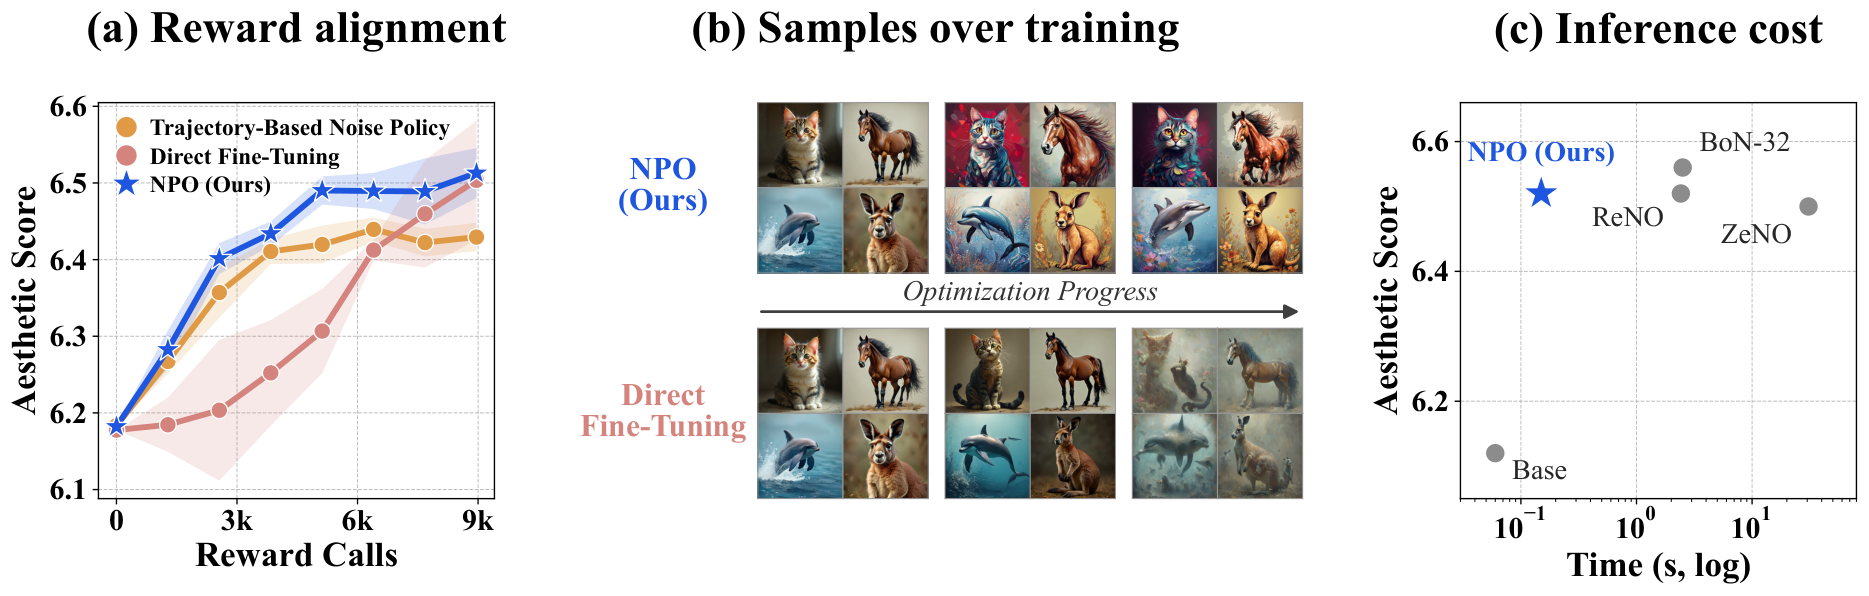
Свойствами быстрых генеративных моделей научились управлять без изменения самой модели и без повторного поиска для каждого результата. В препринте команды из KAIST, Stanford University и других организаций, который не проходил рецензирование и где все числа получили сами авторы, метод NPO показал сопоставимые с поиском результаты при снижении стоимости вывода в 16–549 раз. Для продуктовой архитектуры это открывает промежуточный вариант между дообучением генератора и дорогим перебором во время каждого запроса.
Целевое свойство переносят во входной шум
Одно- и малошаговый генератор превращает случайный шум в изображение, текст или структуру за небольшое число запусков модели. Его можно направить к нужному свойству с помощью скалярной оценки: например, эстетики изображения, принадлежности текста к теме или состава белковой структуры. Градиент этой оценки знать не требуется — достаточно уметь вычислить её для готового результата.
Прямое обучение меняет параметры генератора. На короткой траектории это легко разрушает знания, полученные при предварительном обучении: модель повышает целевую оценку, но теряет разнообразие, смысловую точность или физическую правдоподобность результата.
Альтернатива — оставить генератор неизменным и искать подходящий входной шум. Такой поиск сохраняет исходную модель, но повторяется для каждого результата и сводит на нет преимущество быстрого вывода.
NPO обучает отдельную потоковую политику, которая преобразует обычный гауссовский шум в распределение, смещённое к высокой целевой оценке. Затем преобразованный шум один раз проходит через замороженный генератор. Поскольку отображение генератора детерминировано, сдвиг распределения на входе даёт требуемый сдвиг распределения результатов.
Поиск при этом оплачивается во время обучения политики и затем используется повторно. На выводе система сначала получает шум из обученной политики, а потом запускает исходный генератор. Сам генератор не приходится хранить в нескольких дообученных версиях для разных вариантов настройки.
Правдоподобие оценивают по конечным точкам
Чтобы обучать политику без градиента целевой оценки, NPO должен оценивать, насколько вероятен полученный шум при текущей политике. Обычные методы восстанавливают эту величину по всей траектории генерации. Для детерминированных потоков такой расчёт дорог и требует искусственно добавлять случайность либо строить вспомогательные оценки.
NPO использует оценку правдоподобия через вариационную нижнюю границу (ELBO). Метод берёт конечный шум, добавляет к нему случайное возмущение и учит поток восстанавливать направление движения. Поэтому для обновления политики не нужно сохранять и оценивать полную траекторию.
Функция обучения сочетает целевую оценку результата и штраф за слишком сильное отклонение от исходного распределения шума. Второй компонент не даёт политике сосредоточиться на узкой области, где формальная метрика высока, а качество или разнообразие уже разрушены.
Метод проверяли на генерации изображений, тематическом управлении текстом и создании белковых каркасов. В сравнение вошли прямое дообучение генератора, перебор и оптимизация шума во время вывода, а также политики шума с оценкой по траектории. Выводы работы относятся к детерминированным одно- и малошаговым генераторам со скалярной функцией оценки.
Экономия на поиске не делает вывод бесплатным
NPO давал более выгодное соотношение между целевой оценкой и качеством, чем прямое дообучение. В изображениях он лучше сохранял смысловое соответствие и разнообразие. В текстах прямые методы приходили к повторениям, тогда как NPO удерживал беглость и словарное разнообразие ближе к исходной модели.
На белковых структурах прямое обучение Flow-GRPO довело реализуемость до нуля: ни один созданный каркас не прошёл проверку на возможность восстановить его через подобранную аминокислотную последовательность. NPO одновременно поднял целевую оценку состава вторичной структуры и сохранил заметно больше пригодных каркасов.
По сравнению с поиском во время каждого запроса NPO сократил стоимость вывода в 16–549 раз при сопоставимой или более высокой целевой оценке. Но отдельная политика всё равно увеличила стоимость относительно исходного генератора в 2,2–2,6 раза. Метод сохраняет преимущество малошаговой генерации, но не возвращает систему к базовой задержке.
NPO меняет выбор между дообучением и поиском
Командам с большим потоком однотипных запросов стоит добавить политику входного шума в список архитектурных вариантов. Она особенно уместна, когда генератор уже даёт приемлемое качество, менять его параметры рискованно, а целевую функцию можно вычислять автоматически только по готовому результату.
Проверка такого подхода должна включать не только основную целевую оценку. Нужны отдельные метрики качества и разнообразия, иначе политика найдёт формальный способ повысить награду. Для изображений это могут быть смысловое соответствие и различие между результатами, для текста — повторяемость и разнообразие слов, для структур — физическая реализуемость.
При небольшом объёме запросов разовый поиск может оказаться проще, поскольку NPO переносит вычисления в предварительное обучение, а не устраняет их. Если целевая функция часто меняется, политику придётся обучать заново. Поэтому работа скорее меняет место затрат и границу системы, чем предлагает универсальную замену дообучению.
Источники
Иллюстрация: рисунок из статьи «Noise-Space Reward Alignment for Few-Step Generative Models», Woocheol Shin, Taeyoung Yun, Jiwon Sung и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


