
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
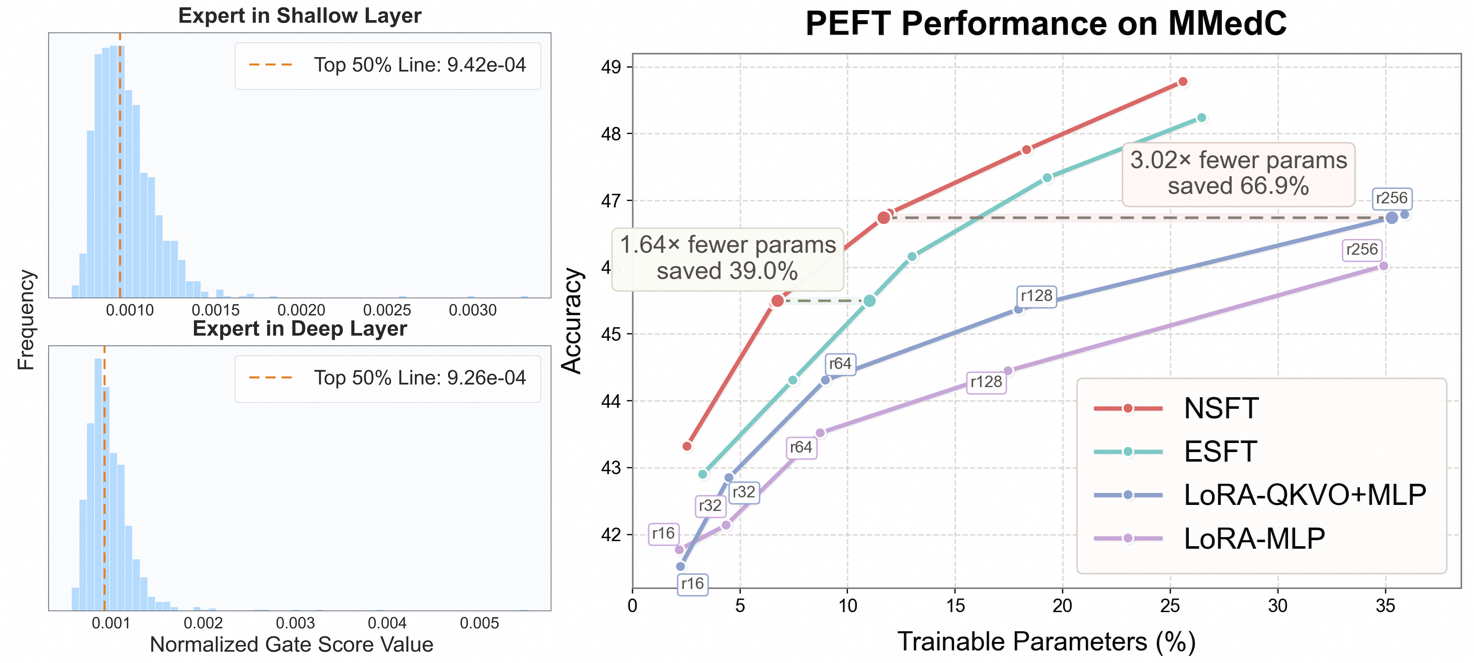
Модели с набором экспертов (MoE) можно донастраивать для новой предметной области, изменяя заметно меньшую часть их параметров. В работе Alibaba Group и Southeast University, которая пока не прошла рецензирование и приводит замеры самих авторов, метод NSFT сократил число обучаемых параметров до 66,9% относительно наиболее широкой конфигурации LoRA при сопоставимом или лучшем качестве. Для команд с уже выбранной MoE-моделью это меняет единицу донастройки: бюджет можно распределять точнее, чем на уровне целого эксперта.
Обычная разреженная донастройка выбирает экспертов, которые чаще включаются на целевых данных, и обновляет их целиком. NSFT делит промежуточные каналы каждого эксперта на небольшие последовательные группы — подэкспертов. Метод оценивает одновременно частоту выбора эксперта маршрутизатором и силу активации каналов внутри него, а затем обучает только группы с наибольшим совокупным вкладом.
У такого отбора возникает проблема: чем меньше каналов обновляется, тем слабее общий шаг обучения. NSFT увеличивает скорость обучения обратно доле выбранных каналов и отдельно усиливает градиенты наиболее значимых групп. Динамический вариант пересчитывает их значимость по ходу обучения, чтобы распределение обновлений следовало за изменениями модели.
Метод проверили на двух основах — OLMoE-7B и Ling-mini-2.0-16B. Набор задач охватывал медицину на нескольких языках, извлечение научной информации, RAG, математику, генерацию кода и ответы по таблицам. NSFT сравнивали с полной донастройкой, вариантами LoRA и ESFT, который выбирает целых экспертов; на этих условиях NSFT давал лучшее соотношение качества и числа обучаемых параметров и сохранял результаты на общих тестах.
Практический выбор здесь зависит от архитектуры основы. Если продукт уже использует MoE, подэксперты дают ещё один уровень контроля над расходами на адаптацию без дополнительных модулей LoRA. Для плотных моделей этот способ напрямую не подходит: он опирается на маршрутизацию и внутреннюю структуру экспертов.
Источники
Иллюстрация: рисунок из статьи «From Experts to Sub-experts: Fine-grained Parameter-Efficient Fine-Tuning for MoE LLMs», Zhentao Tan, Chang Liu, Yao Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


