
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Камера может передавать внешнему процессору не сырые кадры, а компактные признаки, которые нужны конкретной задаче. Хотя препринт не рецензирован и числа получили сами авторы, команда Chengwei Zhou сократила расчётную энергию всей системы в 2–4,5 раза. Такой подход переносит границу между камерой и ускорителем: вместо первых слоёв готовой нейросети на сенсоре работает специально обученный кодировщик.
Как кодировщик учат сохранять полезные признаки
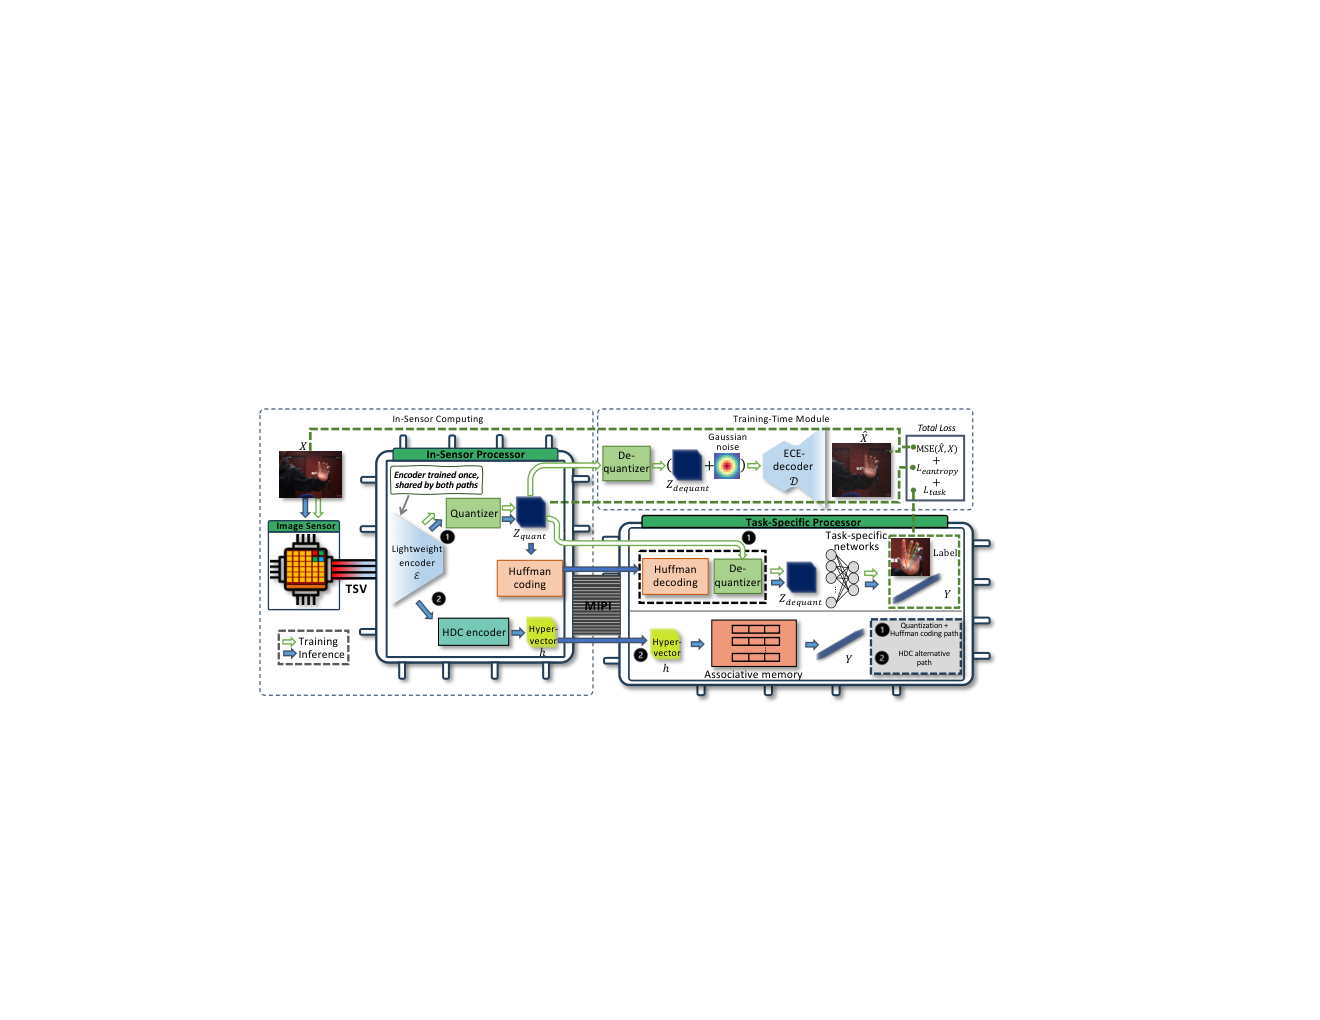
OASIS рассчитан на связку CMOS-сенсора с отдельным логическим кристаллом. Сенсор передаёт пиксели на этот кристалл по короткому внутреннему соединению, кодировщик уменьшает пространственный размер и число каналов, а компактное представление уходит внешнему процессору.
Авторы собрали компактные кодировщики на основе ResNet и SwinViT. Они раньше уменьшают разрешение признаков и сдерживают рост числа каналов, чтобы веса модели и промежуточные результаты помещались в локальную память. Это отличает OASIS от обычного разбиения нейросети по слоям: несколько перенесённых слоёв могут оставить на выходе большой массив и почти не снизить стоимость передачи.
Кодировщик обучают одновременно по трём целям. Первая сохраняет признаки, нужные для классификации или отслеживания. Вторая снижает энтропию: часто встречающиеся значения потом занимают меньше места. Третья заставляет отдельную ветвь восстанавливать исходное изображение и не даёт кодировщику слишком рано отбросить содержимое кадра.
Восстанавливающая ветвь нужна только при обучении и не попадает на сенсор. Во время обучения представление также пропускают через имитацию квантования и добавляют шум, чтобы модель привыкла к конечной точности вычислений. На устройстве остаются кодировщик и один из двух способов подготовить данные к передаче.
Карта признаков подходит для отслеживания, гипервектор — для классификации
Основной путь сохраняет пространственную структуру представления. Значения переводят в 4-битный формат, после чего кодирование Хаффмана назначает короткие коды частым значениям. Внешний процессор распаковывает поток и передаёт карту признаков прикладной сети.
Эта схема подходит не только для классификации. Отслеживание руки или глаза требует понимать, где находится объект, поэтому внешней модели нужна пространственная карта, а не единственная метка для всего кадра.
Второй путь рассчитан на классификацию. OASIS преобразует карту в двоичный гипервектор с помощью последовательности Соболя и передаёт его ассоциативной памяти. Та сравнивает вектор с прототипами классов, поэтому отдельный нейросетевой классификатор снаружи не нужен. Цена такого сокращения — потеря карты, необходимой задачам с координатами.
В конфигурации VWW на основе SwinViT переход от 128-компонентного гипервектора к 64-компонентному снизил точность менее чем на один процентный пункт. Итоговый объём передачи оказался в 18 816 раз меньше исходного кадра. Это крайняя точка компромисса: она выгодна, когда устройству нужен только ответ о наличии целевого объекта.
Работа меняет выбор точки разделения системы
OASIS проверяли на VWW, отслеживании руки и отслеживании глаза, используя кодировщики двух архитектур. Цифровую часть реализовали на AMD Xilinx Zynq UltraScale+ FPGA и измерили на плате; оценку всей системы дополнили схемными моделями сенсора и проекцией специализированного кристалла на техпроцесс 7 нм. Поэтому результат подтверждает исполнимость конвейера на FPGA, но итоговая экономия энергии частично опирается на моделирование будущей интегрированной системы.
Для продуктовой команды главный вывод состоит не в выборе нового кодека. OASIS требует совместно обучать сенсорный кодировщик и прикладную модель, а затем проектировать память, буферы и формат интерфейса вокруг полученного представления. Заменить передачу JPEG или сырых кадров без переобучения остального конвейера не получится.
Подход имеет смысл, если передачу кадров и внешние вычисления уже видно в энергетическом бюджете, а рядом с сенсором можно разместить программируемую логику или специализированный кристалл. Для классификации можно рассматривать гипервектор и ассоциативную память; для координат и масок придётся сохранить карту признаков и выбрать квантование с кодированием Хаффмана.
Работа также предлагает более полезный порядок проектирования. Сначала команда определяет, какая информация должна пересечь границу сенсора, затем обучает представление под задачу и только после этого распределяет вычисления между кристаллами. Это может дать больше, чем перенос первых слоёв существующей модели без изменения их выхода.
Источники
Иллюстрация: рисунок из статьи «Hardware-Aware Learned Representation Compression for Distributed In-Sensor Vision», Chengwei Zhou, Abu Masum, Xuming Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


