
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Политику управления научились улучшать по неидеальным видео, где не записаны команды, а небольшой размеченный фрагмент нужен только для перевода скрытых действий в физические. LAPIS сохранял работоспособность при разметке действий лишь для 1% данных, хотя препринт не рецензирован и числа получили сами авторы. Подход позволяет использовать записи неудачных и неоднородных траекторий, но только если оптимизация не выводит политику за пределы физически исполнимых переходов.
Почему хорошее скрытое действие нельзя просто выполнить
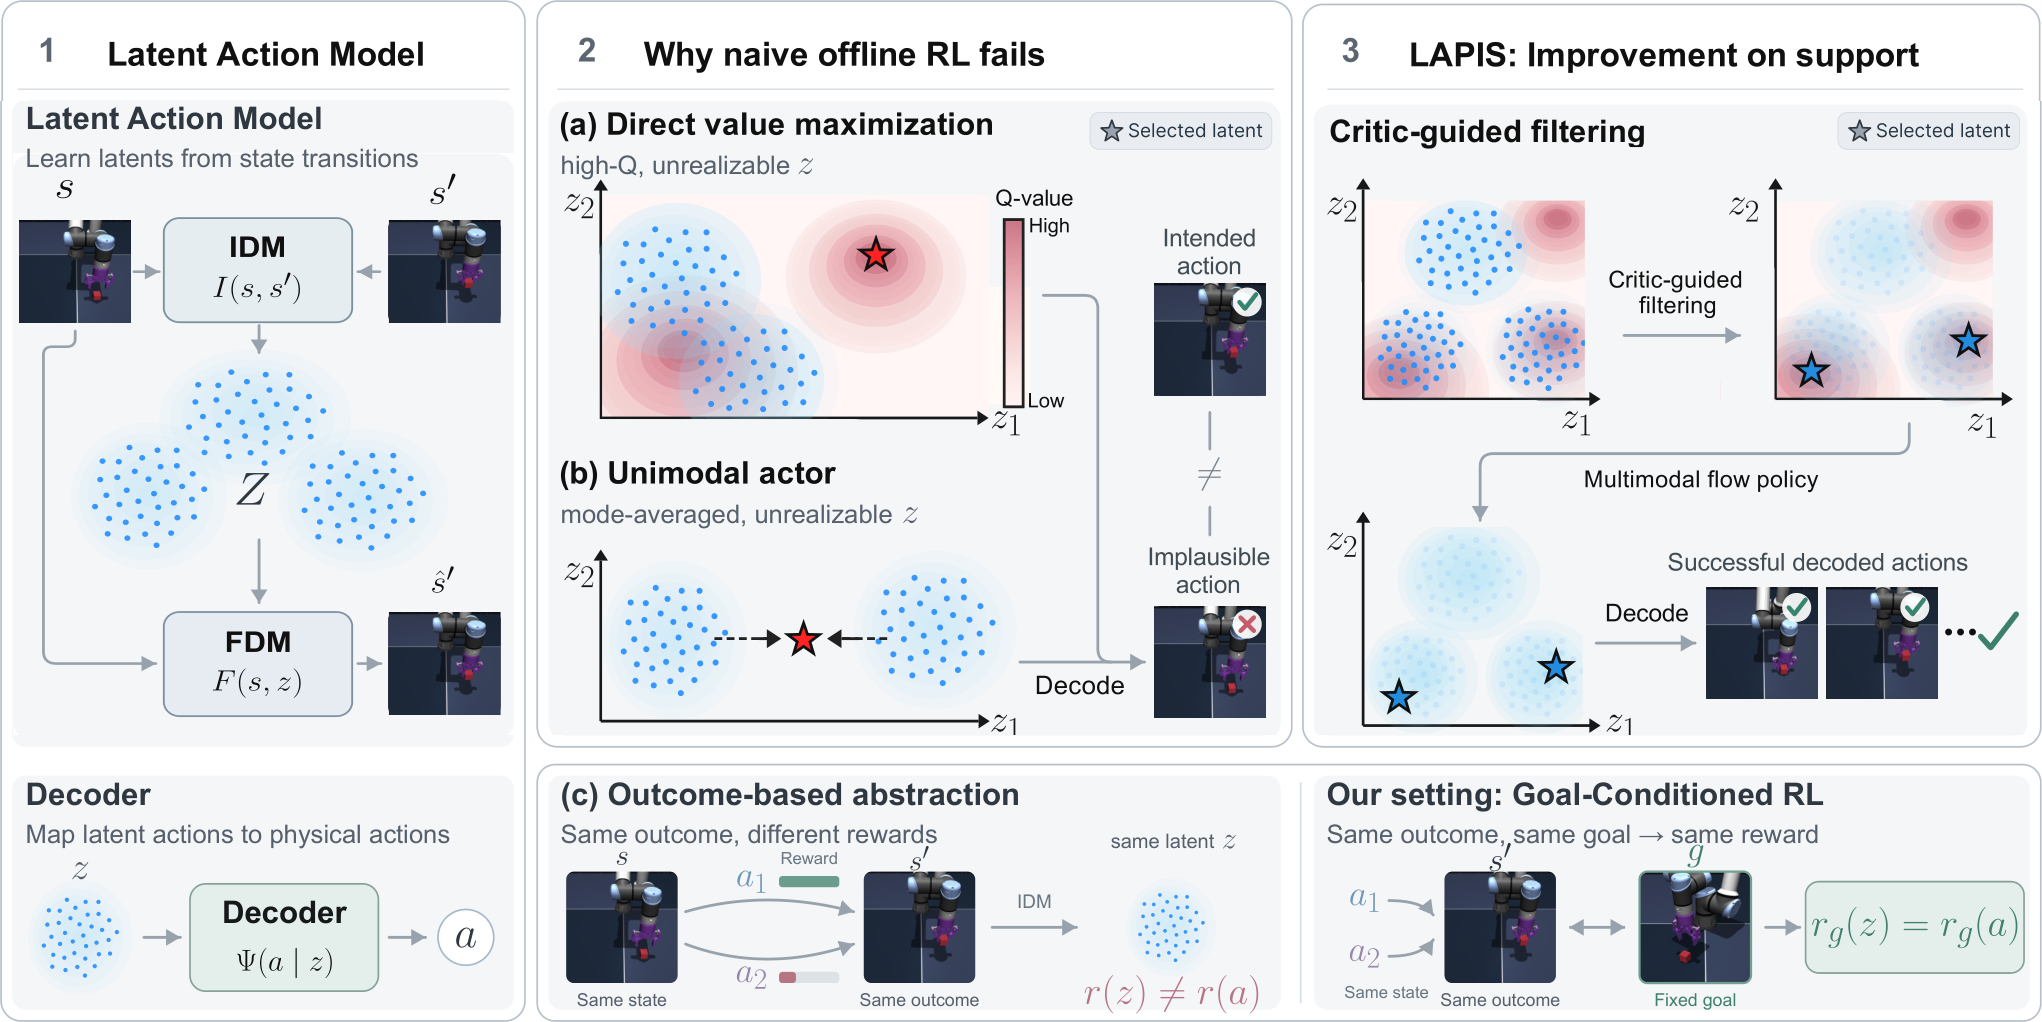
Модель латентных действий учится по парам состояний: видит сцену до и после перехода и кодирует изменение скрытым вектором. Затем декодер переводит этот вектор в физическую команду, опираясь на небольшую часть данных с записанными действиями.
Такой вектор описывает прежде всего результат перехода, а не движение привода. Один и тот же вектор может быть исполним в одном состоянии и недоступен в другом. В диагностике на задаче с кубом 73% попыток перенести известное латентное действие в другое состояние превысили порог ошибки реализации.
Множество исполнимых векторов также может быть невыпуклым. Если два скрытых действия по отдельности приводят к допустимым движениям, их среднее не обязано соответствовать какой-либо физической команде. Поэтому обычная политика с одним максимумом распределения способна выбрать точку между двумя рабочими вариантами и передать декодеру неисполняемый запрос.
Прямой поиск действия с максимальной оценкой создаёт похожую проблему. Модель-оценщик может присвоить высокий балл вектору вне наблюдаемой области, хотя декодер никогда не учился превращать его в корректное управление. Улучшение расчётной оценки тогда не переносится на робота.
Есть и отдельное расхождение целей. Два физических действия могут привести объект в одно состояние и получить один латентный код, но иметь разную награду — например, если она зависит не только от результата, но и от самой команды. Скрытое представление стирает это различие, поэтому лучшая латентная политика не всегда совпадает с лучшей физической.
LAPIS выбирает среди наблюдаемых переходов
Теоретическая часть работы задаёт условия, при которых улучшение переносится на исполнение. Политика должна выбирать только пары состояния и латентного действия, встречавшиеся в данных. Каждая такая пара должна однозначно задавать следующее состояние, динамика должна быть детерминированной, а декодер — воспроизводить наблюдаемый переход.
Чтобы совпадали не только оценки политик, но и их оптимумы, награда должна определяться исходным и следующим состояниями. Это подходит для целей вида «переместить объект сюда», но не покрывает задачи, где важны усилие, расход энергии или конкретная команда при том же результате.
LAPIS следует этим условиям практически, не максимизируя оценку по всему латентному пространству. Модель-оценщик проверяет переходы из набора данных и оставляет те, которые лучше соответствуют заданной цели. Политика затем учится на отфильтрованных примерах.
Для выбора действий используется условная потоковая модель. Она сохраняет несколько раздельных вариантов перехода вместо того, чтобы усреднять их в один вектор. Цель задаётся будущим состоянием, поэтому она согласуется с тем, что латентное действие кодирует результат движения.
На всех пяти задачах визуального управления OGBench LAPIS показал лучший результат среди методов в латентном пространстве при 5% размеченных действий. Преимущество сохранилось и при 1% разметки, когда конкурирующие методы в основном переставали решать задачи. В одной из проверок на управление кубом сочетание фильтра и потоковой политики достигло 62% успеха против 36% у фильтра с детерминированной политикой.
Эксперименты охватывают визуальное управление объектами, навигацию antmaze и Visual Franka Kitchen. Точные гарантии при этом относятся к детерминированной динамике и идеальному декодеру, который учитывает текущее состояние; практические модели работают с приближённым декодированием и конечным набором переходов.
Когда работа меняет архитектуру продукта
LAPIS меняет планы команд, у которых накоплено много видео, но мало записей команд управления. Такие данные больше не обязательно фильтровать до набора удачных демонстраций: неудачные траектории тоже показывают, какие переходы физически возможны. Небольшой размеченный набор можно направить на обучение декодера, а основную политику — на выбор более полезных переходов.
Работа также даёт критерий для выбора цели. Если качество продукта определяется состоянием после действия, оптимизация в латентном пространстве имеет теоретическое основание. Если награда зависит от силы, скорости, безопасности команды или других свойств самого управления, латентный код может скрыть критическое различие — тогда оценивать и улучшать нужно физические действия.
Ещё один практический вывод касается декодера. Теория предпочитает декодер, который учитывает и состояние, и латентный код, но в экспериментах при дефиците разметки более простой декодер только по коду работал лучше во всех трёх проверенных семействах задач. Усложнять его заранее не стоит: дополнительный вход помогает лишь тогда, когда размеченных команд достаточно.
Метод не открывает безопасный поиск произвольных действий вне данных. Его сильная сторона обратная: он улучшает политику, оставаясь рядом с наблюдаемыми переходами и сохраняя несколько физических вариантов. Для продукта это означает более консервативный план — сначала проверить покрытие состояний в записях, затем обучить декодер и только после этого усиливать отбор по цели.
Источники
Иллюстрация: рисунок из статьи «Latent Action Policies from Suboptimal Data», Donghyeon Ki, Xiaoyu Chen, Jun Ho Seo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


