
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Офлайн-траектории научились превращать в карту состояний, из которых агент может добиться особенно разных исходов, не запуская его в среде. В работе UC Berkeley и Princeton University, которая не прошла рецензирование и где числа получили сами авторы, такая карта улучшила онлайн-обучение в пяти сочетаниях задач и наборов данных, а в остальных не ухудшила результат. Для команд с накопленными логами это предлагает новый способ подготовить стратегию исследования до дорогих запусков робота или программного агента.
Карта отделяет развилки от тупиков
Авторы оценивают меру контроля над будущим (empowerment): насколько разные состояния агент способен получить из текущей точки, выбирая разные последовательности действий. В тупике она низкая, поскольку почти любое действие ведёт к одному исходу. Возле ключа, мяча или развилки она выше: агент получает несколько заметно разных продолжений.
Эта величина отличается от обычного бонуса за новизну. Новизна побуждает посещать редкие состояния независимо от их дальнейшей ценности. Мера контроля выделяет состояния, из которых открывается больше вариантов поведения, даже если агент уже видел их в старых данных.
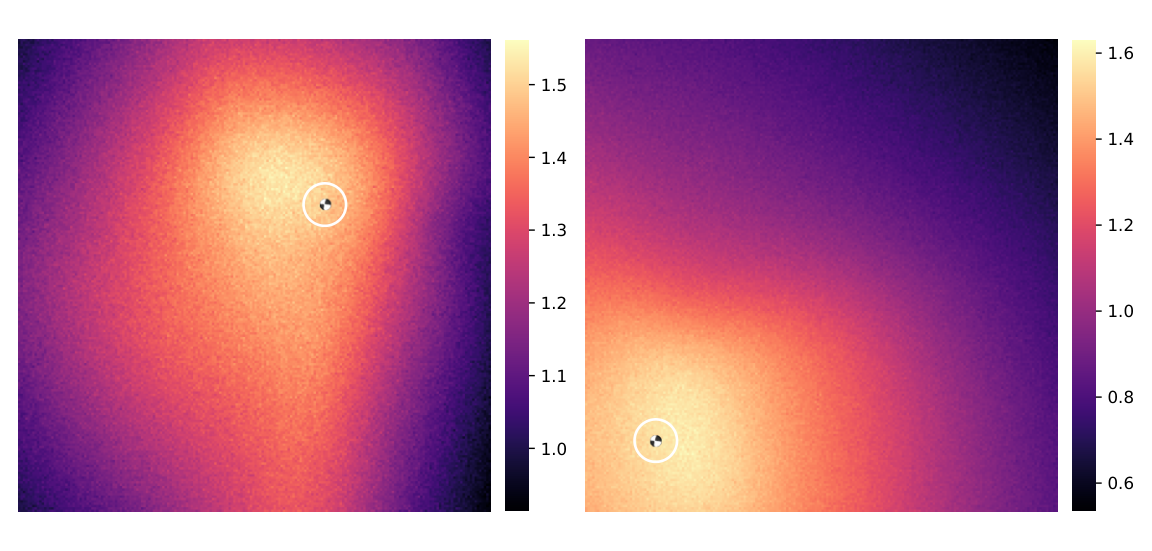
Полученные карты совпали со структурой тестовых сред. В AntMaze оценка росла на пересечениях коридоров и снижалась в углах и тупиках. В PointMaze-Teleport она резко падала у входа в односторонний телепорт: после перехода агент почти не контролировал следующее состояние.
В Ant-Soccer максимум возникал рядом с мячом, где агент мог подойти, отойти или начать вести его. Сразу после удара оценка падала, пока мяч катился вне досягаемости. В задаче с манипулятором она росла при захвате куба, но снижалась, когда робот держал его в воздухе: захват приходилось сохранять, поэтому доступных действий становилось меньше.
Будущие состояния восстанавливают по отдельным переходам
Исходные данные — фиксированный набор переходов между состояниями, собранный неизвестной стратегией. Разметка целей, наград и намерений агента не нужна. Обычные методы оценки контроля требуют запускать отдельные варианты стратегии в среде и сравнивать их исходы; предложенный алгоритм пытается восстановить их по уже записанным траекториям.
Для этого он совместно обучает стратегию с несколькими скрытыми вариантами поведения и модели распределения будущих состояний. Модели получают отдельные переходы и через рекуррентное уравнение связывают текущую точку со всеми последующими: близкие состояния получают больший вес, далёкие — меньший. Так алгоритм оценивает, куда привёл бы каждый вариант поведения, хотя в наборе данных его целиком может не быть.
Будущие состояния кодируются как точки в общем скрытом пространстве. Если разные варианты поведения ведут в хорошо различимые области, текущему состоянию присваивается высокая мера контроля. Одновременно стратегия учится разводить эти исходы, но штраф за отклонение от записанных действий не позволяет ей свободно опираться на переходы, которых нет в данных.
Простая адаптация прежних оценок к офлайн-режиму дала менее убедительные карты. Четыре сравниваемых метода либо насыщались почти одинаковым значением на большей части среды, либо показывали шумную крупномасштабную картину, либо становились нестабильными. Новый метод тоже не знает истинную максимальную меру контроля: в непрерывной среде её нельзя практически перебрать, поэтому качество карты проверяли по ожидаемой структуре задач и пользе в дальнейшем обучении.
Менять архитектуру продукта рано, эксперимент — уже стоит
После офлайн-обучения оценщик заморозили и добавили его значение как вспомогательный бонус к онлайн-стратегии достижения целей. Бонус направлял агента в области с большим числом возможных продолжений, а затем постепенно исчезал к середине обучения, чтобы итоговую стратегию определяла целевая награда.
Проверка охватывала OGBench: навигацию муравья по лабиринту, лабиринт с телепортами, футбол с мячом и перенос куба манипулятором. Во всех случаях награда была редкой, а цель менялась. Офлайн-наборы различались по качеству: от длинных целевых траекторий до коротких фрагментов, шумных действий и случайных блужданий.
Бонус улучшил скорость обучения и итоговую долю успешных попыток в пяти сочетаниях среды и набора данных. В остальных сочетаниях он остался на уровне базовой стратегии. Его также удалось добавить к RND, который поощряет новизну, и к SUPE, который заранее обучает скрытые варианты поведения; на части задач сочетания учились быстрее исходных методов.
Работа не требует немедленно менять основной алгоритм RL. Она даёт проверяемую гипотезу для систем, где онлайн-взаимодействие дорого, а исторические траектории уже накоплены: сначала построить по логам карту управляемости, затем использовать её как временный бонус при дообучении. Пока основание ограничено непрерывным управлением в симуляторах OGBench, поэтому перенос на физического робота или агента для работы с кодом потребует отдельного эксперимента.
Источники
Иллюстрация: рисунок из статьи «Measuring Empowerment from Offline Data for Intrinsically Motivated Exploration», Ishir Garg, Vivek Myers, Qiyang Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


