
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Неразмеченный поток текстов научились сжимать в несколько синтетических примеров для регулярного дообучения языковой модели. Команда Upwork назвала метод OLGA: при памяти всего из пяти примеров он повысил точность на 10 процентных пунктов относительно сильнейшего отбора реальных текстов, хотя препринт не рецензирован и эти числа получили сами авторы. Подход позволяет обновлять модель на новых данных, не сохраняя и не перерабатывая всю историю.
Как модель заменяет разметку собственными прогнозами
Обычное сопоставление градиентов требует размеченных примеров. Для каждого текста метод вычисляет вектор изменений весов, который возник бы при обучении, а затем создаёт небольшой синтетический набор с похожим вектором. Такой набор может передать сигнал множества исходных текстов, но без правильных ответов вычислить целевой градиент обычно нельзя.
OLGA берёт цель из прогнозов самой замороженной модели. Сначала тексты делят на группы по метаданным или с помощью кластеризации. Затем для каждой группы находят токены, которые модель ожидает в ней чаще, чем во всём наборе, и строят из их вероятностей мягкую цель: модель должна приблизиться не к одному заданному классу, а к распределению характерных продолжений.
Синтетический текст оптимизируют так, чтобы его градиент совпал по направлению с градиентом исходной группы. Поскольку токены нельзя менять малыми непрерывными шагами, OLGA временно работает с их числовыми представлениями, а затем возвращает результат к ближайшим токенам словаря. На выходе остаются читаемые последовательности, а не внутренние векторы, привязанные к одной архитектуре.
Для потока данных метод хранит синтетическую память. Каждый новый блок сначала сжимается отдельно, после чего его результат объединяется с прежней памятью и снова ужимается до заданного бюджета. Поэтому объём памяти не растёт вместе с историей, а стоимость очередного шага зависит от нового блока и текущего буфера, а не от всех ранее полученных текстов.
Синтетическая память выигрывает при жёстком сжатии
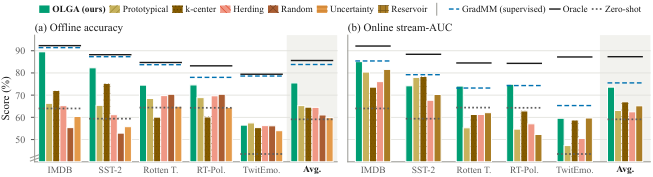
В потоковом сценарии OLGA обошёл сильнейший метод, который сохраняет реальные примеры, на 6,6 процентного пункта по площади под кривой качества. Эта метрика учитывает точность после каждого обновления и показывает, насколько стабильно память работает по мере поступления данных, а не только в конце потока.
Для крупных наборов авторы добавили двухступенчатую схему. Сначала простой отбор сокращает входной блок, затем более дорогая синтезация превращает остаток в несколько примеров. Такая схема сократила время работы на 30% относительно прямого сжатия при близкой точности.
Гибридный вариант также обошёл лучший конвейер, который только отбирал реальные тексты, на величину до 12,6 процентного пункта. Разделение ролей здесь существенно: отбор подходит для первого умеренного сокращения, а синтетические примеры дают преимущество на последнем этапе, когда в памяти остаются единицы текстов.
Когда OLGA меняет план обновления модели
OLGA стоит учитывать, если продукт получает много неразмеченных обращений, а модель приходится регулярно подстраивать под новые темы или предпочтения. Для внедрения понадобятся устойчивый способ группировать входные тексты, замороженная базовая модель для расчёта целей и отдельный цикл, который строит синтетическую память до основного дообучения.
Метод не отменяет обычный отбор данных при более свободном бюджете. Когда память увеличили до десяти примеров, преимущество OLGA сократилось до 1,7 процентного пункта, причём он лидировал лишь на двух наборах. Практичный конвейер поэтому может сначала выбирать реальные данные, а синтезацию включать только там, где хранение или повторное обучение требуют предельно малого набора.
Проверка охватывает phi-1.5 и пять открытых наборов для классификации отзывов и эмоций. Сравнение способов обновлять память проводили на потоке из пяти блоков. Эти условия подтверждают идею для компактных классификаторов, но пока не показывают тот же эффект на более крупных моделях и задачах со свободной генерацией.
Синтетические тексты заимствуют фразы из исходных примеров и могут переносить их смещения. Поэтому такую память следует проверять как отдельный обучающий набор, а не считать автоматически очищенным представлением пользовательского потока. OLGA меняет прежде всего архитектуру конвейера: вместо архива всей истории появляется небольшой обновляемый набор, но контроль его состава остаётся частью эксплуатации.
Источники
Иллюстрация: рисунок из статьи «Online Label-Free Gradient Matching for Continual Language Model Training», Sajjad Pakdamansavoji, Mohammad Reza Rezaei, Ilija Subasic и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


