
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
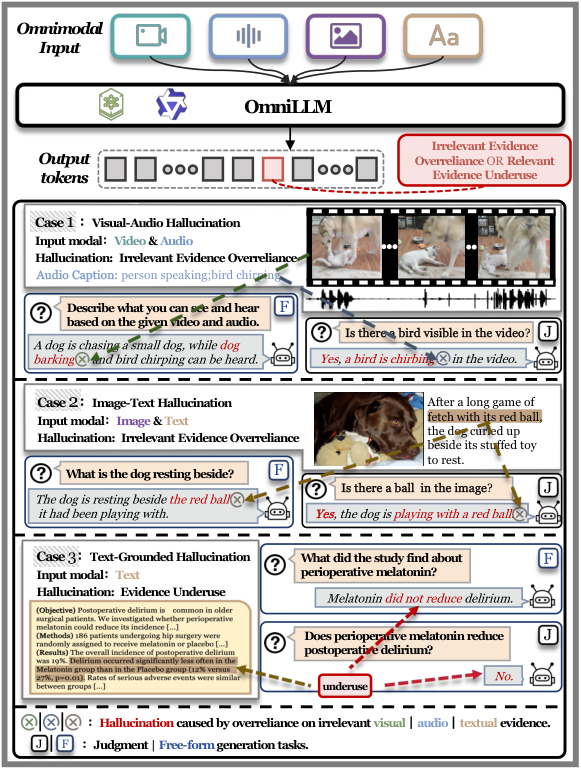
Мультимодальную модель научили проверять, на какие входные данные опирается каждый фрагмент ответа, а затем исправлять места, поддержанные не тем каналом. В работе OmniConfess, которая не прошла рецензирование, а все числа в ней получили сами авторы, средний F1 на основной модели вырос с 54,8 до 65,1; эта метрика объединяет точность и полноту в одну оценку. Метод не требует дообучения, но добавляет повторные прогоны модели во время ответа.
Как токен связывают с изображением, аудио или текстом
Обычная проверка после генерации показывает, верен ли ответ, но не объясняет, какие входные данные его поддержали. Если заново запустить модель без изображения или аудио, она построит уже другую последовательность: изменится начало ответа, а вслед за ним — весь последующий контекст. Тогда влияние канала смешается с влиянием новой формулировки.
OmniConfess сначала генерирует кандидатный ответ и фиксирует его вместе со всеми префиксами. Затем метод по очереди убирает каждый канал — например, изображение, звук или извлечённый текст — и повторно оценивает вероятность тех же токенов. Модель ничего не дописывает на этом этапе: она отвечает, насколько правдоподобной осталась уже выбранная последовательность.
Для каждого токена метод сравнивает вероятность выбранного варианта с вероятностью фиксированной альтернативы. В задаче классификации альтернативой служит другой класс, а в свободном ответе — следующий по вероятности токен. Разница показывает, какой канал усилил конкретное утверждение, какой почти не повлиял и какой подтолкнул модель в неверную сторону.
Из этих оценок складывается «признание» — таблица зависимостей между токенами и каналами. Правила задачи заранее отмечают, какие каналы релевантны вопросу. Поэтому одинаково высокая зависимость от изображения может считаться полезной при вопросе о предмете в кадре и подозрительной, если ответ должен основываться только на аудио.
Такая детализация нужна не только для объяснения результата. Самые чувствительные 20% токенов собрали 82% всей измеренной зависимости от входных данных. Проверка на уровне целого ответа размазывает этот сигнал и не показывает, какой фрагмент следует менять.
Для коротких решений OmniConfess пересчитывает оценку выбранного класса с учётом релевантных и нерелевантных каналов. В свободном тексте метод отмечает рискованные токены, расширяет их до границ слов и заново генерирует только получившиеся фрагменты. Остальной ответ сохраняется, поэтому исправление не запускает полную переформулировку.
Метод проверяли на OmniHalluBench из 3 540 примеров, собранных из шести наборов данных. В тесты вошли классификация и свободная генерация по тексту, изображениям, аудио и видео, включая противоречия между каналами. В качестве основы использовали три модели: Qwen2.5-Omni-7B, Qwen3-Omni-30B-A3B и Nemotron-3-Nano-Omni-30B.
Где исправление оказалось полезнее обычного декодирования
На Qwen2.5-Omni-7B OmniConfess обошёл все сравниваемые методы по каждому набору данных и всем основным метрикам. Средний F1 поднялся с 54,8 у исходной модели до 65,1. Улучшение проявилось и в задачах выбора ответа, и в свободной генерации, где оценивали совпадение токенов и фактическую точность с помощью модели-оценщика.
На остальных архитектурах результат тоже улучшился: минимальный прирост среднего F1 составил 6,34 пункта. Это существенно для метода без изменения весов, поскольку плотная модель, смесь экспертов и гибридная архитектура по-разному распределяют вычисления, но здесь не потребовали отдельных вариантов алгоритма.
Разбор компонентов подтвердил, что одной диагностики недостаточно. Фиксация исходного ответа помогала отделить влияние данных от изменения траектории генерации, а проверка каналов точнее находила источник ошибки. Самый большой спад произошёл, когда найденные места перестали исправлять: таблица зависимостей полезна только вместе с действием над ответом.
Дополнительная оценка людьми и GPT-4o показала тот же профиль: ответы лучше опирались на предоставленные данные, реже содержали фактические ошибки и точнее выражали неопределённость. При этом связность и ясность текста не ухудшились относительно сильнейших вариантов сравнения.
Когда OmniConfess меняет архитектуру продукта
Работа меняет планы команд, которые уже используют мультимодальную модель и могут управлять её запуском. Вместо отдельного классификатора галлюцинаций или дообучения можно добавить этап после первой генерации: зафиксировать ответ, повторно оценить его без отдельных каналов и переписать только подозрительные места.
Для этого нужен доступ к вероятностям токенов и возможность повторно прогонять модель с изменённым набором входных данных. API, который возвращает только готовый текст, для прямой реализации метода не подходит. Также придётся формализовать релевантность каналов для каждого типа задачи: алгоритм должен знать, разрешено ли опираться на изображение, звук или извлечённый контекст.
Цена такой проверки — задержка. В аудиовизуальной задаче CMM ответ формировался примерно на 70% дольше исходной модели, хотя итоговый текст оставался коротким. Основное время заняло не создание новых токенов, а повторная оценка одной последовательности при поочерёдном исключении каналов.
Поэтому OmniConfess лучше подходит для ответов, где ошибка дороже дополнительного прогона: проверки документов, анализа медицинского контекста или решений по противоречивым источникам. Для поточной обработки с жёстким пределом задержки практичнее сначала запускать метод только на рискованных запросах либо на задачах с небольшим числом каналов.
Источники
Иллюстрация: рисунок из статьи «OmniConfess: Eliciting Token Confessions to Mitigate Omni-Modal Hallucination», Huiqiang Rong, Haoran Luo, Hui Feng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


