
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Из моделей со смесью экспертов научились удалять лишние экспертные блоки так, чтобы сократить их объём и сохранить большую часть качества. Хотя препринт HKUST не рецензирован и числа получили сами авторы, Qwen3-30B-A3B после удаления половины экспертов сохранил 93,3% исходного результата. Схема даёт командам ещё один вариант между запуском полной MoE-модели и переходом на модель меньшего размера.
Эксперта выбирают по тому, что осталось восстановить
В MoE-модели маршрутизатор направляет каждый токен только в часть экспертных блоков. Это сокращает вычисления, но все веса экспертов всё равно приходится хранить в памяти. Удаление экспертов решает эту проблему, если оставшиеся блоки достаточно точно воспроизводят выход исходного слоя.
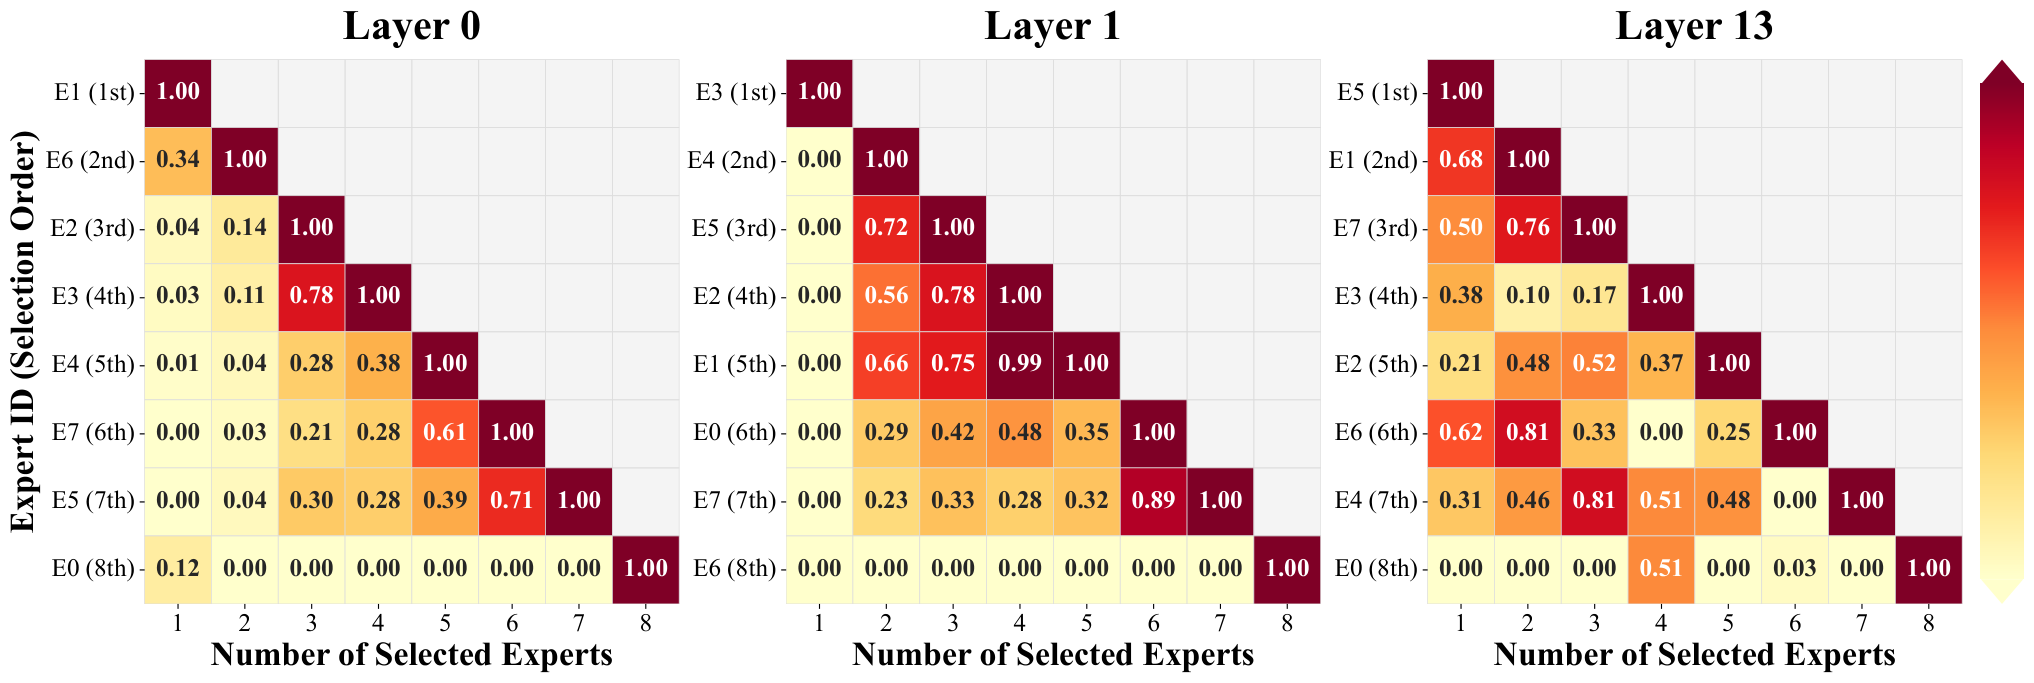
Простой подход ранжирует экспертов один раз — например, по частоте вызовов — и удаляет нижнюю часть списка. OMP-MoE учитывает, что важность эксперта зависит от уже выбранного набора. Два блока могут по отдельности выглядеть полезными, но воспроизводить почти один и тот же фрагмент выхода.
Сначала через калибровочные данные проводят один прямой проход и сохраняют полный выход каждого MoE-слоя, а также взвешенный вклад каждого эксперта. Затем алгоритм начинает с пустого набора и на каждом шаге добавляет блок, который сильнее всего уменьшает разницу между полным выходом и уже собранным приближением.
После выбора эксперта остаток пересчитывается, поэтому следующий блок оценивают уже относительно новой ошибки. Такой жадный поиск не перебирает все сочетания и на каждом шаге растёт линейно с числом кандидатов. Дообучать модель или вычислять матрицы вторых производных не требуется.
Бюджет распределяют между слоями и входными токенами
Одинаковое сокращение каждого слоя даёт слабый результат: в одних слоях эксперты во многом дублируют друг друга, а в других каждый оставляет заметный след. OMP-MoE строит для каждого слоя кривую ошибки и применяет «пошаговое заполнение бюджета» (water-filling).
Сначала каждому слою оставляют минимальный набор. Каждый следующий эксперт достаётся тому слою, где он сильнее всего уменьшает ошибку. При распределении учитывается и доля весов маршрутизатора, сохранённая выбранными экспертами: после удаления блоков маршрутизатор перенормирует веса, и хорошее восстановление выхода на калибровочных данных само по себе не гарантирует устойчивого поведения.
Статическое сокращение уменьшает объём весов, но не всегда даёт пропорциональное ускорение. Поэтому вариант OMP-MoE† дополнительно меняет число вызываемых экспертов для каждого токена. Во время калибровки он оценивает типичный масштаб выхода каждого блока, а при запуске объединяет эту оценку с весом маршрутизатора и пропускает вклад с низкой ожидаемой энергией.
Механизм выполняет минимальный набор вызовов, который укладывается в заданный порог остаточной энергии. Простые входы могут пройти через меньшее число экспертов, а сложные сохраняют больше вычислений. Это отдельная оптимизация: удаление экспертов экономит память постоянно, а OMP-MoE† сокращает вычисления в зависимости от входа.
Планы меняются для команд с доступом к весам и маршрутизатору
Схему проверяли на Qwen3-30B-A3B, DeepSeek-V2-Lite, GPT-OSS-20B и Mixtral-8×7B. Эксперименты охватывали общеобразовательные и логические задачи без дополнительного обучения, а доля удалённых экспертов составляла от четверти до половины. Это проверка нескольких распространённых архитектур MoE, но не всех доменов и режимов обслуживания.
Поиск набора для Qwen занял 641 секунду и оказался в 33 раза быстрее NAEE — метода, который оценивает сочетания экспертов. На DeepSeek-V2-Lite адаптивное выполнение дало ускорение всего процесса в 1,46 раза. Практический выигрыш здесь зависит не только от числа пропущенных блоков: среда запуска должна уметь превращать динамический пропуск экспертов в меньшую задержку.
Для команды, которая собиралась брать MoE-модель только после расширения GPU-парка, OMP-MoE добавляет промежуточный этап: сначала можно откалибровать модель на данных нужного домена, удалить избыточные блоки и измерить качество на собственных сценариях. Работа показывает, что небольшого калибровочного набора может хватить, но его предметная область влияет на итог.
Схема относится именно к моделям, где доступны веса, выходы экспертов и маршрутизатор. В плане внедрения статическое сокращение стоит оценивать отдельно от OMP-MoE†: первое отвечает за размещение модели в памяти, второе — за задержку и стоимость обработки. Если среда плохо исполняет разное число экспертов для разных токенов, адаптивная часть может не окупить дополнительную сложность, даже когда число операций уменьшается.
Источники
Иллюстрация: рисунок из статьи «OMP-MoE: Efficient Expert Pruning for Mixture-of-Experts LLMs via Orthogonal Matching Pursuit», Dezhi Li, Lujun Li, Qiyuan Zhu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


