
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM для потока запросов научились выбирать по ограниченному набору эталонных ответов, не размечая поток подряд. В препринте TU Delft и ETH Zurich, который не прошёл рецензирование, а числа получили сами авторы, Online LLM Picker потребовал до 71,67% меньше разметки, чем лучший из сравненных методов. Для продуктовой команды это меняет контур оценки: выбор модели можно обновлять по входящим запросам, а не фиксировать после отдельного бенчмарка.
Какие запросы Online LLM Picker отправляет на разметку
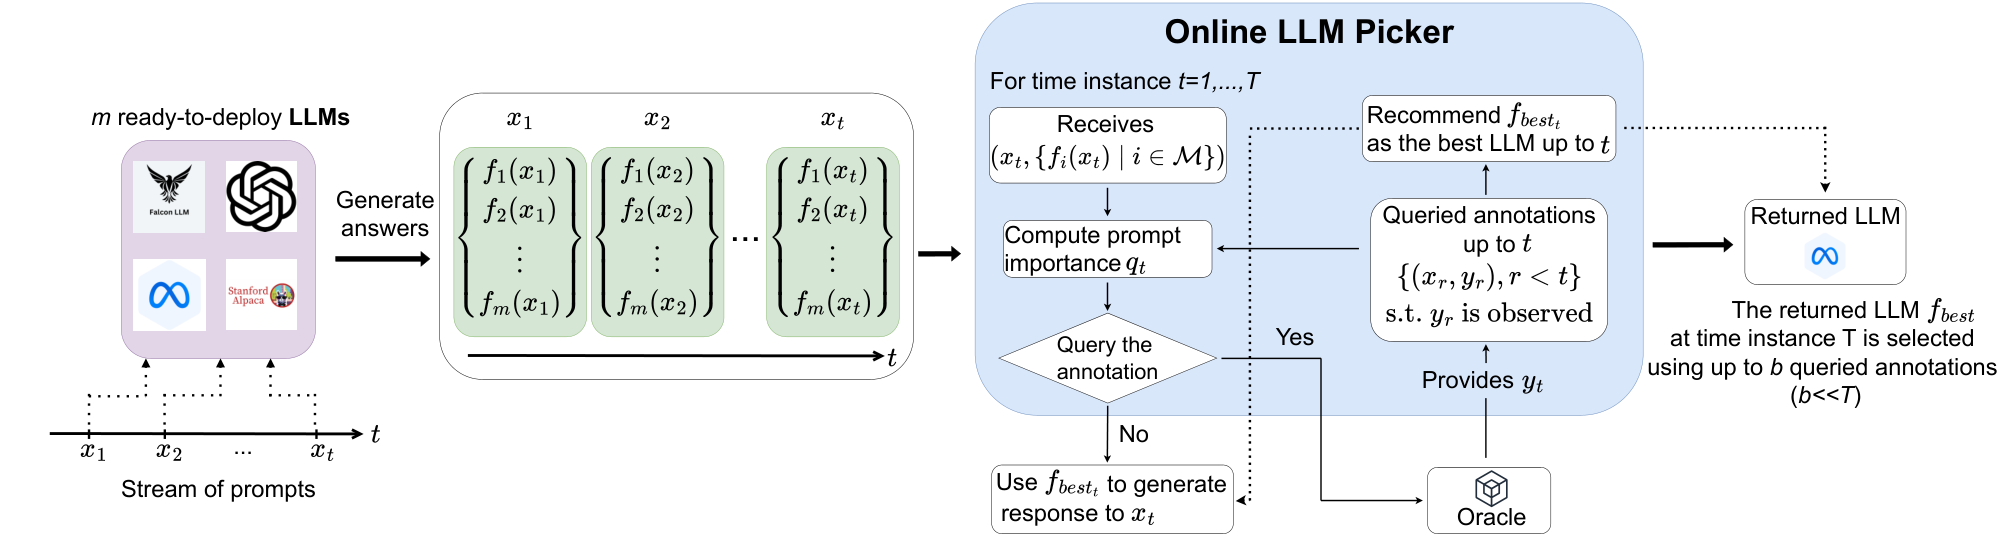
На каждом шаге метод получает очередной запрос и ответы всех моделей-кандидатов. Эталонного ответа пока нет, поэтому Online LLM Picker сравнивает ответы моделей друг с другом и ищет запросы, на которых кандидаты расходятся сильнее.
Одного расхождения недостаточно. Метод также хранит распределение вероятностей: насколько каждая модель похожа на лучшую для всего потока. Если почти вся вероятность уже сосредоточена на одном кандидате, очередная разметка слабо повлияет на выбор. Если несколько моделей остаются близки, тот же запрос становится ценнее.
Вероятность запросить эталонную разметку складывается из двух сигналов. Первый отражает разброс попарных различий между ответами, второй — энтропию текущего распределения, то есть степень неопределённости между кандидатами. Запрос с похожими ответами обычно пропускается, а запрос, способный изменить расстановку моделей, чаще отправляется оценщику.
После получения эталонного ответа метод измеряет потери каждой модели через ROUGE-L или BERTScore. Первая метрика оценивает совпадение последовательностей текста, вторая — близость смысла через представления слов. Затем Online LLM Picker обновляет веса кандидатов и сильнее учитывает редко запрошенные примеры, чтобы выборочная разметка не исказила итоговую оценку.
Темп обновления зависит от сглаженного разброса потерь на уже размеченных запросах. Это защищает оценку от резкого сдвига после одного необычного примера. На каждом шаге метод возвращает одну модель, которую считает лучшей для потока к этому моменту.
Где активный отбор выиграл у случайной разметки
Эксперименты охватили десять наборов данных и коллекции, в которые вместе вошло более 130 языковых моделей. Проверяли ответы на вопросы, исправление грамматики, арифметику и задачи по математическому анализу. Потоки строили независимой равномерной выборкой из тестовых наборов, а качество считали по совпадению с готовыми эталонными ответами.
Online LLM Picker сравнили со случайной разметкой и тремя активными стратегиями. Они выбирали запросы по расхождению моделей, дивергенции распределений или неопределённости ответов. Для каждого бюджета параметры настраивали так, чтобы методы в среднем запрашивали одинаковое количество эталонов.
При последовательной генерации накопленный проигрыш сократился максимум в 2,51 раза относительно лучшей альтернативы. Этот показатель сравнивает ответы модели, выбранной на текущем шаге, с результатом кандидата, который оказался бы лучшим после разметки всего потока. Чем раньше метод находит подходящую модель, тем меньше ошибок успевает накопиться.
При поиске не строго лучшей, а близкой к ней модели экономия доходила до 70,69%. Результат зависел от задачи: на Grammar Correction выигрыш при самом строгом пороге составил лишь 0,67%, а в одном режиме Calculus Dataset метод запросил на 28% больше разметки, чем лучшая альтернатива. Максимум из абстракта поэтому нельзя переносить на любой поток как ожидаемое значение.
Разметку можно сократить, но вычисления остаются
Работа меняет планы команд, которые регулярно сравнивают фиксированный набор LLM на собственном трафике. Вместо случайной выборки запросов можно сохранять ответы кандидатов, оценивать их расхождение и отдавать экспертам только те случаи, которые способны поменять выбор. Такой контур подходит для повторной проверки модели после изменения состава запросов.
Online LLM Picker выбирает одну лучшую модель для потока, а не направляет каждый запрос отдельному кандидату. Он решает задачу оценки и выбора, но не заменяет маршрутизатор, который подбирает модель под конкретный запрос с учётом цены, задержки или доступности.
Экономия на разметке также не означает экономию на инференсе. Чтобы решить, нужен ли эталон, метод сначала получает ответы всех рассматриваемых моделей. При платных API или большой локальной коллекции стоимость этих прогонов нужно сопоставить со стоимостью экспертной проверки.
Доказательная база относится к случайно перемешанным потокам из готовых тестовых наборов. Качество там задают эталонный ответ и текстовая метрика, поэтому в продукте потребуется собственный проверяемый сигнал: экспертная оценка, результат выполнения задачи или другая мера, которая отражает бизнес-требование. Если такой сигнал уже собирается, Online LLM Picker предлагает способ тратить его прежде всего на спорные запросы.
Источники
Иллюстрация: рисунок из статьи «Which LLM to pick? Online Active Model Selection for Large Language Models», Alessandro Turrin, Patrik Okanovic, Torsten Hoefler и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


