
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Появился инструмент onPanda, который помогает быстрее готовить ответы LLM для дообучения, сохраняя основную часть текста за моделью. Хотя препринт не рецензирован и числа получили сами авторы, в небольшом опыте такой процесс занял почти вдвое меньше времени, чем ручное редактирование готового ответа. Для команд, которые собирают собственные данные текущей модели (on-policy), это возможная замена построчной правке и выбору лучшего из нескольких ответов.
Как исправление одного токена превращается в обучающие данные
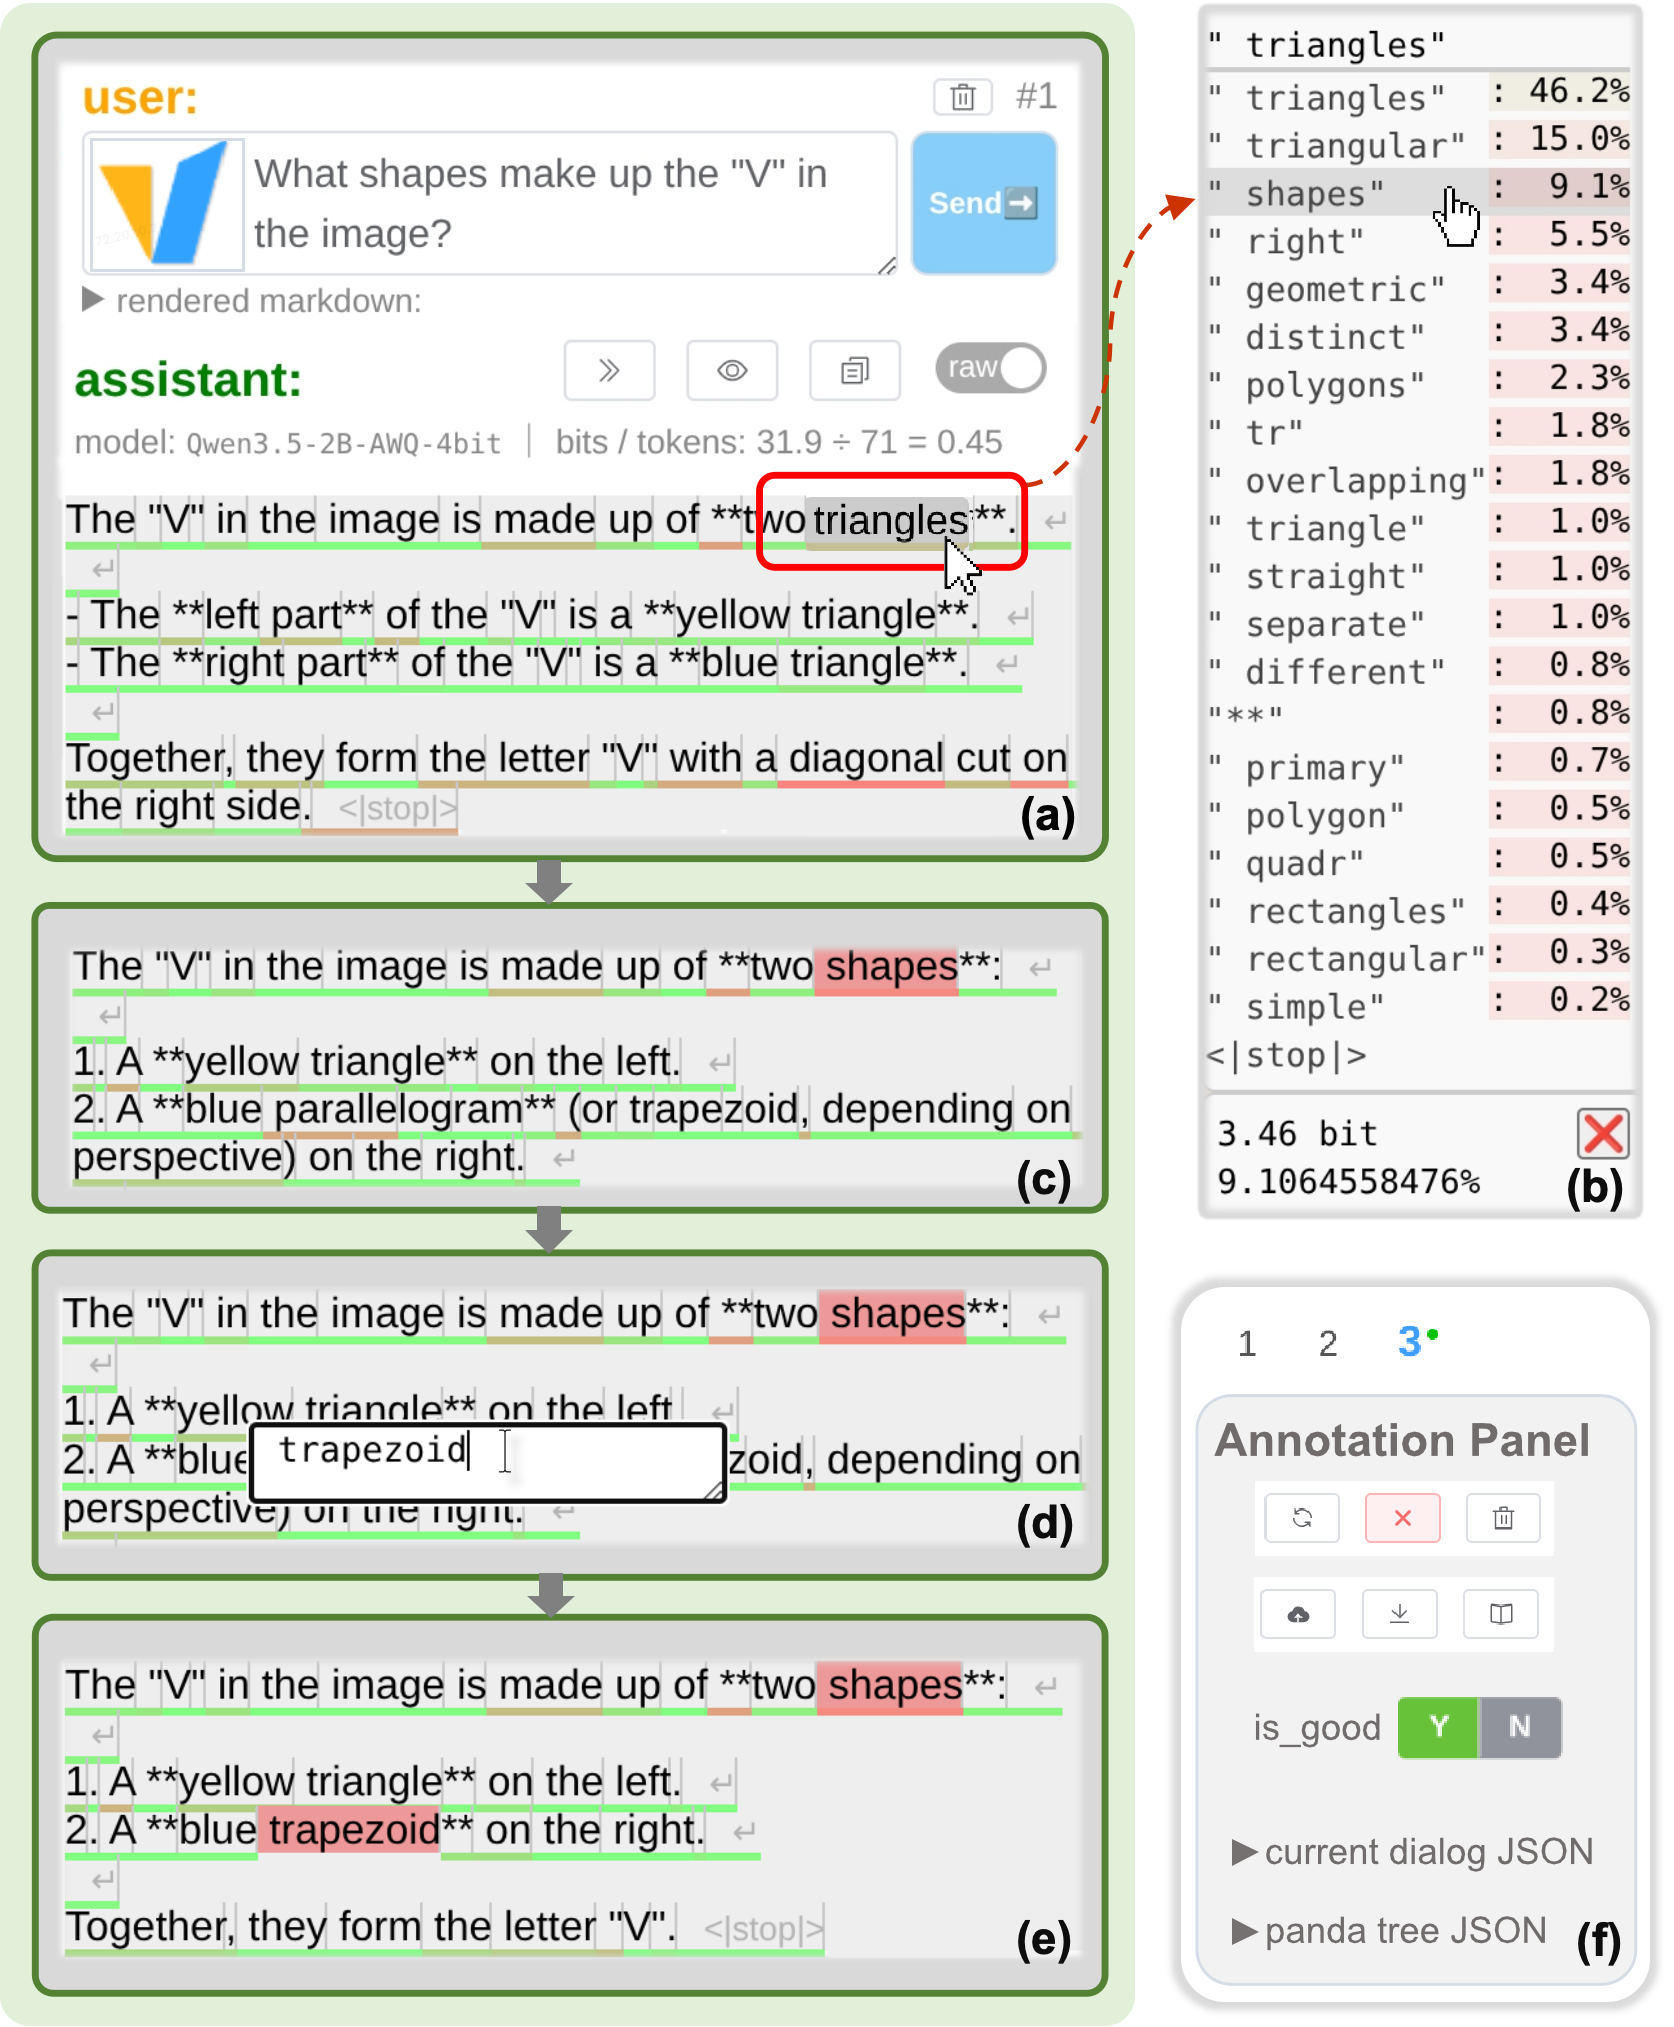
Разметчик читает ответ до первой ошибки и указывает токен, с которого модель пошла не туда. onPanda показывает до 20 альтернатив, которые модель рассматривала в этой позиции, вместе с их вероятностями. Подходящую замену можно выбрать мышью; если её нет, разметчик вводит нужный текст вручную.
После замены система удаляет весь последующий фрагмент и просит ту же модель продолжить ответ с исправленного префикса. Разметчик снова читает текст до первой проблемы и повторяет цикл. Он не исправляет все следствия ранней ошибки: модель сама перестраивает продолжение с учётом нового контекста.
Каждое исправление создаёт новую версию диалога. Финальный ответ становится примером для дообучения на эталонных ответах — SFT, а предыдущие версии сохраняются как отрицательные примеры. Поскольку положительный и отрицательный варианты расходятся в известной позиции, из одной сессии можно получить пары предпочтений и сигнал для оценки отдельных шагов рассуждения.
Метод проверяли три разметчика на 21 задании с описанием изображений. Начальные ответы генерировала Qwen3.5-35B-A3B; onPanda сравнивали с ручным редактированием в POTATO и ранжированием нескольких ответов в Argilla. Это сравнение целых рабочих процессов, поэтому оно не отделяет пользу интерфейса от пользы самого способа разметки.
Почему исправленный ответ остаётся близким к исходной модели
Ручное редактирование легко превращает ответ модели в текст человека: меняются формулировки, структура и выбор слов. Такие примеры могут быть качественными, но они хуже отражают распределение вероятностей, из которого модель обычно выбирает продолжение.
onPanda вмешивается только в точках ошибок. Токены до исправления остаются прежними, а всё после него снова генерирует модель. Выбор замены из её собственных кандидатов меняет траекторию меньше, чем произвольная правка; ручной ввод остаётся запасным вариантом для случаев, когда правильного продолжения среди кандидатов нет.
Медианное время на задание составило 330 секунд против 681 секунды у ручного редактирования. Перплексия — мера того, насколько естественным текст выглядит для исходной модели, — отклонилась от повторной генерации менее чем на 1%, тогда как после ручной правки выросла на 36%. В попарном сравнении модель-оценщик отдала ответам onPanda 66,7% побед, поэтому выигрыш во времени в этом опыте не сопровождался худшим итоговым текстом.
Ранжирование готовых вариантов тоже сохраняет распределение модели, но не гарантирует пригодный ответ: хорошего варианта может не оказаться среди сгенерированных. Исправление токена позволяет разметчику ввести недостающий факт или верное направление, после чего модель продолжит уже с этой точки.
Когда команде стоит менять процесс разметки
Работа меняет планы команд, которые уже генерируют ответы своей моделью и затем долго приводят их к стандарту вручную. Вместо отдельного редактора можно проверить цикл «найти первую ошибку — исправить — продолжить» на одном типе заданий и сравнить время, долю пригодных ответов и близость данных к исходной модели.
Для внедрения нужен API вывода, который умеет продолжать сообщение ассистента с заданного префикса и возвращать вероятности альтернативных токенов. Если требуется пересчитать вероятности после свободного ввода, API также должен поддерживать оценку токенов уже заданного текста. Без этих возможностей процесс придётся менять на уровне сервера генерации, а не только интерфейса разметки.
onPanda работает не только с обычными ответами. Система отображает рассуждения, служебные токены и аргументы вызовов инструментов, а через MCP может выполнить исправленный вызов и вернуть результат модели. Поэтому тот же цикл подходит для траекторий агентов, где простая правка журнала недостаточна: после изменения команды среда должна реально выполнить её, прежде чем модель продолжит работу.
Практическая ценность подхода не сводится к ускорению кликов. Команда получает эталонный ответ, отрицательные версии и точную позицию каждого исправления из одной разметочной сессии. Это позволяет сначала заменить рабочий процесс сбора данных, не меняя выбранный способ дообучения, а уже затем проверять, полезен ли более подробный сигнал отдельным моделям вознаграждения.
Источники
Иллюстрация: рисунок из статьи «onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction», Lei Yang, Mengyin Liu, Jia Wang и др., CC0 1.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


