
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Гибридную LLM научили сохранять поиск по длинному контексту и математические рассуждения после замены большей части полного внимания линейным. В препринте Carnegie Mellon University и Cornell University, который не прошёл рецензирование и содержит замеры самих авторов, гибридные версии сравнялись с исходными моделями в задачах на извлечение информации. Для команд это превращает переделку уже обученной модели в более реалистичную альтернативу обучению новой архитектуры с нуля.
Почему обычная дистилляция ломается на длинных ответах
Полное внимание хранит ключи и значения всех предыдущих токенов. По мере роста контекста этот кеш занимает всё больше памяти, а каждый новый токен требует больше вычислений.
Линейное внимание вместо полной истории поддерживает состояние фиксированного размера. Оно сжимает предыдущие токены и поэтому не увеличивает память состояния с длиной последовательности. Гибридная архитектура сочетает несколько слоёв полного внимания с большинством линейных слоёв.
Такая замена создаёт другой риск: небольшая ошибка меняет сжатое состояние, это состояние влияет на следующий токен, а новые ошибки накапливаются. Модель может уйти в повторы или продолжить ответ текстом, который не связан с запросом. На коротких тестах проблема почти не видна, зато проявляется при поиске в большом документе и длинном рассуждении.
Обычная дистилляция обучает модель-ученика на готовых текстах. Учитель показывает правильное распределение следующего токена, но ученик не встречает последовательности, в которые попадает из-за собственных ошибок. Даже тексты, заранее сгенерированные учителем, не решают эту проблему: во время работы состояние ученика развивается иначе.
Как OPAL обучает модель на её собственных ошибках
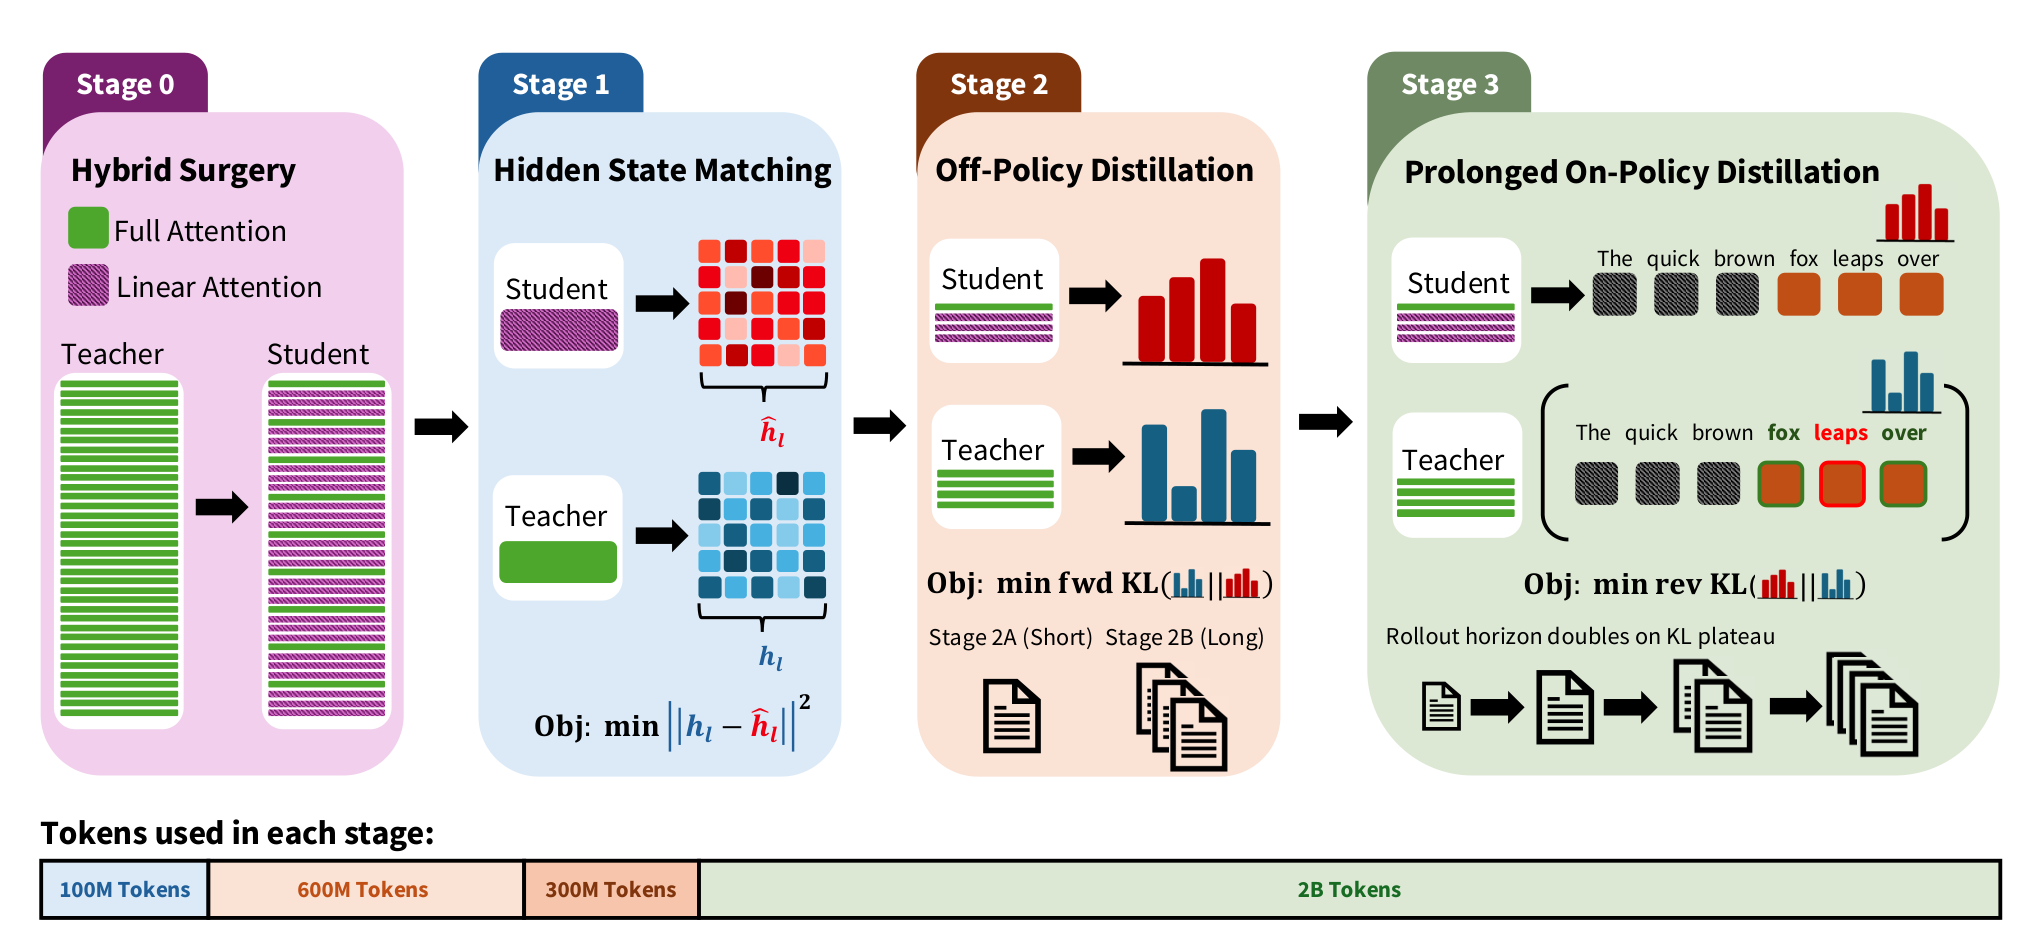
Сначала OPAL заменяет 75% слоёв полного внимания на GDN — вариант линейного внимания с управляемым забыванием и перезаписью состояния. Остальные компоненты модели наследуют параметры учителя.
Обучение идёт последовательно. Сначала выходы заменённых слоёв приближают к выходам соответствующих слоёв учителя. Затем всю модель дистиллируют на фиксированных коротких и длинных текстах, чтобы согласовать предсказания следующего токена.
Основное отличие появляется на последнем этапе. Ученик сам генерирует продолжение, после чего замороженный учитель оценивает распределение вероятностей для каждого созданного токена. Ученик сокращает расхождение с учителем именно в тех состояниях, куда привели его собственные решения.
Длину генерируемых последовательностей увеличивают постепенно: когда расхождение перестаёт заметно снижаться, горизонт удваивают. Одновременно в обучение добавляют более длинные примеры на извлечение информации и более сложные математические задачи. Весь процесс потребовал 3 млрд обучающих токенов и не включал отдельное контролируемое дообучение или обучение с подкреплением за проверяемый ответ.
Метод проверяли на Qwen3-4B и MiMo-7B-RL-0530. Для обеих моделей сравнивали гибриды с исходными версиями полного внимания, прежними способами дистилляции и контрольным обучением на готовых последовательностях. Набор задач охватывал здравый смысл, математические рассуждения и извлечение одной или нескольких частей информации из длинного контекста; дополнительный опыт показал ту же схему обучения с архитектурой Mamba-3.
Когда результат меняет план разработки
На тестах извлечения информации оба гибрида достигли уровня учителей при длине контекста до 32 тысяч токенов. В математических тестах они сохранили не менее 83% результата исходных моделей. При одинаковом объёме обучения собственные последовательности ученика дали на AIME’24 примерно вдвое более высокий результат, чем продолжение дистилляции на фиксированном наборе.
Архитектурная замена сохранила и ожидаемую экономию: при контексте 128 тысяч токенов кеш и состояние занимали примерно в четыре раза меньше памяти. Замеры проводили через vLLM, поэтому результат относится не только к качеству модели, но и к серверному выполнению.
Если команда собирается преобразовать уже обученную модель полного внимания, одной дистилляции на корпусе недостаточно. В план стоит включить длительный этап, где ученик генерирует собственные последовательности, а учитель проверяет каждый токен. Это добавляет вычисления учителя во время обучения, но направляет их на восстановление поведения после архитектурной замены, а не на повторное предобучение модели.
Работа даёт основание тестировать такой путь для моделей близкого масштаба и задач, где ответ или контекст действительно длинные. Решение пока опирается на две исходные модели и проверки на извлечении информации, математике и здравом смысле. Для продуктовой нагрузки всё равно нужен отдельный прогон: важно измерить не только среднюю точность, но и деградацию по мере роста истории, потому что именно её скрывают короткие тесты.
Источники
Иллюстрация: рисунок из статьи «On-Policy Attention Linearization», Arian Raje, Anupam Nayak, Anthony Fei и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


