
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили точнее решать многошаговые задачи, подсказывая ей, к каким частям собственного рассуждения стоит возвращаться. В работе Safaeid Hossain Arib и соавторов вычислительные затраты сократились на 72,6%, хотя препринт не рецензирован, а числа получили сами авторы. Метод касается команд, которые дообучают модели на проверенных решениях: он меняет не работу готовой модели, а способ передать ей знания во время обучения.
Как учитель показывает, куда смотреть
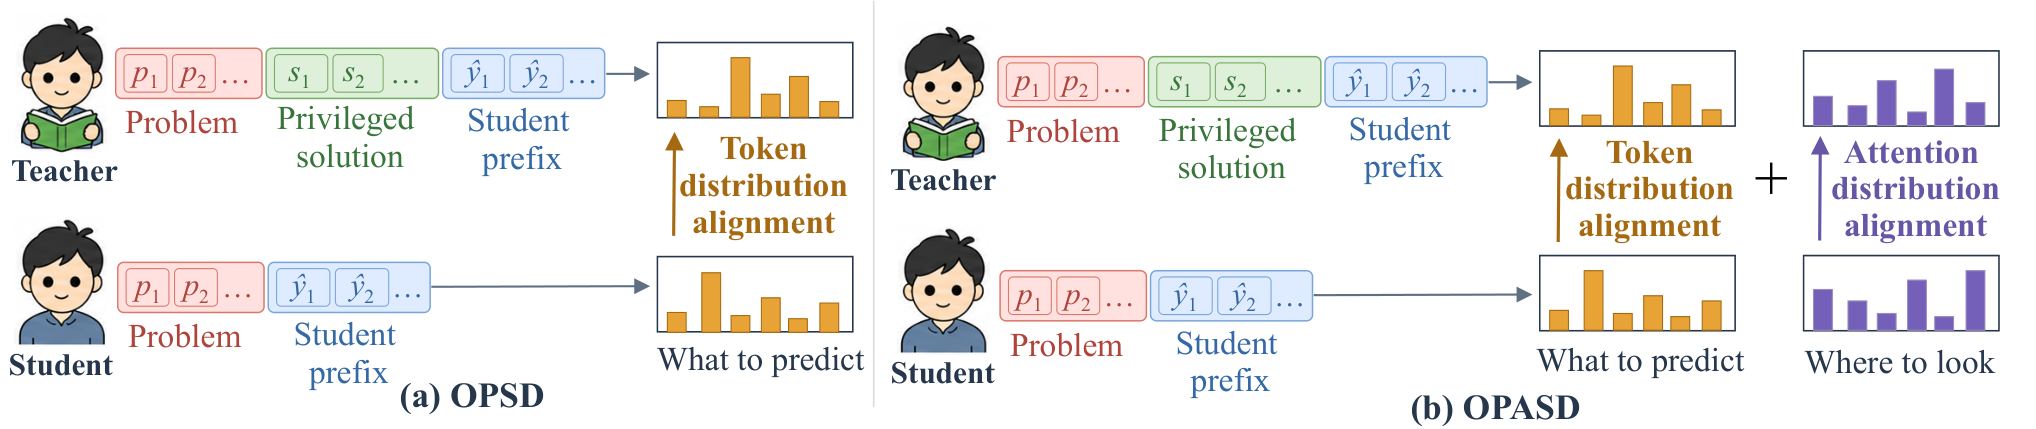
Обычная самостоятельная дистилляция по текущей стратегии строится вокруг траекторий самой модели. Модель-ученик получает задачу и генерирует рассуждение, а замороженная копия той же модели играет учителя: видит задачу вместе с проверенным решением и оценивает каждый следующий токен в траектории ученика.
Так ученик узнаёт, какое продолжение предпочёл бы учитель, но не узнаёт, на какие предыдущие шаги тот опирался. Для длинного решения это существенно: при вычислении очередного выражения модель может проигнорировать условие или промежуточный результат, а затем продолжить формально связный, но уже неверный вывод.
OPASD добавляет второй сигнал обучения — распределение внимания последнего слоя. Учитель показывает, какие позиции в условии и уже написанном рассуждении сильнее влияют на очередной шаг. Ученик одновременно сближает с учителем распределения следующего токена и внимания.
Напрямую сопоставить внимание нельзя. Учитель видит эталонное решение и может смотреть на его токены, которых нет в контексте ученика. OPASD удаляет эти недоступные позиции, а оставшийся вес заново нормирует, чтобы сумма снова составляла целое распределение.
При этом сохраняются относительные приоритеты учителя среди доступных позиций. Если учитель уделял одному промежуточному результату вдвое больше внимания, чем условию, после проекции это соотношение не меняется. Эталон влияет на выбор приоритетов, но ученик учится работать только с тем контекстом, который получит после развёртывания.
Короткие траектории дали и точность, и экономию
OPASD обошёл дистилляцию только по токенам на 4,98–8,40 процентного пункта. Авторы считали Avg@12 — среднюю точность по двенадцати генерациям для каждой задачи. Улучшение сохранилось на всех проверенных размерах модели и каждом математическом тесте.
Главный источник экономии — не более дешёвый шаг обновления. Добавленная функция потерь делает обработку отдельного токена дороже, но модель перестаёт раздувать рассуждения повторными проверками и сомнениями. За весь запуск она сгенерировала на 73,9% меньше токенов, поэтому обучение закончилось в 1,53 раза быстрее.
Дистилляция только по токенам постепенно порождала более длинные ответы, тогда как качество на проверочной выборке снижалось. OPASD удерживал ответы короче и реже возвращался к одним и тем же сомнениям. Это связывает экономию с изменением траектории: модель не просто пишет компактнее, а точнее выбирает предыдущий шаг, который нужен для продолжения.
Меняет ли OPASD планы обучения моделей
Результат применим к узкому, но практическому сценарию: у команды есть задачи с проверенными решениями, а модель дообучают на её собственных траекториях. В такой схеме внимание учителя становится ещё одним доступным обучающим сигналом и может окупить дополнительные вычисления на каждом токене за счёт более коротких ответов.
Метод требует доступа к внутреннему вниманию модели во время обучения. Недостаточно вызвать закрытую модель через API и получить распределение следующего токена: нужно извлечь внимание последнего слоя, отделить позиции эталонного решения и посчитать дополнительную функцию потерь. Само эталонное решение требуется только при обучении.
Работу проверяли на трёх размерах Qwen3, на данных OpenThoughts и четырёх соревнованиях по математике из серий AIME и HMMT. Модели дообучали с LoRA, а сравнение затрат провели за 200 шагов на четырёх H100. Такой дизайн показывает эффект внутри одной линейки и одной предметной области, но пока не определяет результат для кода, бизнес-процессов или других архитектур.
Поэтому менять общий план продукта рано, а план эксперимента — уже разумно. Если в нём есть самостоятельная дистилляция с эталонными решениями, стоит сравнить перенос только токенов с совместным переносом токенов и внимания, измеряя не только точность, но и суммарную длину траекторий. Именно сокращение траекторий превратило более сложный шаг обучения в меньший общий расход.
Источники
Иллюстрация: рисунок из статьи «Teach Yourself Where to Look: On-Policy Attention Self-Distillation for Reasoning», Safaeid Hossain Arib, Rabeya Akter, Ismam Nur Swapnil и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


