
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Мультимодальную модель научили прерывать ошибочное рассуждение, когда текст ответа уже заставляет её игнорировать изображение. В нерецензированном препринте, где все числа получили сами авторы, OPD-Aha поднял средний результат на шести тестах точного зрительного восприятия с 76,4 до 78,8. Для команд, которые обучают компактные модели с более сильным учителем, работа предлагает способ не терять корректирующий сигнал на самых проблемных ответах.
Ошибочный текст заставляет учителя забыть изображение
Дистилляция на траекториях самого ученика обучает модель на состояниях, в которые она действительно попадает при генерации. Ученик пишет ответ, а замороженный учитель оценивает каждый следующий токен и задаёт более качественное распределение вероятностей.
В мультимодальной версии учитель получает дополнительные зрительные данные только во время обучения: например, увеличенный фрагмент нужной области. Ученик видит исходное изображение, но обе модели читают один и тот же уже написанный учеником текст.
Именно общий текст создаёт сбой. Если ученик рано неверно распознал надпись, стрелку часов или положение предмета, следующие фразы развивают эту версию. Чем длиннее ошибочное объяснение, тем сильнее оно влияет на учителя, несмотря на более точное изображение.
Chenhao Qiu и соавторы измерили предпочтение учителя между правильным и фактически выбранным неправильным ответом на последовательно удлиняемых фрагментах неудачных траекторий. Примерно к середине ответа учитель начинал предпочитать ошибочный вариант. Его распределение сближалось с распределением ученика, поэтому стандартная дистилляция переставала показывать, что именно нужно исправить.
Это не означало, что изображение больше не влияло на учителя. Влияние сохранялось, но его скрывало общее ошибочное рассуждение.
Как OPD-Aha извлекает скрытую зрительную поправку
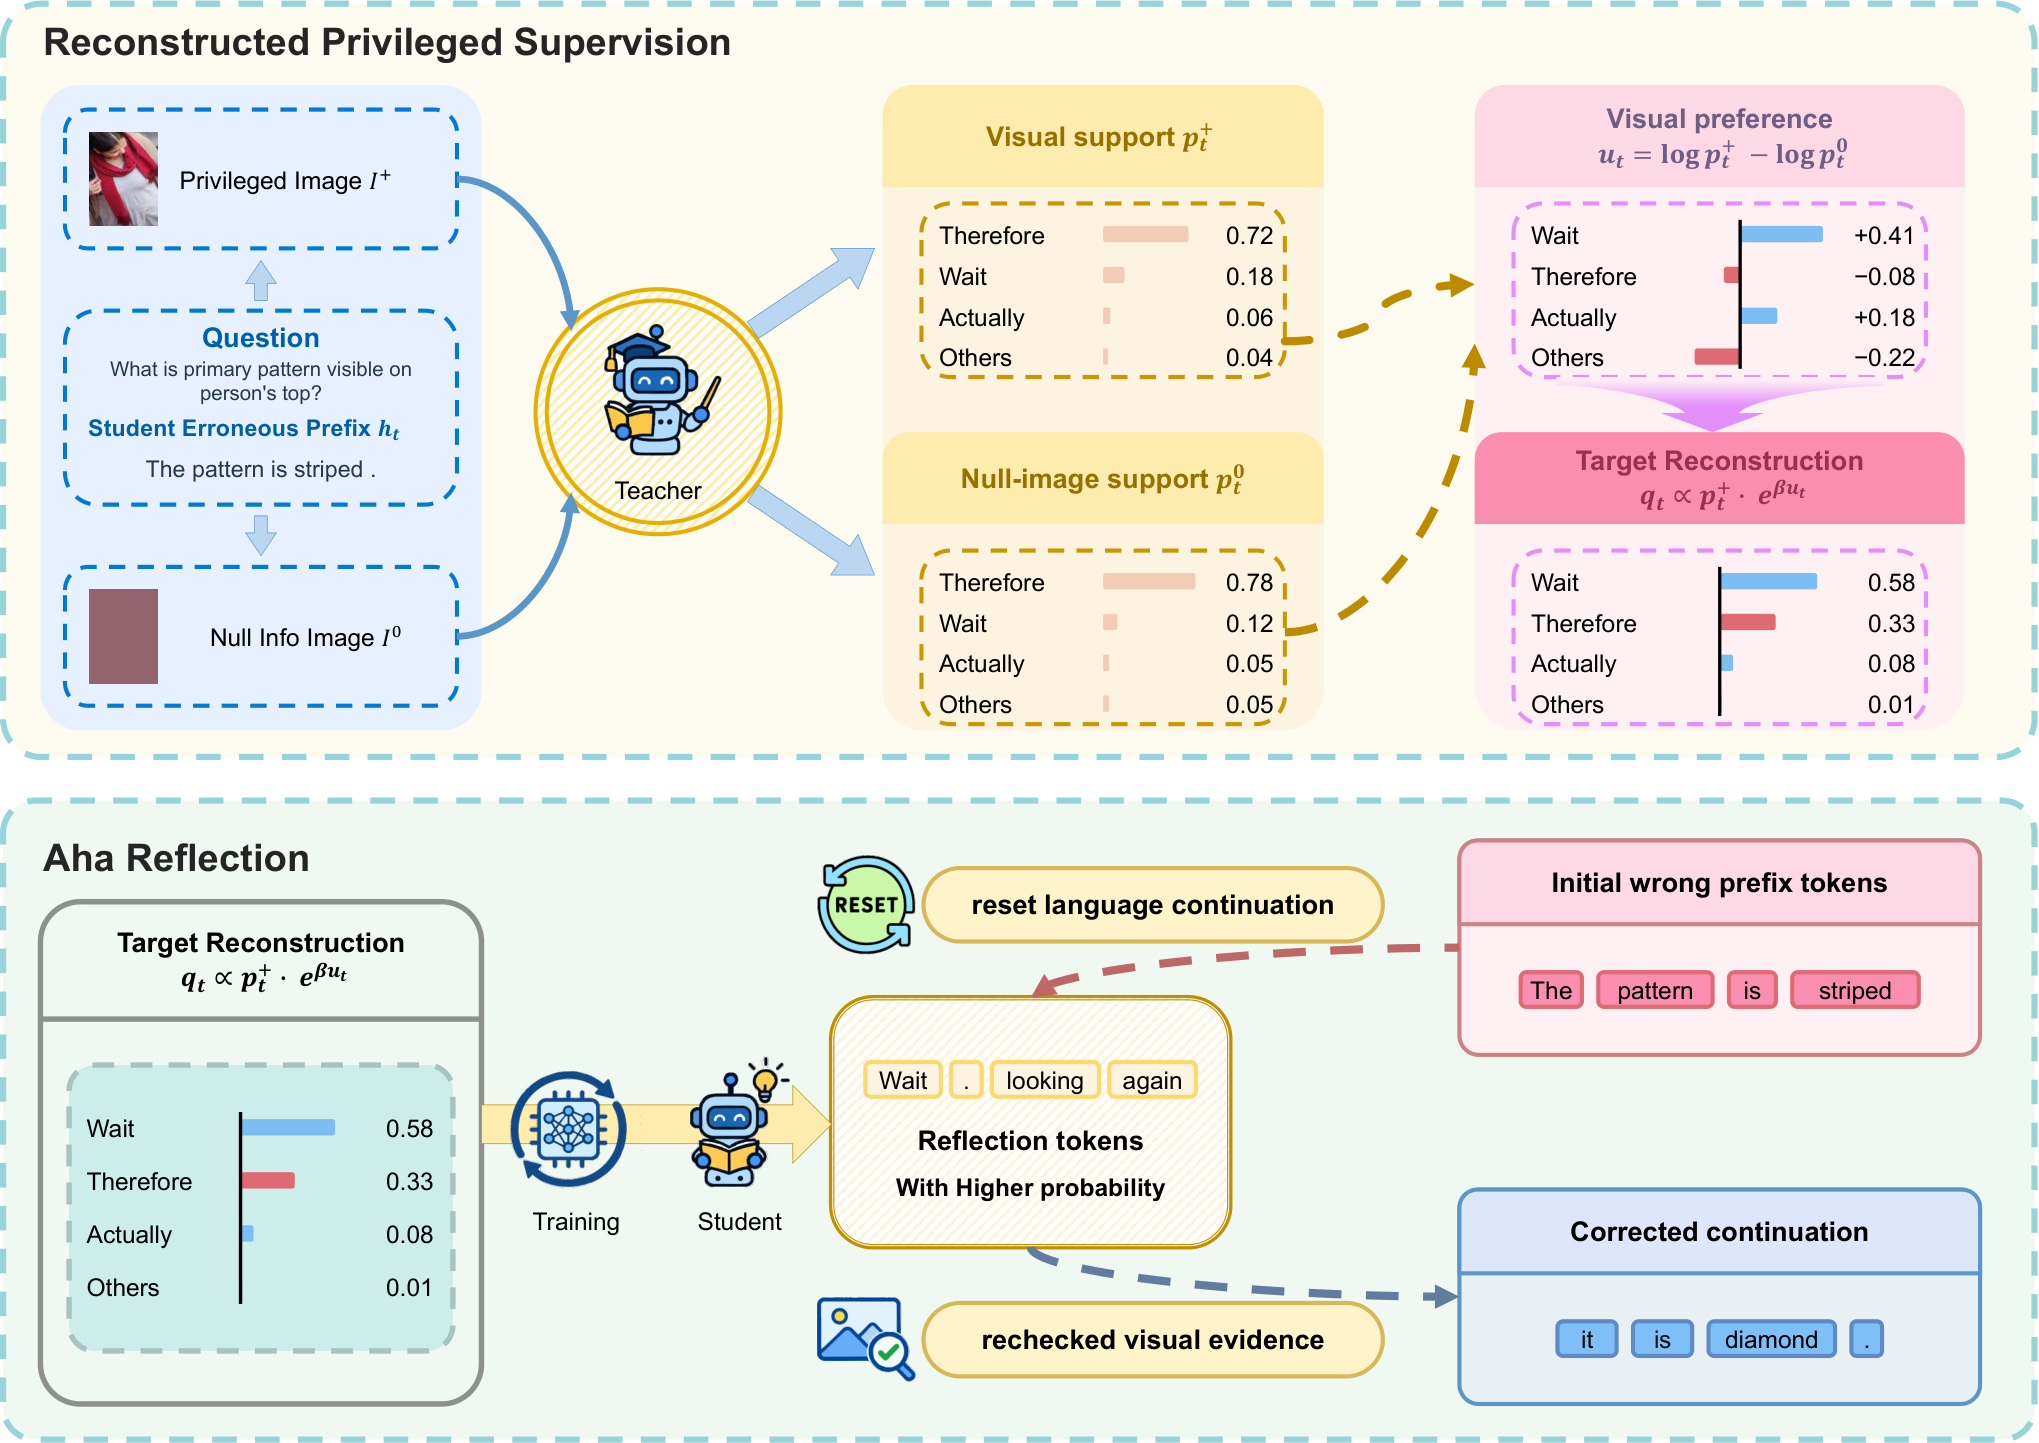
OPD-Aha не сравнивает учителя с учеником напрямую. Вместо этого метод дважды запускает одного учителя на одном текстовом префиксе. В первом случае модель получает настоящее дополнительное изображение, во втором — однотонную заглушку со средним цветом исходного изображения.
Разница между двумя распределениями показывает, как зрительные данные меняют предпочтение каждого токена. Положительная разница означает, что изображение поддерживает продолжение, отрицательная — что оно его подавляет. Замена заглушки посторонним естественным изображением сохраняла направление сигнала, а перестановка поправок между токенами разрушала его: учитель реагировал на конкретные варианты продолжения, а не просто на наличие картинки.
Из этой разницы OPD-Aha собирает новую цель для дистилляции. За основу берётся полное распределение учителя на настоящем изображении, чтобы сохранить связный язык. Затем метод усиливает варианты, которые поддерживают зрительные данные, и подавляет продолжения, которые им противоречат. Отдельный коэффициент задаёт силу поправки.
На поздних участках ошибочного ответа новая цель сохраняла вероятность правильного варианта более чем на порядок выше стандартной. При этом она не обучала модель явно писать wait или actually. Вероятность таких слов могла даже снижаться, но вероятность ошибочного продолжения падала ещё сильнее. Поэтому прерывание получало относительное преимущество.
После прерывания ученик слабее опирался на собственный предыдущий текст и снова обращался к изображению. В одном из примеров модель сначала запуталась между показаниями часов, затем отдельно проверила длинную и короткую стрелки и вернулась к верному ответу. Дополнительное изображение и учитель при выполнении задачи не нужны: они участвуют только в обучении.
Командам стоит проверить дистилляцию на ложное согласие
Метод проверяли на учениках Qwen3.5 размером 4B и 9B. Обучение охватывало точное зрительное восприятие, а перенос без дополнительного обучения — MathVerse, MathVista, MathVision, WeMath и DynaMath. OPD-Aha сравнивали с исходной моделью, GRPO и Vision-OPD.
На меньшей модели Vision-OPD уступил исходной версии во всех проверенных задачах рассуждения. OPD-Aha, напротив, превзошёл её по всем восьми метрикам. На большей модели преимущество сохранилось, хотя разрыв на отдельных тестах был небольшим. Работа поэтому показывает не универсальный способ улучшить любую мультимодальную модель, а конкретную защиту от сбоя при обучении на собственных ошибочных траекториях.
Если команда уже строит такую дистилляцию, в план экспериментов стоит добавить проверку на ложное согласие. Для неудачных ответов нужно сравнить две величины: расхождение учителя с учеником и реакцию одного учителя на настоящее изображение и заглушку. Если первое исчезает, а второе сохраняется, стандартная цель скрывает полезную поправку.
OPD-Aha требует второго вычисления распределения учителя во время обучения, поскольку тот же префикс нужно оценить с двумя зрительными входами. Работа не даёт отдельной оценки вычислительной надбавки, поэтому её придётся измерить на собственной инфраструктуре. На задержку и стоимость готовой модели метод не влияет.
Для продукта, который использует закрытую мультимодальную модель только через API, непосредственных изменений нет: метод требует доступа к обучению и полным распределениям вероятностей учителя. Для собственной модели вывод практичнее: согласие учителя и ученика ещё не доказывает, что зрительная ошибка исчезла.
Источники
Иллюстрация: рисунок из статьи «OPD-Aha: From Linguistic Momentum to Visual Reflection in Multimodal On-Policy Distillation», Chenhao Qiu, Dawei Li, Yechao Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


