
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
OpenAI4S научили возвращаться к длинному вычислительному исследованию после остановки и показывать, откуда взялся каждый результат. Хотя препринт не прошёл рецензирование и все числа получили сами авторы, команда во главе с Peking University получила сводную оценку 7,83 балла против 5,7–6,4 у Claude Code. Для разработчиков научных агентов работа переносит центр архитектуры с очереди вызовов API на сохраняемую исследовательскую сессию.
Вычисления остаются частью сессии, а не исчезают после ответа модели
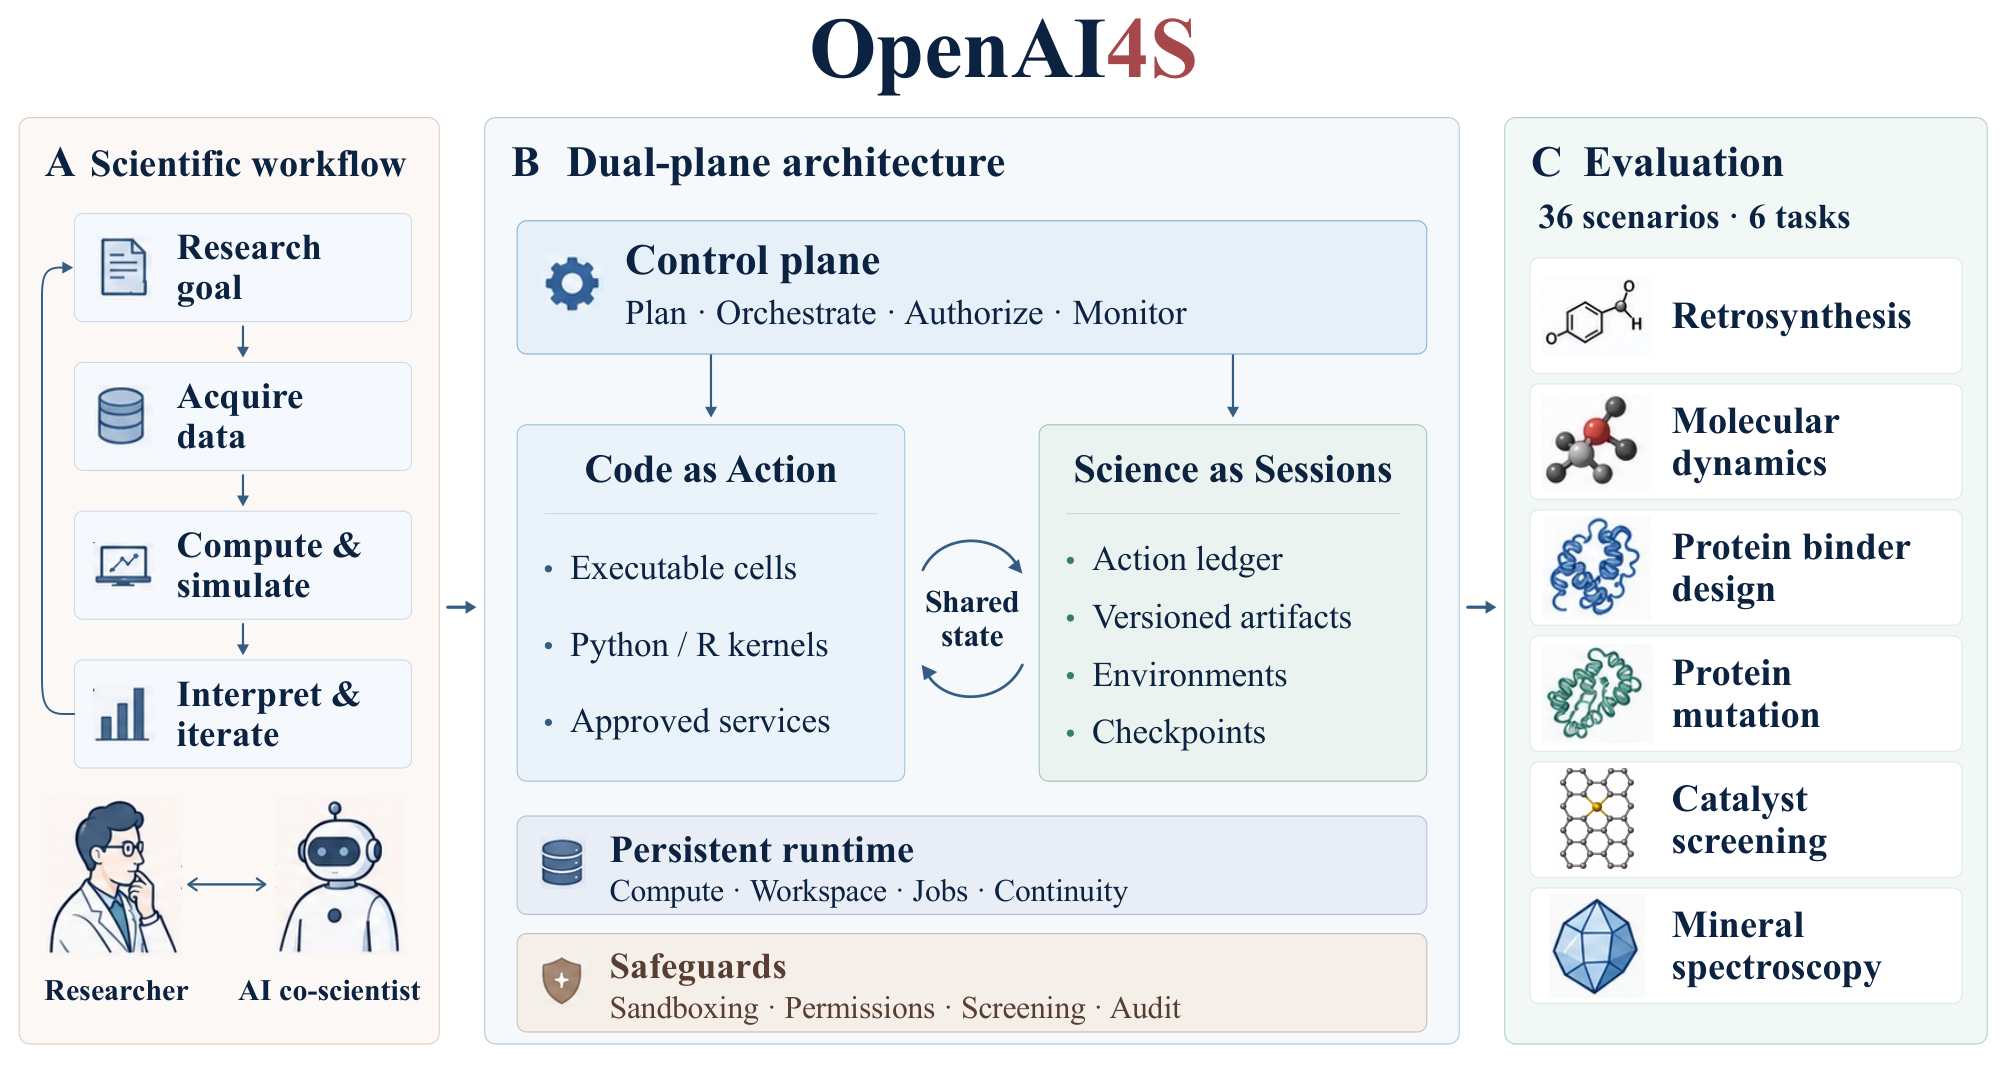
OpenAI4S разделяет управление агентом и научные вычисления. Команды для разрешений, внешних сервисов и управления сессией проходят как структурированные вызовы, а анализ, моделирование и построение графиков модель оформляет полными ячейками кода. Ячейки выполняются в постоянных вычислительных ядрах Python и R.
Пока ядро работает, оно сохраняет переменные между шагами. Модель может очистить набор данных, обучить модель, затем обратиться к уже рассчитанным объектам, не загружая и не создавая их заново. Это сокращает число границ, на которых агенту приходится описывать промежуточное состояние текстом или передавать его через отдельный инструмент.
Каждая выполненная ячейка попадает в дописываемый журнал действий вместе с исходным кодом, выводом, ошибками и идентификатором процесса. Версии файлов и других артефактов связываются с доступными сведениями о вычислении и среде. Контрольные точки сохраняют рабочее пространство и поддерживаемые метаданные, поэтому сессию можно изучить, продолжить от прежнего состояния или разветвить для другого варианта эксперимента.
Контрольная точка при этом не замораживает произвольные объекты из памяти Python или R. После перезапуска надёжно сохраняются файлы, зарегистрированные артефакты и записанная часть состояния. Для восстановления OpenAI4S запускает отдельное ядро, повторяет допустимые ячейки и проверяет нужные переменные, контрольные суммы артефактов и среду; если подтвердить состояние нельзя, восстановление помечается как частичное или неудачное.
Преимущество проявилось в длинных вычислительных цепочках
Проверка охватила 36 сценариев из шести направлений химии, биологии и материаловедения: от ретросинтеза и молекулярной динамики до проектирования белков и анализа минеральных спектров. OpenAI4S сравнивали с Claude Code, который запускали с тремя передовыми моделями. Наибольший разрыв возник в молекулярной динамике и проектировании белковых связующих — там, где цепочки вычислений были длиннее и требовали больше ресурсов.
Итоговый репозиторий оценивали по научной точности, полноте процесса и воспроизводимости. Сначала работали программные проверки, а спорные содержательные критерии разбирала модель-оценщик, которой передавали только структурированные свидетельства из репозитория. Такой порядок снижает зависимость результата от свободной интерпретации модели, но не превращает оценку в независимую научную экспертизу.
Полное повторное выполнение осталось слабым местом у всех проверенных систем, включая OpenAI4S. Журнал и контрольные суммы помогают установить, что происходило внутри сессии, но сами по себе не воссоздают внешние сервисы, учётные данные, оборудование и произвольные объекты в памяти. Проверки завершения также подтверждают формат и наличие выбранных свидетельств, а не истинность научного вывода.
Командам стоит проектировать восстановление раньше набора инструментов
Работа меняет планы прежде всего там, где агент ведёт эксперимент часами или возвращается к нему спустя несколько запусков. Для таких продуктов недостаточно хранить переписку модели и итоговые файлы: журнал должен связывать действие, код, среду, входные данные, версию артефакта и результат выполнения.
Практический минимальный контур выглядит так:
- постоянное вычислительное ядро для последовательных шагов;
- дописываемый журнал кода, результатов и ошибок;
- версии артефактов и записи о среде;
- контрольные точки рабочего пространства;
- проверяемое восстановление со статусами полного, частичного и неудачного результата.
Особенно важно разделять живое состояние процесса и долговечные данные. Фоновая задача OpenAI4S, например, получает отдельный процесс и не наследует объекты из основного ядра: входы нужно заранее записать в файлы или артефакты. Такая граница усложняет разработку, но делает зависимости видимыми и не позволяет случайно принять содержимое памяти за воспроизводимый результат.
Для коротких одноразовых задач эта архитектура может оказаться избыточной. Проверка касается научных сценариев, а не разработки программ или обычной автоматизации бизнеса. Но если продукт должен переживать сбои, ветвить вычислительные эксперименты и объяснять происхождение результата, постоянная сессия становится базовым слоем, а выбор LLM — сменным компонентом над ним.
Источники
Иллюстрация: рисунок из статьи «OpenAl4S: Code as Action, Science as Sessions», Gongbo Zhang, Hao Li, Yu Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


