
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Openhagen Worlds проверяет, умеет ли научный агент выбирать эксперименты, учитывать результаты и отвечать по существу, а не вспоминать знакомую задачу или угадывать правило оценки. Набор собрал Alexander Boesgaard Lorup; хотя работа не рецензирована и все числа получил сам автор, при увеличении бюджета DeepSeek V4.1 Flash решил 57 скрытых задач вместо 32. Для продуктовой команды это прежде всего схема испытательного стенда, где можно отделить качество рассуждений от утечек, случайных успехов и ошибок протокола.
Как среда не даёт пройти задачу коротким путём
Научный агент здесь — модель, которая несколько раз выбирает эксперимент, получает измерение и в конце фиксирует ответ. Openhagen Worlds охватывает 27 семейств: от поиска фальшивой монеты и группового тестирования до электрических цепей, кинетики реакций, оптики и управления процессами.
Каждый экземпляр содержит скрытую истину: неисправность в цепи, структуру молекулы, причинную связь или правило. Агент видит цель, доступные действия, бюджет экспериментов и полное правило оценки. В него входят допустимые отклонения, условия частичного зачёта и причины завершения эпизода, поэтому результат не зависит от скрытой инструкции модели-оценщика.
Ответ проверяет программа. Дискретные значения должны совпасть точно, непрерывные — попасть в заранее указанное отклонение. Исправление программы проверяют на всех входах заданной области, а предложенный контроллер или технологический процесс запускают на истинной модели системы.
Перед калибровкой фильтр отбрасывает экземпляры, которые нельзя однозначно решить разрешёнными экспериментами. Это важно для обучения с проверяемой наградой: модель не должна получать штраф за вопрос, на который сама среда не позволяет ответить.
Затем уровень проходят несколько сценариев. Идеализированный решатель хранит все гипотезы, совместимые с наблюдениями, и выбирает эксперимент, который лучше всего их разделяет. Уровень принимают, только если такой решатель успешен хотя бы в 75% случаев, сильная стратегия без дедукции — не более чем в 25%, а каждая заранее описанная обходная стратегия — не более чем в 35%.
Последняя граница принципиальна: ворота защищают от известных коротких путей, а не доказывают отсутствие любых будущих способов обмануть награду. Поэтому среда сохраняет последовательность экспериментов. При обучении можно проверять не только финальный ответ, но и путь, которым агент к нему пришёл.
Бюджет рассуждения меняет результат сильнее модели
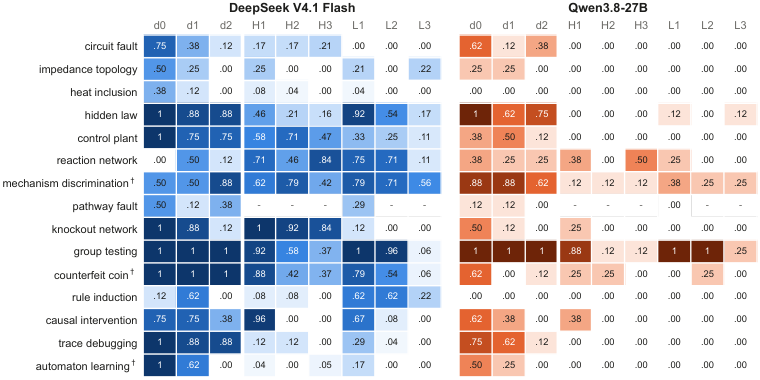
На одном наборе из 84 скрытых задач продвинутого уровня DeepSeek V4.1 Flash решил 32 задачи со стандартным усилием и 57 с максимальным. Идеализированный решатель справился с 79. Значительная часть разрыва оказалась связана не только со способностью рассуждать, но и с тем, сколько вычислений разрешено на один ход.
При коротком бюджете модель часто доходила до лимита до того, как выдавала допустимое действие. Остальные неудачи в основном завершались содержательно неверным ответом, а не сломанным форматом. Поэтому единая оценка смешивает как минимум две причины: агент либо не вывел ответ, либо не успел оформить его в рамках бюджета.
Труднее всего оказались кампании из восьми и более связанных этапов. Ответ на каждом этапе фиксируется без возможности отмены, следующие вопросы зависят от предыдущих выводов, а в самых длинных кампаниях агент видит только недавнюю часть истории. Ошибки возникают рано и накапливаются, поэтому отдельный удачный эксперимент ещё не означает, что агент проведёт исследование целиком.
Основной уровень охватывает все семейства, а продвинутый — только среды научного поиска. Сравнение включает программные стратегии, локальные модели на базе Qwen и одну модель через API; более сильная модель участвовала лишь в пилотном прогоне. Кроме того, устройство продвинутого уровня корректировали после просмотра результатов одной модели на финальных экземплярах, поэтому для независимого сравнения важнее будущие запуски через закрытый сервис, чем один итоговый рейтинг из статьи.
Работа меняет план испытаний, но не выбор модели
Главный практический результат — не таблица лидеров, а порядок сборки среды. Команде сначала нужна скрытая и проверяемая истина, затем полный договор об оценке, фильтр разрешимости и только после этого набор базовых и обходных стратегий. Если случайная последовательность действий или ответ из похожего экземпляра проходит слишком часто, уровень нельзя использовать как сигнал для обучения.
Закрытый ключ для финальных экземпляров решает ещё одну инженерную проблему. Открытый генератор полезен для обучения, но тот же генератор нельзя применять к тесту без секрета: модель или разработчик смогут восстановить задачи заранее. Openhagen Worlds разделяет ключи обучения, разработки и итоговой оценки, добавляет идентификаторы экземпляров и исключает известные учебные задачи.
Среда подходит для команд, которые строят агентов для лабораторного анализа, инженерной диагностики или управления экспериментами. Она предлагает проверять отдельно выбор эксперимента, анализ показаний, соблюдение формата и способность переносить выводы между этапами. Это точнее, чем одна метрика успешности, которая скрывает причину сбоя.
Обучающий эксперимент тоже даёт сдержанный сигнал: экспертная итерация повысила успешность на 5,8 процентного пункта, причём часть прироста объясняется тем, что модель стала лучше соблюдать формат действий. На GPQA Diamond заметного ухудшения не обнаружили. Этого недостаточно, чтобы выбирать архитектуру или обещать автономное исследование, но достаточно, чтобы включить такие среды в контур разработки и проверять прогресс на закрытых экземплярах.
Для внедрения остаётся организационная граница: через размещённый сервис можно запускать только основной уровень, а полный набор доступен партнёрам по лицензии. Значит, работа скорее меняет план оценки агента, чем немедленно заменяет собственный стенд команды.
Источники
Иллюстрация: рисунок из статьи «Openhagen Worlds: Calibrated Environments for Measuring and Training Scientific Discovery Agents», Alexander Boesgaard Lorup, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


