
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Кодового агента научили удерживать требования задачи и учитывать ответы инструментов без дополнительных напоминаний во время работы. В препринте Yuechen Luo и коллег, который не проходил рецензирование и где все числа получили сами авторы, OPRD увеличил среднюю долю решённых задач на 11,3 процентного пункта относительно исходной модели. Для развёртывания это убирает генератор подсказок и не расходует на них контекст, но требует собственного обучения с исполняемой проверкой результата.
Напоминания разделили по сроку действия
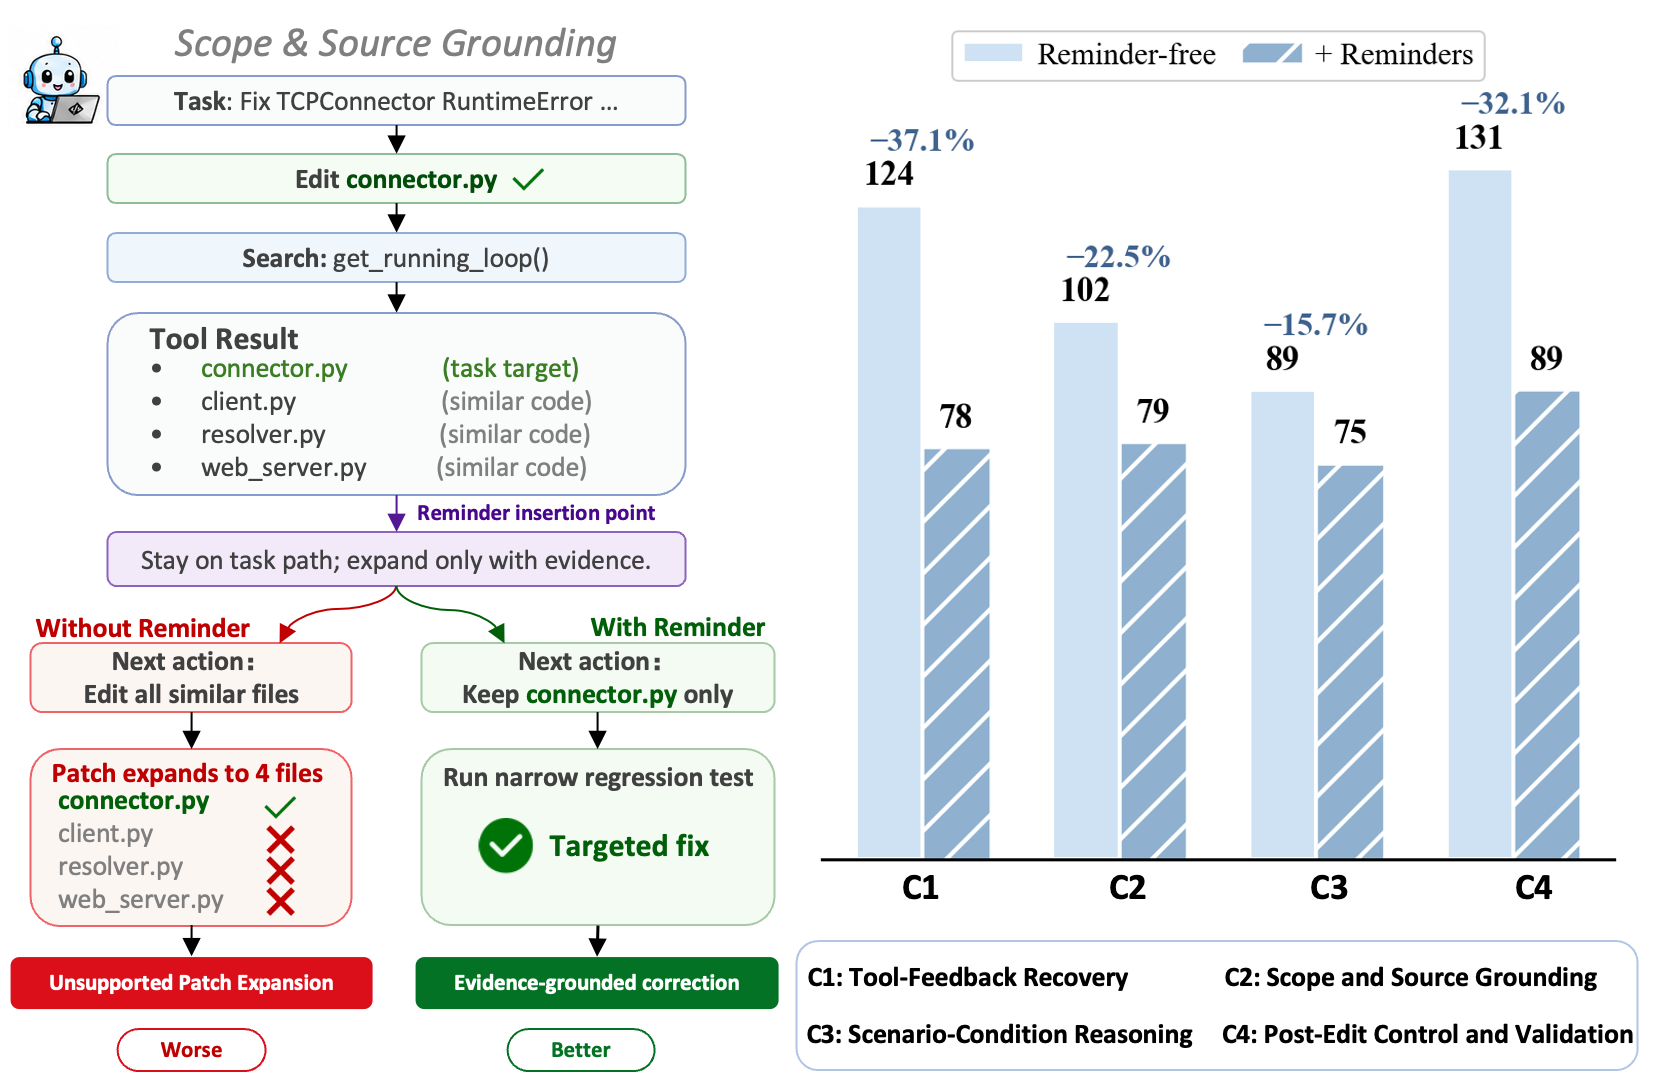
Проблема возникает не из-за отсутствия сведений в контексте. Агент уже видит ограничение пользователя, сообщение об ошибке или результат теста, но через несколько ходов перестаёт учитывать эту информацию либо применяет её не к тому решению.
OPRD использует два вида обучающих напоминаний. Глобальное напоминание превращает итоговую диагностику тестов в правило для всей траектории: например, сохранять совместимость или не выходить за разрешённую область изменений. Локальное привязано к конкретному ответу среды и действует только на следующий ход — скажем, заставляет учесть ошибку инструмента перед новой правкой.
Такое разделение не даёт краткосрочной подсказке превратиться в постоянное правило. Одновременно глобальное требование не растворяется в длинной истории вызовов инструментов, чтения файлов и редактирования кода.
Напоминания строят после неудачной попытки из условия задачи, полной траектории, сообщений среды и итогов тестирования. Учитель получает их как дополнительный контекст, а ученик видит только исходную историю. После обучения напоминания, учитель и модуль их построения из рабочего контура удаляют.
Перед OPRD обе модели проходят обучение на успешных траекториях программирования, а затем учатся выполнять инструкции и реагировать на обратную связь. Этот второй этап важен: модель, которая игнорирует явную подсказку, не сможет перенять вызванное ею поведение.
Успешные и неудачные попытки обучают по-разному
Агент решает задачи текущей версией своих параметров. Поэтому обучение происходит на состояниях и ошибках, в которые он действительно попадает, а не только на заранее собранных чужих решениях.
Если итоговый код проходит исполняемую проверку, ученик копирует собственную успешную траекторию. Если проверка провалена, повторять весь ход решения нельзя: это закрепило бы ошибочные действия. Тогда учитель заново оценивает те же префиксы ответов, но уже с глобальными и локальными напоминаниями.
Ученик сближает своё распределение следующих токенов с распределением учителя через обратную дивергенцию Кульбака — Лейблера. Обновление сильнее затрагивает варианты, которым сам ученик уже назначил высокую вероятность, хотя учитель с учётом подсказки считает их неподходящими. Учитель не генерирует новую идеальную траекторию: он исправляет модель непосредственно в посещённых ею состояниях.
Проверка охватывает Qwen3.5-4B и Qwen3.5-9B, а итоговое качество измеряют на SWE-bench Verified, SWE-bench Pro и SWE-bench Multilingual. Отдельную диагностику поведения проводили на 200 задачах SWE-rebench V2: учитывали пропущенную обратную связь, необоснованное расширение правки, ошибки в условиях выполнения и слабую проверку после изменения кода.
Подход меняет план обучения, а не архитектуру агента
После OPRD суммарное число диагностических ошибок сократилось с 446 до 222. Способность следовать вставленному напоминанию выросла с 49,3% после обучения программированию до 77,1% после отдельной подготовки к выполнению инструкций. Это связывает итоговый прирост не только с умением писать код, но и с тем, насколько модель использует уже доступную ей информацию.
Разбор компонентов поддерживает основную схему. Разделение успешных попыток и провалов дало преимущество в 1,9 процентного пункта перед обучением всех траекторий одной и той же дистилляцией. Глобальные и локальные напоминания также лучше работали вместе, чем по отдельности.
Для команды, которая дообучает собственную модель кодового агента, работа предлагает конкретную замену подсказкам во время исполнения. В набор обучения нужно добавить диагностику провалов, разделить постоянные ограничения и локальную обратную связь, а затем показать учителю те же состояния, которые посетил ученик. Архитектуру рабочего агента после этого усложнять не требуется.
Для агента поверх закрытого API метод напрямую не подходит: обучение требует доступа к параметрам ученика и распределениям токенов учителя. Исполняемая проверка также остаётся обязательной, поскольку именно она решает, копировать успешную попытку или исправлять провал. Поэтому OPRD скорее меняет план собственной подготовки модели, чем даёт компонент, который можно добавить к существующему контуру вызовов.
Источники
Иллюстрация: рисунок из статьи «OPRD: On-Policy Reminder Distillation for Long-Horizon Coding Agents», Yuechen Luo, Zhiyi Lai, Miao Ziqi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


