
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Локальный ИИ-помощник может выбирать действие простым поиском, но не должен тем же способом решать, есть ли подходящее действие вообще. В препринте Redrob, который не прошёл рецензирование и содержит замеры самого автора, смысловая модель лучше отделила поддерживаемые запросы от неподдерживаемых. Для локального маршрутизатора это разделяет одну дорогую задачу на дешёвый выбор и нейросетевой отказ.
Выбор действия и отказ требуют разных сигналов
Маршрутизатор вызовов инструментов принимает два решения. Сначала он определяет, какое локальное действие соответствует запросу, а затем проверяет, стоит ли вообще выполнять что-либо из каталога.
Обычная LLM объединяет эти решения: либо формирует вызов, либо отказывается от него. На устройстве такая схема расходует память и увеличивает задержку, поэтому большую модель часто заменяют поиском по названиям, описаниям и псевдонимам действий.
BM25 всегда возвращает ближайший документ. Если пользователь просит заказать товар, а устройство умеет только открывать файлы и менять настройки, поиск всё равно найдёт наиболее похожую команду. Высокая позиция кандидата не означает, что кандидат допустим.
Работа предлагает считать выбор и отказ отдельными задачами. Поисковый индекс ранжирует только локальные действия, а отдельный пороговый модуль определяет, принадлежит ли запрос каталогу. После отказа фиксированное правило выбирает разговорный ответ или передачу запроса серверу.
Лексический поиск ломается на перефразировках, а не на знакомых командах
Проверка охватывала 600 искусственно составленных запросов на корейском и английском языках и каталог из 70 локальных действий. Среди поддерживаемых запросов одну часть написали словами из каталога, а другую перефразировали без изменения требуемого действия.
Маршрутизатор также мог запросить обязательный параметр, ответить без инструмента или передать задачу серверу. Успех исполнения проверяли по состоянию устройства после действия, без LLM в роли оценщика.
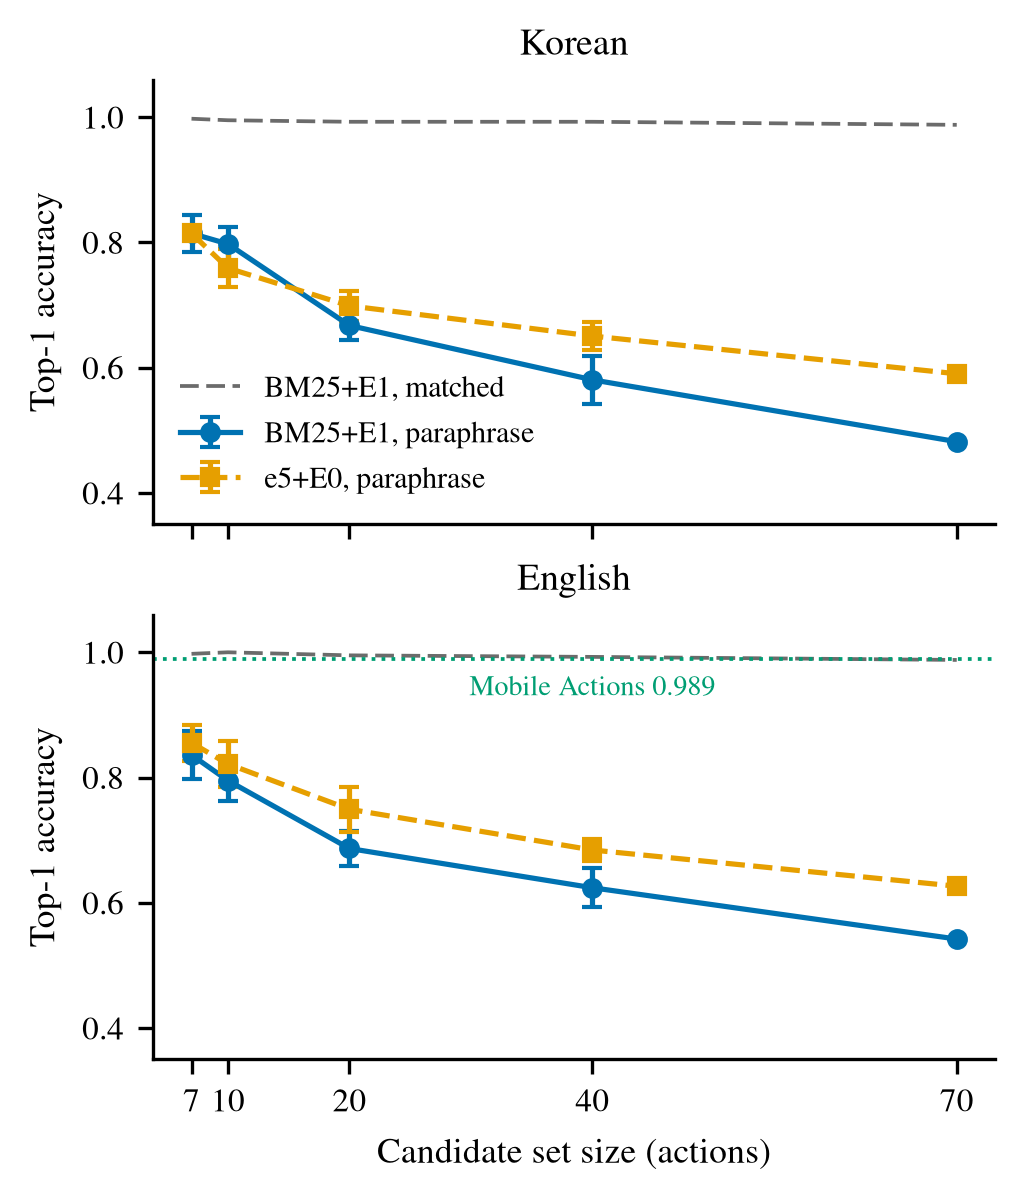
BM25 по символьным триграммам правильно выбирал действие в 99% запросов со знакомой лексикой. На перефразировках точность падала до 51%, но сокращение списка кандидатов поднимало её до 83%. Значит, простой поиск подходит для небольшого и хорошо описанного набора команд, особенно если контекст заранее сужает доступные инструменты.
Для отказа собственных оценок BM25 оказалось недостаточно. Лучший классификатор на их основе получил площадь под ROC-кривой 0,697: эта метрика показывает, насколько стабильно система ставит поддерживаемый запрос выше неподдерживаемого. Фиксированный multilingual-e5-base, который сравнивает смысловые представления запроса и каталога, достиг 0,806.
Улучшение ранжирования само по себе эту проблему не решило. Поиск может найти более подходящий инструмент среди имеющихся, но из его результата не следует, что пользователь просил именно локальное действие.
Границы замера заданы самим набором: запросы написаны для эксперимента, а доли знакомых формулировок, перефразировок и передачи серверу выбраны заранее. Работа проверяет одиночное решение маршрутизатора, не оценивает извлечение аргументов и не воспроизводит распределение реального продукта. Подтверждение пользователем также моделировали правилом, а не наблюдали в интерфейсе.
Планы стоит менять в архитектуре, а не в выборе одной модели
Работа не обосновывает полный отказ от нейросетей на устройстве. Она показывает, куда поставить нейросетевой компонент: не обязательно ранжировать им весь каталог, но полезно поручить ему решение о допустимости локального вызова.
Лексический индекс занимал 17 КБ, тогда как артефакт multilingual-e5-base — 278 МБ. Поэтому разделение задач не устраняет затраты на модель, но позволяет не использовать её повторно для ранжирования. Если память не позволяет держать кодировщик, порог по оценке BM25 нельзя считать равноценной заменой: именно на перефразировках он хуже отделял локальные запросы от внешних.
Команде с ограниченным каталогом имеет смысл строить конвейер из трёх частей: контекст сужает список действий, BM25 выбирает кандидата, смысловой кодировщик разрешает или запрещает локальное исполнение. Контракт вызова при этом остаётся отдельным от текста, по которому работает поиск.
Если бюджет памяти и задержки выше, нейросетевое ранжирование остаётся предпочтительным по качеству. В эксперименте такие варианты выигрывали у сохранённого конвейера по точности, но автор отклонил их из-за стоимости исполнения, а не из-за ошибок.
Перед изменением архитектуры стоит измерить на рабочих запросах две величины: как часто пользователь повторяет лексику каталога и сколько действий реально конкурируют в конкретном контексте. При знакомых формулировках и коротком списке простой поиск почти закрывает выбор; при свободном языке преимущество смыслового ранжирования растёт. Механизм отказа нужен в обоих случаях, потому что даже лучший кандидат может быть недопустимым.
Источники
Иллюстрация: рисунок из статьи «Selection Is Retrieval, Abstention Is Not: On-Device Tool Routing over 70 Korean-English Actions», Janghoon Lee (Redrob), CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


