
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Увеличение расхода токенов не гарантирует, что ИИ выполнит больше задач. В нерецензированном препринте, где числа получили сами авторы, команда Carnegie Mellon University и Amazon получила больше проверенных решений на миллион токенов, когда заменила максимизацию расхода на максимизацию результата. Такой критерий меняет не только длину ответа, но и момент, когда агенту стоит остановиться.
Исследователи сравнили две заданные стратегии. Максимизация токенов — token-max — поощряет продолжать работу и наращивать вычисления. Максимизация результата — outcome-max — учитывает только независимо проверенные задачи на единицу стоимости: следующий шаг оправдан, пока ожидаемая прибавка к результату окупает дополнительные вычисления.
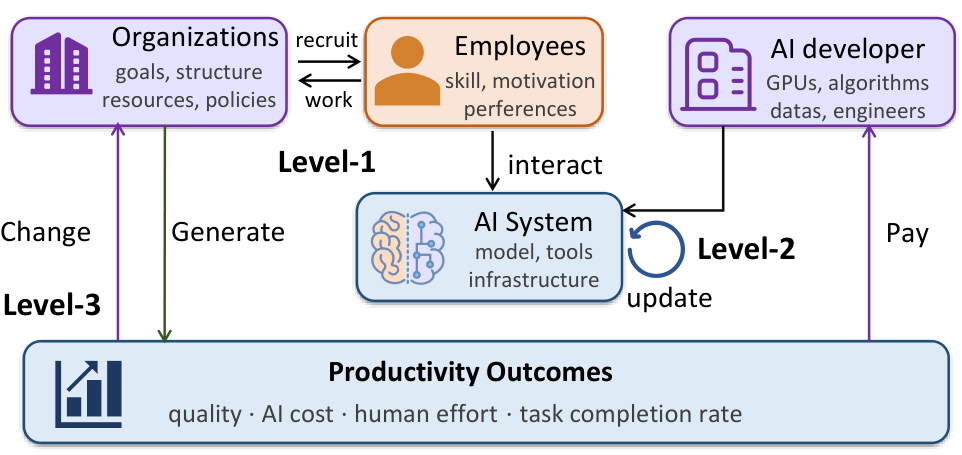
Outcome-max расходовал меньше токенов и давал больше проверенных решений на тот же вычислительный бюджет на всех трёх уровнях симуляции: при выполнении отдельной задачи, при накоплении текстовых правил работы и при отборе сотрудников внутри условной компании. На части сложных задач ранняя остановка ухудшала качество, поэтому метод не сводится к жёсткому лимиту: если дополнительная проверка повышает шанс правильного ответа, вычисления следует продолжить.
Подход проверяли на SWE-bench Verified, HumanEval+, GSM8K и MATH-500. Результат оценивали внешними тестами или сравнением итогового ответа, а производственный агент не видел правильного решения. Сотрудниками выступали LLM с заданными стилями поведения; инструкции прямо предписывали им экономить токены или продолжать взаимодействие. Поэтому работа показывает последствия двух режимов управления, но не доказывает, что тариф или премия сами вызовут такое поведение у людей.
Для внедрения авторы предложили OutcomeShare: компания делит ценность проверенного результата между сотрудником, поставщиком LLM и собой, а за одобренный дефект вводит ответственность. Симуляция показывает, что такая схема может дать выгоду всем сторонам, если проверка достаточно точна, ценность задачи покрывает расходы, а ответственность реально применяется. Практический вывод уже применим без нового контракта: бюджет агента стоит связывать с проверяемым результатом, а не с числом вызовов API или токенов.
Источники
Иллюстрация: рисунок из статьи «From Token-Max to Outcome-Max: How You Use AI Determines Its Productivity», Chen Xu, Mengqiao Liu, Beibei Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


