
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель управления роботом научились улучшать на обычных прогонах после запуска, не отбрасывая неудачные действия и не запрашивая исправления у оператора. В работе Nanyang Technological University и партнёров, которая не прошла рецензирование, а все числа получили сами авторы, PACL достигла успешности 96% на Transport и 93,2% на Square. Для робототехнических команд это превращает накопленные журналы работы в материал для дообучения, если в них сохранены действия, наблюдения и итог задачи.
Почему неудачный прогон нельзя просто добавить в обучение
Diffusion Policy учится воспроизводить действия из демонстраций. После внедрения робот собирает собственные прогоны: часть заканчивается успехом, часть продвигает задачу лишь частично, а часть приводит к ошибке. Если без разбора дообучить модель на всём массиве, она начнёт повторять и полезные, и вредные действия.
Фильтрация только успешных прогонов тоже теряет информацию. Ошибка показывает, какое движение не стоит повторять, но обычное обучение по демонстрациям не умеет использовать такой отрицательный сигнал. Офлайн-обучение с подкреплением решает эту задачу через ожидаемую награду, однако в манипуляции награда часто приходит лишь в конце эпизода: по ней трудно установить, какая именно последовательность движений определила результат.
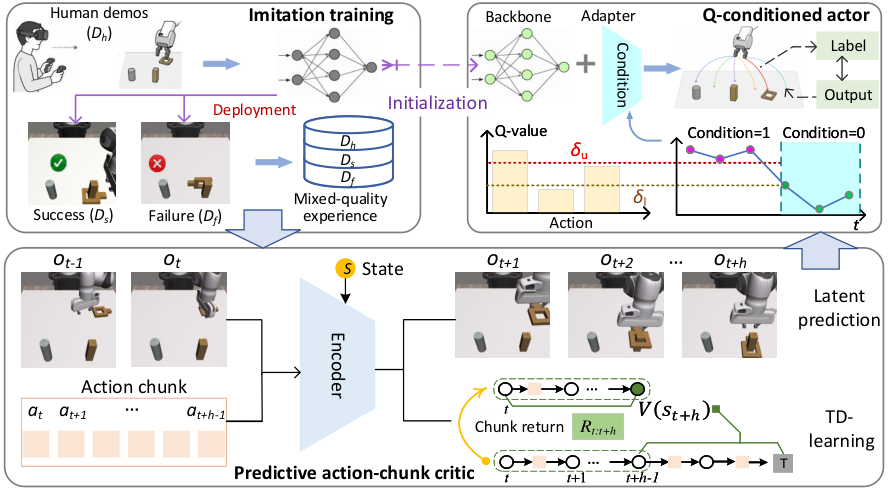
PACL начинает с Diffusion Policy, предварительно обученной на человеческих демонстрациях. Затем политика работает автономно, а каждый прогон получает простой итоговый признак: задача выполнена или нет. Дополнительные корректирующие демонстрации, вмешательства оператора и специально организованное исследование среды для этого этапа не нужны.
Как критик оценивает последовательность действий
Вместо отдельного управляющего сигнала PACL оценивает блок из восьми последовательных действий. Это соответствует устройству Diffusion Policy, которая сразу генерирует согласованный фрагмент движения, а не принимает каждое решение изолированно.
Оценку выдаёт критик — отдельная модель, которая предсказывает ожидаемую суммарную награду для блока. Одной терминальной метки для обучения такого критика мало, поэтому он параллельно предсказывает, как действия изменят скрытое представление будущих наблюдений. Изображение после движения даёт более плотный учебный сигнал: критик должен различать блоки, которые внешне начинаются одинаково, но ведут к разным состояниям.
Полученные оценки превращаются в три условия качества: высокое, низкое и неопределённое. Человеческие демонстрации считаются качественными, а автономные действия размечает критик. Diffusion Policy дообучается на полном массиве, но получает условие качества и поэтому не воспринимает все примеры как равноценные.
При выполнении задачи модель генерирует 12 вариантов следующего блока, после чего критик выбирает вариант с наибольшей ожидаемой наградой. Таким образом, критик влияет на систему дважды: разделяет данные при дообучении и ранжирует движения во время работы.
Когда PACL меняет план разработки
Метод проверили на задачах Robomimic в симуляции и на реальном роботе в PickCup, StackCup и MoveSpoon. На реальных задачах исходную политику обучали по 50 человеческим демонстрациям, а для дообучения собирали ещё 50 автономных прогонов. PACL сравнивали с прямым дообучением, самоимитацией, фильтрацией полезных сегментов и несколькими методами офлайн-обучения с подкреплением.
На Transport и Square PACL показала лучшие заявленные результаты среди сравнений. Отдельный опыт объясняет роль предсказания будущего: при выборе из одинакового набора кандидатов обычный критик достиг 63,6% успешности, а PACL — 86,8%. Добавление неудачных прогонов также улучшало результат по сравнению с обучением только на успешном опыте, то есть ошибки работали как полезный сигнал, а не просто увеличивали датасет.
Работа меняет планы команд, у которых робот уже действует автономно и сохраняет полные траектории вместе с итогом задачи. Вместо проекта по ручной разметке отдельных движений можно сначала проверить более дешёвую схему: оставить человеческие демонстрации опорным набором, сохранить провалы и обучить критик различать последствия блоков действий.
PACL не заменяет начальное обучение и не показывает универсальность за пределами рассмотренных манипуляций. Метод также добавляет отдельный критик и генерацию нескольких кандидатов во время исполнения. Поэтому перед переносом в продукт нужно проверить не только долю успешных задач, но и то, укладывается ли выбор блока в цикл управления конкретного робота.
Источники
Иллюстрация: рисунок из статьи «Learning from Mixed-Quality Deployment Experience for Robot Manipulation», Yangang Ren, Yujie Yan, Zirui Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


