
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
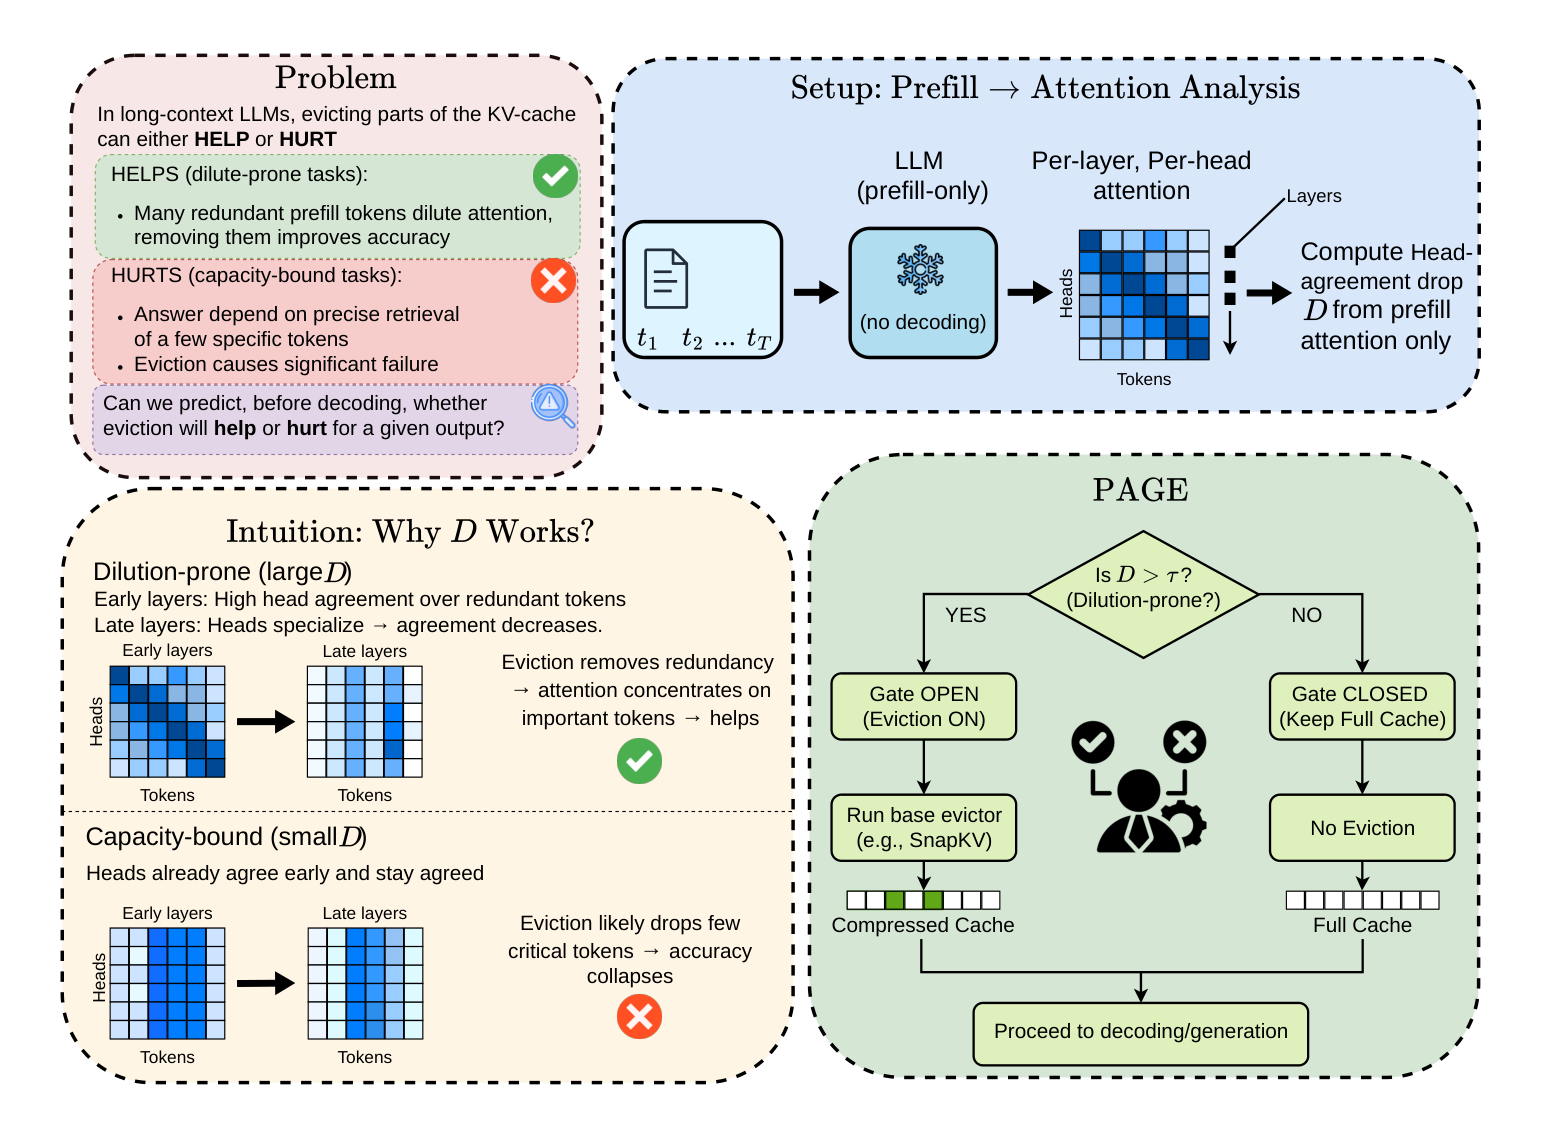
Сжатие KV-кэша научились включать не для всех запросов подряд, а только там, где оно не разрушит ответ. PAGE перед генерацией отсеивает опасные случаи и в испытаниях сократил частоту вреда в 29 раз; это препринт, который не рецензировали, а числа получили сами авторы. Для систем с длинным контекстом идея меняет схему внедрения: к алгоритму удаления записей стоит добавить допуск на уровне отдельного запроса.
Средняя точность скрывает запросы, которым нужен весь кэш
Во время генерации модель хранит в KV-кэше ключи и значения из уже обработанного контекста. Кэш растёт вместе с запросом, поэтому системы удаляют часть записей и оставляют те, которые считают важными.
Большинство таких алгоритмов решает, что удалить, но не проверяет, допустимо ли удаление для конкретного запроса. PAGE добавляет именно эту проверку и разделяет входы на два класса.
В первом классе ответ зависит от небольшого набора критических фрагментов. Любой проверенный бюджет сжатия ухудшает результат: если алгоритм удалил нужную запись, более удачный способ ранжирования остальных записей уже не поможет. Авторы называют такие запросы ограниченными ёмкостью.
Во втором классе контекст содержит похожие отвлекающие фрагменты. Они размывают внимание модели, поэтому выборочное удаление оказывается безопасным, а иногда исправляет ответ. Разница между классами теряется при усреднении: улучшение на одних входах компенсирует полный провал на других.
Эту границу проверяли на RULER с контекстами 4K и 16K, на моделях семейств Qwen и Mistral. Дополнительная проверка на задачах LongBench показала ту же последовательность классов. Основной сигнал получен на синтетических задачах поиска и агрегации, поэтому работу нельзя читать как готовую оценку для произвольного производственного трафика.
Как падение согласия открывает и закрывает допуск
PAGE принимает решение после обработки входного текста, но до генерации первого токена. Ему не нужны правильные ответы, дополнительное обучение или изменение базового алгоритма: SnapKV и другие способы удаления записей остаются внутри системы без доработки.
Сначала PAGE берёт внимание для последних 32 позиций запроса. Для каждой головы внимания он выделяет ключевые позиции, затем измеряет, насколько часто разные головы выбирают одни и те же места. Это согласие отдельно усредняют в ранних и поздних слоях модели.
На выходе получается одно число: насколько согласие голов падает от начала сети к концу. Большое падение указывает на контекст, где отвлекающие фрагменты размывают внимание, — допуск открывается, и базовый алгоритм сжимает кэш. Малое падение указывает на зависимость от ёмкости — PAGE сохраняет кэш целиком.
Порог нельзя без проверки переносить между архитектурами. Рекомендуемый вариант PAGE сначала стандартизирует сигнал на пилотной выборке примерно из 100 неразмеченных запросов для каждой модели. Фиксированный порог работал внутри одной семьи, но ошибался после перехода на другую; повторная настройка без правильных ответов восстановила порядок классов на отложенных моделях.
У метода есть системная цена. PAGE нужны значения внимания по отдельным головам, а объединённая реализация FlashAttention обычно их не материализует. Команде придётся хранить или отдельно вычислять эти данные, поэтому накладные расходы нужно измерять в той же конфигурации ядра, пакетной обработки и длины контекста, которая пойдёт в эксплуатацию.
PAGE меняет управление риском, но не заменяет компрессор
Самый наглядный результат получен на Mistral в задаче точного поиска нескольких ключей. Обычный SnapKV при агрессивном сжатии снизил точность с 99% до нуля. С PAGE точность держалась на уровне 89% по всей сетке бюджетов, потому что допуск чаще оставался закрытым.
Выигрыш сосредоточен именно на опасном классе. Там, где удаление записей уже было безопасным, PAGE обычно открывал допуск и возвращал тот же результат, что базовый алгоритм. Это предохранитель от редкого тяжёлого отказа, а не способ равномерно поднять среднюю точность всех запросов.
За такую избирательность система платит памятью. Реальное сжатие составило 1,8–3,4 раза и оказалось заметно ниже заданного максимума: закрытый допуск сохраняет полный кэш. При статическом резервировании памяти для пакета эффект уменьшается ещё сильнее, поскольку одного несжимаемого запроса достаточно, чтобы выделить полный объём всему пакету.
PAGE имеет смысл добавлять, если продукт уже использует удаление записей KV-кэша и не может принять катастрофический провал на небольшой доле запросов. Для сервиса с жёстким лимитом памяти или крупными статическими пакетами он не решает основную задачу: обученный алгоритм удаления при одинаковом расходе памяти оказался лучше. Практический план — сначала найти опасный класс на собственном трафике, затем проверить перенос порога и только после этого считать память и задержку всей системы.
Источники
Иллюстрация: рисунок из статьи «PAGE: Partition-Aware Gated KV-Cache Eviction», Pankaj Kumar, Subhankar Mishra, CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


