
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Парные выборы пользователя научились напрямую превращать в веса для смешивания специализированных моделей. В работе Monash University, которая не прошла рецензирование и где все численные результаты получили сами авторы, BPM обошёл равномерное слияние во всех трёх проверенных задачах. Если библиотека экспертов уже готова, отдельное дообучение под каждого пользователя можно заменить сбором сравнений, расчётом коэффициентов и одним слиянием.
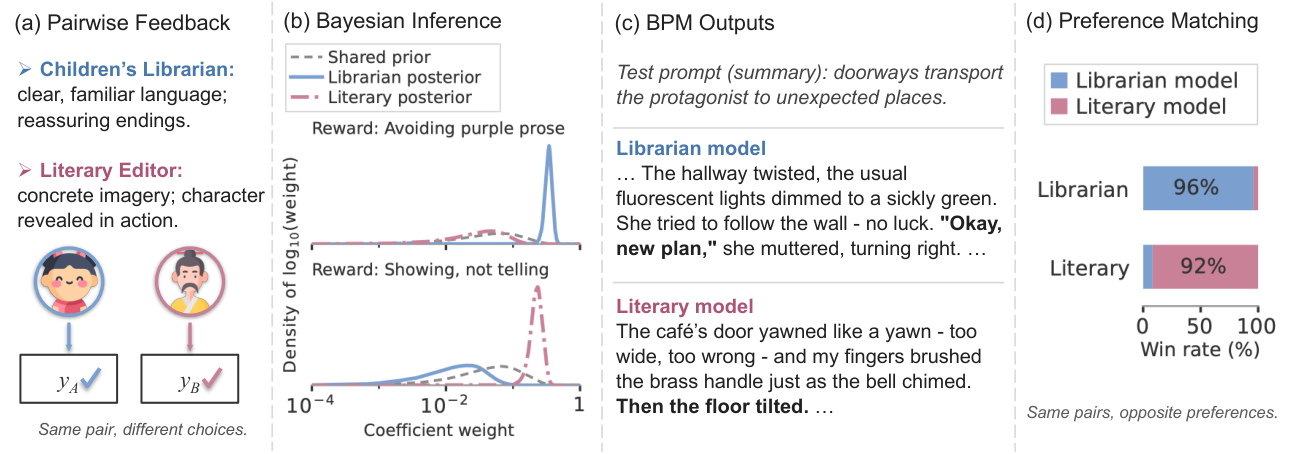
Как выбор между двумя ответами превращается в веса
Метод начинает с общей базовой модели и библиотеки экспертов. Каждый эксперт — это LoRA-адаптер, обученный усиливать отдельное качество: например, точность медицинского резюме, подробность описания изображения или один из критериев хорошего рассказа.
Обычные методы слияния требуют заранее указать, сколько веса дать каждому качеству. BPM получает эти коэффициенты иначе: показывает пользователю два ответа на один запрос и записывает, какой вариант тот предпочёл. Описание пользователя и явный список его приоритетов методу не нужны.
Для каждой пары система вычисляет разницу между ответами по всем функциям награды. Оценки сначала приводят к общей шкале, а затем нормализуют вектор разницы, чтобы метрика с крупными исходными значениями не получила преимущество только из-за масштаба.
Модель Bradley–Terry связывает выбор пользователя со взвешенной суммой этих различий. Дополнительный параметр температуры описывает, насколько последовательно человек реагирует на преимущество одного ответа: низкая температура соответствует более определённому выбору, высокая приближает вероятность к случайной.
Вместо одного наиболее вероятного набора весов BPM строит апостериорное распределение — набор допустимых сочетаний с их вероятностями. Для этого авторы применяют NUTS, алгоритм выборки из сложных вероятностных распределений. Средние веса становятся коэффициентами слияния LoRA-адаптеров, а разброс показывает, какие приоритеты ещё нельзя уверенно восстановить.
До получения обратной связи средние веса одинаковы, поэтому BPM возвращает обычное равномерное слияние. По мере накопления сравнений коэффициенты смещаются к тем экспертам, чьи качества лучше объясняют выбор пользователя.
BPM выиграл у равномерного слияния на разных типах генерации
Метод проверили на составлении кратких выводов из радиологических отчётов, описании изображений и генерации рассказов. Библиотеки построили на Qwen3.5-2B, Qwen3-VL-4B и Ministral-3-3B; для каждой метрики обучали отдельного эксперта, а затем использовали одну и ту же библиотеку для разных персон.
После 100 сохранённых сравнений BPM выигрывал у равномерного слияния в 91,7% решённых пар для радиологических резюме, в 77,1% для описаний изображений и в 64,3% для рассказов. В расчёт решённых пар не входили ничьи и ответы оценщика, которые менялись при перестановке вариантов местами.
Персонализация не свелась к общему улучшению модели. Когда две персоны получали модели по собственной обратной связи, каждая предпочитала свой вариант на общем наборе ответов. Такой же рисунок появился в небольшой проверке с участием людей.
Основной объём проверки всё же опирался на искусственные персоны. Одна LLM получала описание персоны, выбирала ответы для обучения и затем оценивала модели на других входных данных. Разделение входов снижает прямое совпадение примеров, но результат прежде всего показывает согласованность персонализации с заданным симулятором предпочтений.
BPM также сравнивали с восстановлением одной точки весов, переранжированием нескольких ответов, настройкой через системную инструкцию и отдельным обучением политики под персону. Однако центральный результат работы относится именно к сценарию, где уже существуют эксперты по отдельным критериям и их параметры можно линейно смешивать.
Когда метод меняет план разработки
BPM подходит продуктам, где много пользователей или организаций по-разному расставляют приоритеты между одними и теми же измеримыми качествами. Вместо отдельного обучения модели для каждого клиента команда один раз готовит библиотеку экспертов, а затем хранит и применяет персональные коэффициенты.
Это меняет архитектуру персонализации, но не устраняет основную предварительную работу. Нужно определить функции награды, собрать данные для приведения их оценок к общей шкале и обучить экспертов от одной базовой модели. Если продукт пока не умеет измерять нужные качества, BPM не создаст эти критерии из пользовательских кликов.
У метода есть ещё две содержательные предпосылки. Выбор пользователя должен достаточно хорошо описываться постоянной взвешенной суммой известных наград, а смешивание экспертов с теми же весами должно переносить предпочтения в поведение итоговой модели. Точная оценка приоритетов сама по себе не гарантирует, что линейное слияние даст нужный ответ.
Поэтому перед заменой пользовательского дообучения стоит проверить всю цепочку на собственных данных: сравнить персональное слияние с равномерным, убедиться, что изменение коэффициента действительно меняет нужное качество, и посмотреть на ширину распределения весов. Если допустимых сочетаний остаётся много, системе лучше запросить дополнительные сравнения, а не выдавать коэффициенты за точный профиль пользователя.
Практический вывод узкий: BPM не предлагает новую универсальную модель, а закрывает недостающий слой между интерфейсом выбора и готовой библиотекой экспертов. Для продуктов, которые уже планировали многокритериальное слияние LoRA-адаптеров, это повод заменить ручную настройку весов на парную обратную связь. Для остальных сначала остаётся доказать, что библиотека экспертов окупает обучение и что её критерии совпадают с реальными предпочтениями.
Источники
Иллюстрация: рисунок из статьи «The Missing Coefficients: Bayesian Pairwise Merging for Model Personalization», Yaling Shen, Tongtong Wu, Siyuan Yan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


