
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
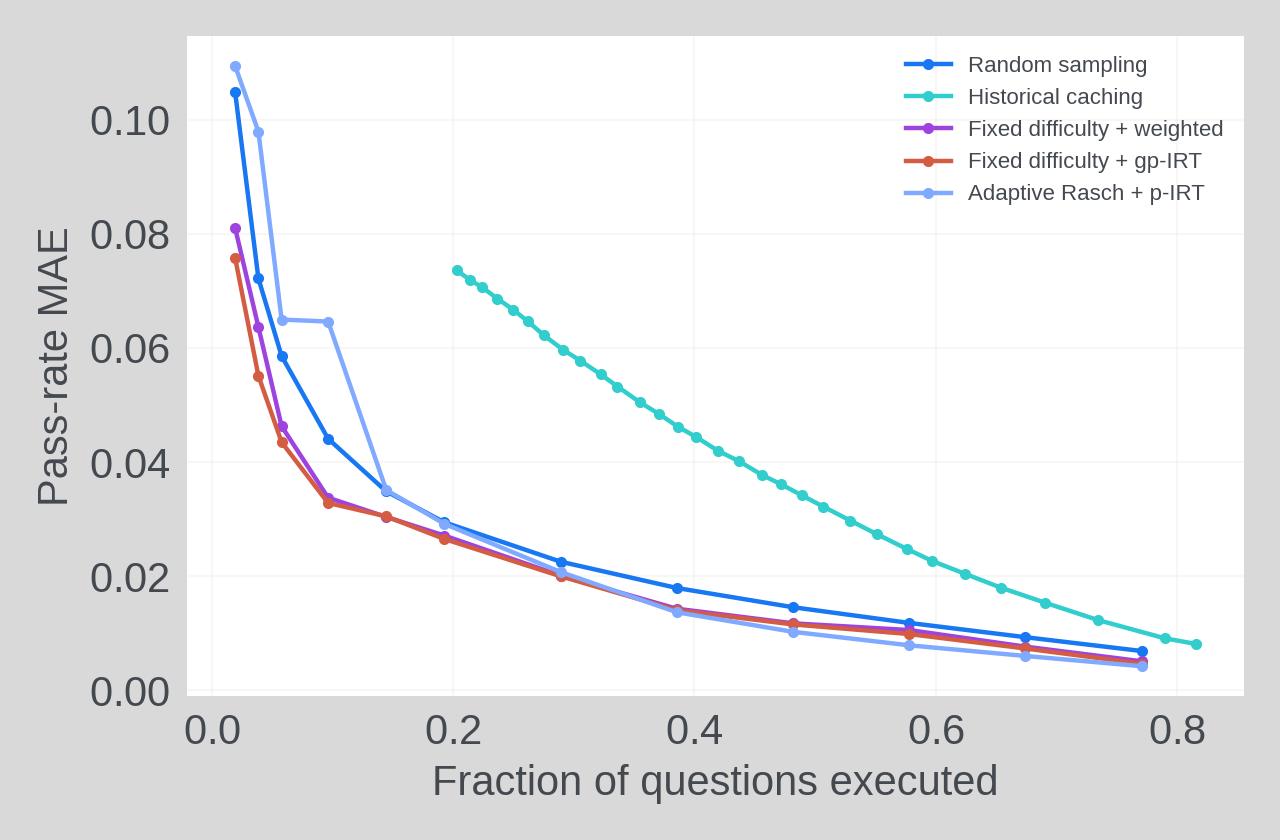
Повторную оценку меняющегося LLM-агента можно сократить больше чем вдвое и сохранить близкий к полному прогону результат. Работа Carnegie Mellon University и Meta пока не рецензирована, а все числа получили сами авторы: при выполнении 200 из 519 заданий ошибка оценки доли успешных ответов составила 1,03 процентного пункта. Для команд с дорогими агентными тестами это превращает выбор подвыборки из эвристики в измеримый компромисс.
Авторы сравнили случайную выборку, повторное использование стабильных исторических ответов, постоянные наборы заданий и адаптивную проверку. Последняя выбирает следующий вопрос по результатам уже выполненных: многомерная модель 2PL учитывает сложность задания и то, насколько хорошо оно различает версии агента. Затем модель восстанавливает ожидаемый результат полного бенчмарка.
Адаптивный вариант точнее всего оценивал итоговый балл, однако команда внедрила фиксированные подвыборки, разбитые по сложности. Их можно выполнять параллельно, состав работы известен заранее, а одинаковые задания позволяют разбирать изменения поведения между версиями. Адаптивной проверке нужны последовательный запуск, состояние для каждого прогона и пересчёт после каждого ответа.
Историческое кеширование оказалось менее точным при сопоставимой доле выполненных заданий: прежний ответ на обычно стабильный вопрос может устареть после изменения модели, подсказки или инструмента. Поэтому такой способ требует контроля устаревших результатов, тогда как фиксированный набор каждый раз получает свежие ответы.
Проверку провели на 574 исторических прогонах производственного аналитического агента за 52 дня; полный бенчмарк занимал около трёх часов. Прогоны разделили по времени на калибровочную и контрольную части, чтобы методы не использовали будущие результаты. Данные относятся к одному внутреннему бенчмарку одной организации, но фиксированную подвыборку также перенесли без повторной настройки на пять других семейств агентов.
Практический выбор зависит от инфраструктуры. Если система умеет последовательно управлять заданиями, адаптивная проверка даёт наименьшую ошибку. Если важны параллельный запуск, предсказуемая нагрузка и разбор регрессий по одним и тем же вопросам, фиксированная выборка по сложности уступает в точности, но проще работает в производственном процессе.
Источники
Иллюстрация: рисунок из статьи «Efficient Benchmarking in Production: A Study of an Evolving LLM Agent», Yining She, Lei Lin, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


