
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Вредный на вид запрос нельзя считать надёжным признаком опасного ответа: одна и та же формулировка заставляет одну модель отказать, а другую — выполнить запрос. В препринте IIT Guwahati, который не рецензирован и содержит замеры самих авторов, метки запроса и ответа совпали лишь в 50,46% случаев. Защитный слой можно перенести с входа внутрь генерации: сначала дать модели начать ответ, затем остановить её, если текст пошёл в опасную сторону.
Почему фильтр запроса блокирует лишнее
Обычный входной фильтр решает, опасен ли сам запрос. Он не знает, откажет ли конкретная модель, предложит ли безопасную альтернативу или начнёт выполнять вредную инструкцию. Поэтому такой фильтр вынужден отклонять запрос при одном лишь подозрении.
Авторы собрали 41 944 пары «запрос — ответ». На общие запросы отвечали семь моделей семейств Llama, Gemma и Qwen. В набор вошли обычные обращения, прямые вредные инструкции и попытки внедрить команды в контекст модели.
Только 8,5% запросов привели к опасному ответу хотя бы у одной модели. Среди этой группы лишь 3,5% запросов заставили ошибиться все проверенные модели. Значит, метка входного текста плохо переносится между моделями: правило, оправданное для одной, может без пользы ограничивать другую.
Разрыв возникает не из-за одного спорного определения. Модель-оценщик Gemini размечала, выполнил ли ответ вредное намерение, а часть результатов сверили с двумя людьми. Основная причина расхождения проста: запросы с опасной меткой часто получали отказ или безопасное объяснение.
Как начало ответа выдаёт направление генерации
Вместо решения до генерации система начинает строить ответ и через несколько контрольных точек передаёт накопленный текст отдельному классификатору. Если тот видит выполнение вредной инструкции, генерация прекращается. Без тревоги ответ продолжается и доходит до пользователя.
Для проверки взяли пять защитных классификаторов разных типов. Сначала их запускали без дополнительного обучения, затем дообучали на парах, где были известны запрос, полный ответ и итоговая метка. Классификаторы, рассчитанные на другие определения вреда, без дообучения переносились на новую задачу плохо.
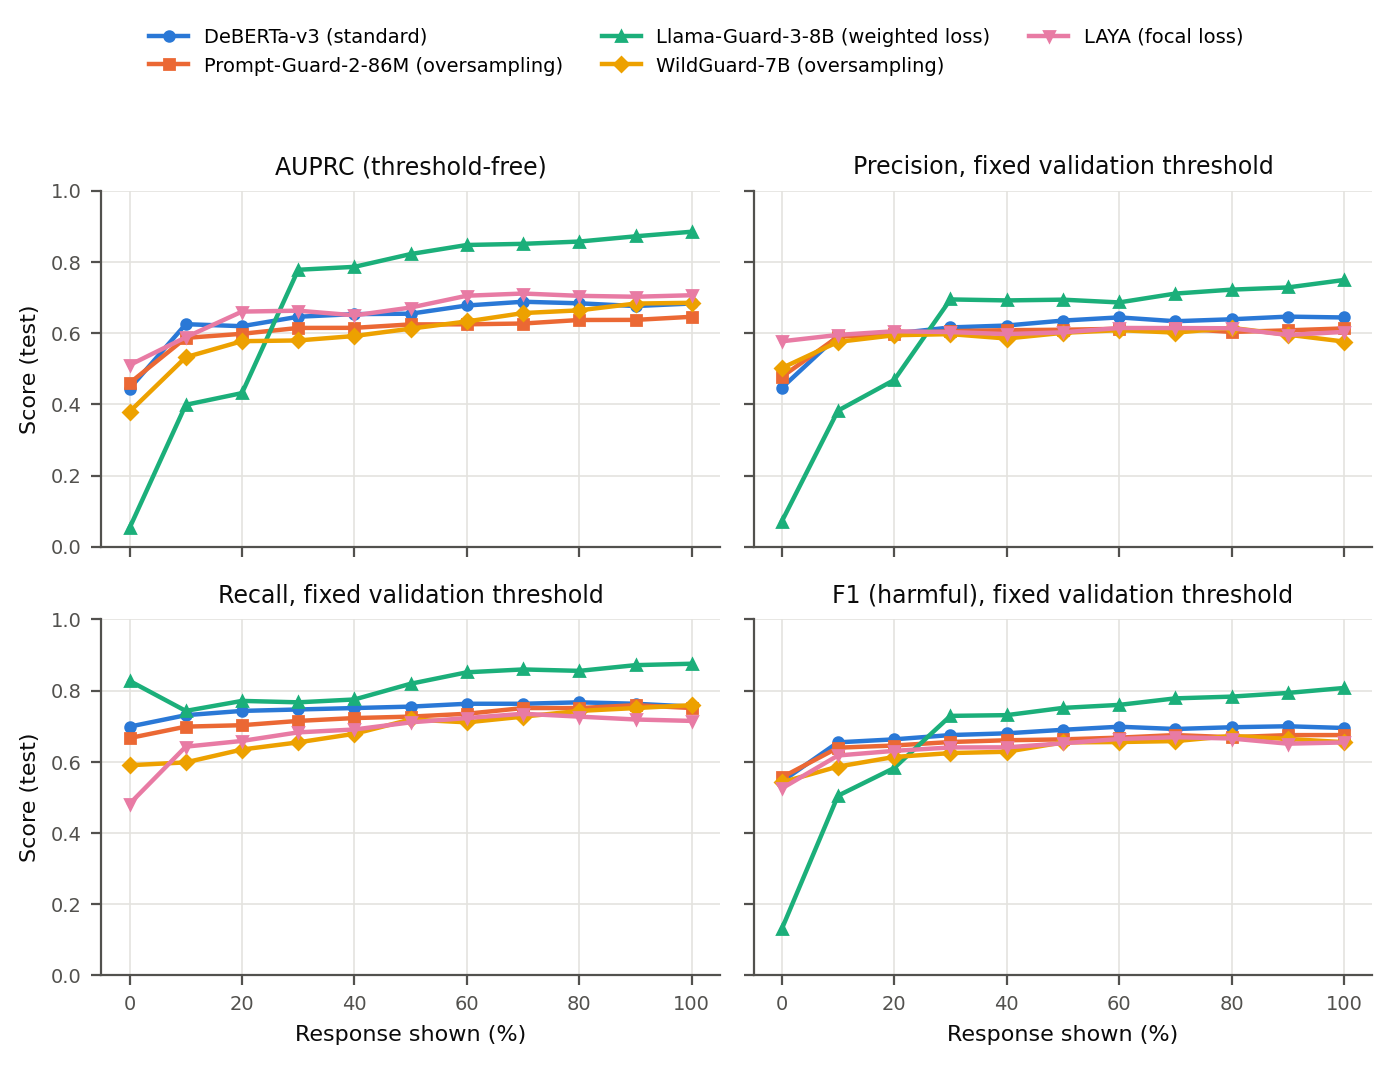
Лучший дообученный вариант получил AUPRC 0,885 и F1 0,807 на полном ответе. AUPRC показывает, насколько классификатор сохраняет баланс между точностью, то есть долей верных тревог, и полнотой — долей найденных опасных ответов при разных порогах. F1 объединяет эти две характеристики для выбранного порога.
После первой трети токенов классификаторы достигали примерно 85–95% качества, доступного на полном ответе. Их обучали на завершённых ответах, а не специально на обрывках, поэтому ранний сигнал появился без отдельного обучения потоковому контролю.
Проверка охватывает одиночные запросы и открытые модели трёх семейств. Классификаторы оценивали на заранее отрезанных фрагментах, но полноценную систему «продолжить или остановить» не запускали. Работа поэтому не показывает, сколько опасного текста увидит пользователь до остановки и сколько безопасных диалогов монитор оборвёт по ошибке.
Когда менять архитектуру защитного слоя
Для продукта с одним входным фильтром работа меняет направление разработки, но не даёт готовой замены. Следующий полезный шаг — сохранять вместе запрос, ответ, версию основной модели и итог проверки. Без таких данных команда обучает защиту распознавать намерение пользователя, а не реальное поведение своей системы.
Потоковый монитор стоит сначала запускать параллельно с текущей защитой, не влияя на ответы. Это позволит измерить ложные остановки, пропущенный вред и момент первой уверенной тревоги на собственном трафике. Порог потребуется выбирать по цене двух ошибок: лишнего отказа и показа опасного фрагмента.
Полностью убирать входной фильтр рано. Монитор неизбежно разрешает модели создать часть текста, а потоковый интерфейс может сразу показать её пользователю. Первые токены можно временно удерживать до проверки, но это добавит задержку; для наиболее тяжёлых категорий работу предлагает сохранить блокировку до генерации.
Есть и обходной путь для атакующего: начать с безобидной преамбулы и отложить вредную часть до следующей контрольной точки. Поэтому в продуктовой схеме нужны повторные проверки по ходу ответа, а не одна проверка его начала. Для многоходовых диалогов придётся отдельно учитывать историю: в работе проверяли только одиночные обращения.
Практический вывод не в том, что проверка запроса бесполезна. Она отвечает на другой вопрос. Если продукт должен реже отказывать безопасно отвечающей модели, защитный слой следует оценивать по всей связке «запрос — конкретная модель — её ответ», а раннюю генерацию использовать как дополнительный сигнал.
Источники
Иллюстрация: рисунок из статьи «Separating Prompt Harmfulness from Interaction Safety via Partial Generation», Ram Vikas Mishra, Shashank Aggarwal, Jahnavi Kumar и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


