
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Расширение памяти и повторная самонастройка не гарантируют, что LLM-агент лучше усвоит предпочтения пользователя. В работе Renmin University of China лучшие алгоритмы после 24 взаимодействий нарушали правила примерно в семь раз чаще эталона: 0,48 против 0,071, однако препринт пока не рецензирован, а числа получили сами авторы. Для продукта это разделяет три причины ошибок: неподходящую архитектуру, лишний контекст и неточную процедуру обновления.
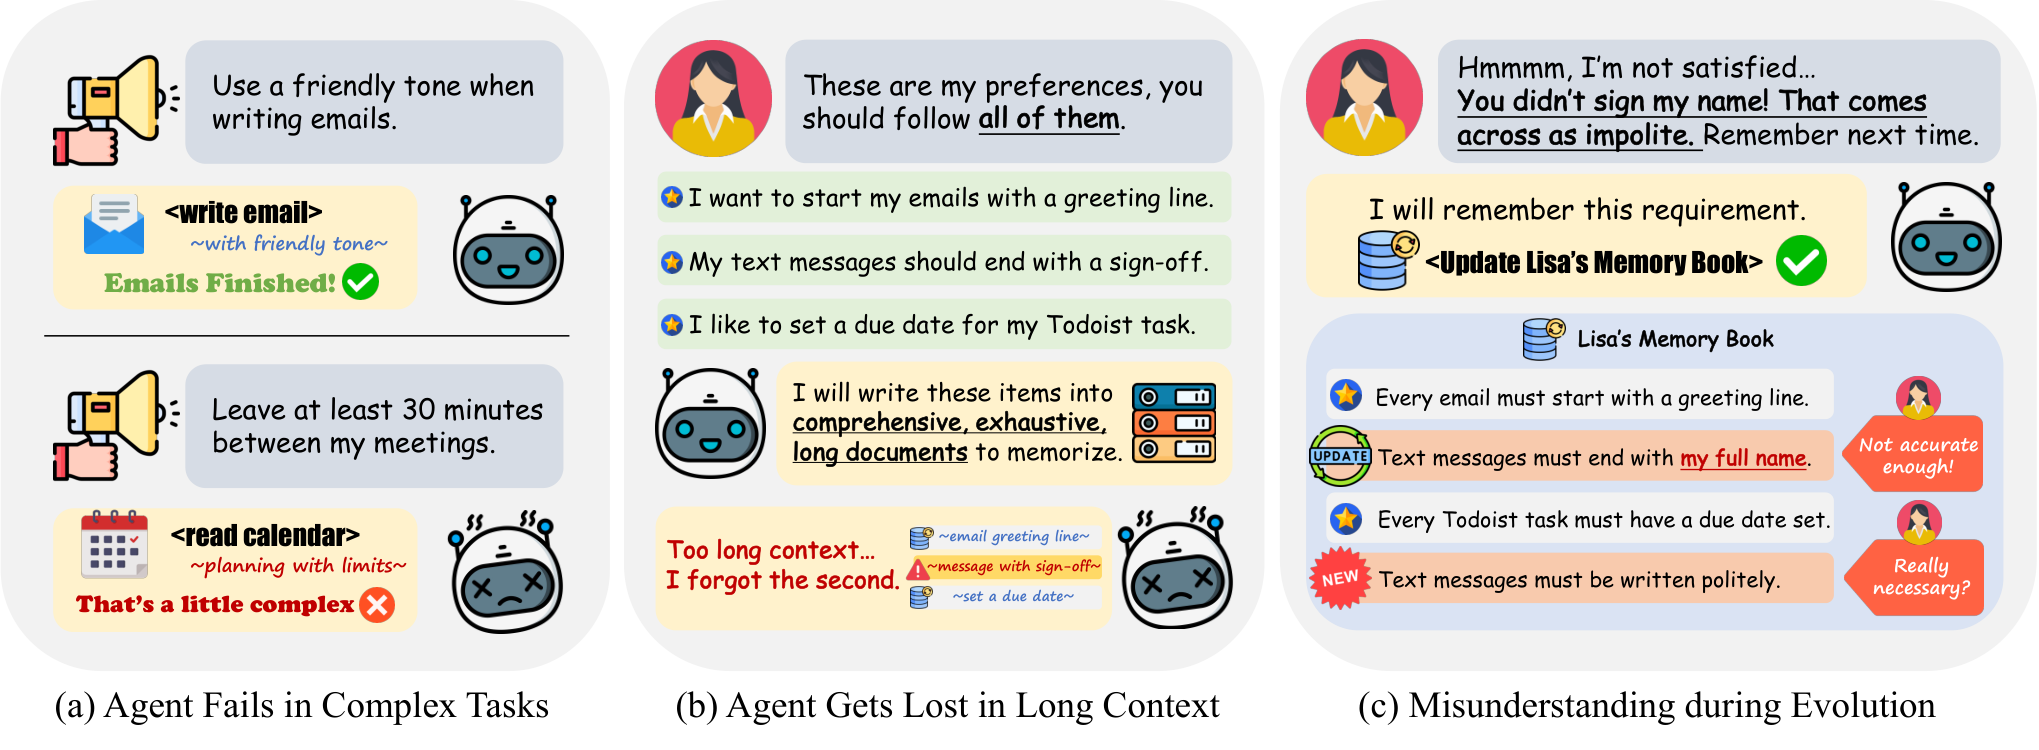
Авторы изучили обвязку агента (agent harness) — слой вокруг неизменяемой LLM, который собирает контекст, хранит память, подключает инструменты и контролирует действия. Они разложили ошибки персонализации на три группы: обвязка в принципе не умеет выразить нужное правило; объём памяти не соответствует накопленному опыту; алгоритм неверно перерабатывает обратную связь.
Текстовая память справлялась с локальными требованиями вроде подписи в сообщении или шаблона платёжной заметки. Правила, которым нужны точные вычисления, история действий или вмешательство в вызов API, надёжнее исполняла управляющая обвязка. Поэтому хранить требование «считать общую сумму расходов» в системной инструкции недостаточно: агенту нужен отдельный счётчик или проверка действия.
Увеличение памяти давало немонотонный результат: новые инструкции могли помогать, а затем мешать уже сохранённым правилам. Практический вывод — оценивать не длину контекста, а соблюдение каждого правила на отложенных задачах и удалять конфликтующие записи.
Проверку провели в AppWorld-P — среде с повседневными задачами через API и программно проверяемыми предпочтениями. Во всех опытах использовали claude-haiku-4-5-20251001; сравнивали текстовую и управляющую обвязки, память разного размера и четыре способа самонастройки. Результаты относятся к одной модели, заданным наборам предпочтений и симулированным приложениям, но дают полезную схему диагностики: сначала проверить, может ли архитектура выполнить правило, затем подобрать объём памяти и только после этого менять алгоритм обновления.
Источники
Иллюстрация: рисунок из статьи «Harness Evolution as Learning: Approximation, Generalization, and Optimization Limits of Self-Improving Personal Agents», Zeyu Gan, Zixuan Gong, Yong Liu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


