
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Диффузионную языковую модель с маскированием удалось дообучить, меняя лишь те токены, которые сильнее всего определяют оставшийся ответ. В нерецензированном препринте, где все числа получили сами авторы, Pivot-SD использовал десять токенов из каждой траектории и обошёл полное обучение на ответах и сопоставимое по бюджету обучение с подкреплением. Для такого дообучения не нужно заново генерировать ответы после каждого обновления модели.
Как измеряли важность шага
Обычная авторегрессионная модель пишет текст слева направо. Диффузионная модель начинает с замаскированного ответа и постепенно открывает позиции в том порядке, в котором становится уверена в токенах. Последовательность таких состояний образует траекторию генерации.
Отдельное решение записать токен в конкретную позицию авторы называют обязательством. Раннее обязательство может задать формулу, оператор или часть программы и тем самым сузить варианты для ещё закрытых позиций. Токен, добавленный почти в конце, обычно влияет на меньшую часть ответа.
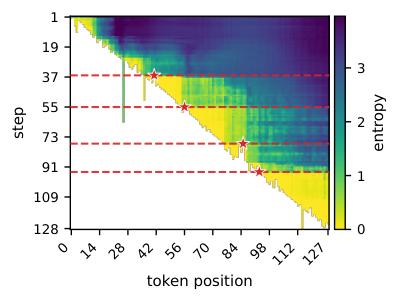
Pivot-SD оценивает каждый шаг по тому, насколько после него падает энтропия оставшихся позиций. Энтропия здесь показывает неопределённость модели: чем она ниже, тем меньше вариантов модель считает вероятными. Разницу усредняют по позициям, которые остались закрытыми, поэтому ранние шаги не получают преимущество только из-за размера незаполненного ответа.
Шаги с наибольшим падением неопределённости становятся поворотными, а записанные на них токены — целями обучения. Оценка использует вероятности, которые модель уже вычисляет при генерации, поэтому отбор не требует дополнительных прогонов. Для каждой цели сохраняют частично замаскированное состояние, чтобы затем воспроизвести именно тот контекст, в котором модель приняла решение.
Если итоговый ответ верен, обучение повышает вероятность поворотного токена. Если ответ ошибочен, отдельный штраф снижает его вероятность, но не затрагивает остальные части траектории. Это позволяет сохранить правильную алгебру или синтаксис программы вокруг решения, которое увело генерацию в неверную сторону.
Локальный штраф оказался точнее обучения на всём ответе
Основные эксперименты охватывают MATH, GSM8K, HumanEval+ и MBPP+. На MATH точность LLaDA-8B-Instruct выросла с 31,40 до 37,47, а на HumanEval+ — с 32,32 до 40,43. Pivot-SD также показал лучший результат среди сравниваемых методов на остальных задачах при той же длине генерации.
Проверки отдельных компонентов показали, что важны обе части метода. Если штрафовать все закрытые токены в выбранном состоянии, модель задевает полезные фрагменты ошибочного решения. Если выбирать случайный шаг или случайный токен, преимущество пропадает; в одном из вариантов результат оказался хуже исходной модели.
Траектории генерируют один раз замороженной базовой моделью, после чего обучение работает с сохранённым набором состояний. По расчёту вычислительных операций Pivot-SD потребовал примерно на 40% меньше ресурсов, чем варианты обучения с подкреплением при сопоставимом бюджете. Причина не в более дешёвой генерации одного ответа, а в том, что новые ответы не приходится получать на протяжении всего обучения.
Когда метод меняет план разработки
Работа относится именно к диффузионным языковым моделям с маскированием. Их порядок заполнения позиций несёт информацию, которой нет в финальном тексте и которую не даёт обычная генерация слева направо. Поэтому Pivot-SD нельзя напрямую перенести на авторегрессионную LLM как ещё один способ выбирать важные токены.
Для команды, которая уже рассматривает LLaDA или Dream, метод предлагает альтернативу интерактивному обучению с подкреплением. Нужны сохранённые промежуточные состояния, распределения вероятностей на каждом шаге и проверка правильности конечного ответа. Если для задачи можно написать надёжный проверяющий модуль, отрицательные примеры превращаются в локальные сигналы обучения без отдельной модели, оценивающей каждый шаг рассуждения.
Масштаб проверки пока узок: две базовые модели близкого размера, задачи по математике и коду, по 200 обучающих вопросов на домен и четыре траектории на вопрос. Авторы сравнили метод с полным обучением на эталонных и собственных ответах, а также с diffu-GRPO и wd1++. Для длинных рассуждений, которые проходят через несколько блоков диффузии, правила выбора поворотных токенов ещё потребуется расширить.
Практический вывод не в том, что диффузионные модели теперь следует предпочесть авторегрессионным. Но если продукт уже строится на генерации с маскированием, хранить полную траекторию полезнее, чем оставлять только готовый ответ: несколько решений внутри неё могут дать более точный и дешёвый сигнал для дообучения.
Источники
Иллюстрация: рисунок из статьи «Pivot-SD: Efficient Self-Distillation for Masked Diffusion Language Models», Seo Hyun Kim, Sunwoo Hong, Younwoo Choi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


