
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Планировщик научили находить дальние цели по опыту, собранному ещё до постановки задачи, без меток награды и дообучения правила выбора действий. Deqian Kong с коллегами получили в cube-single долю успешных эпизодов 0,92 против 0,74 у LeWM. Хотя препринт не рецензирован и числа получили сами авторы, работа предлагает практическую схему для систем, которым цели задают уже после сбора данных.
Как случайные траектории превращаются в карту
Основная модель получает пары наблюдений из одной траектории: исходное состояние и состояние, встретившееся через заданный временной горизонт. Горизонт показывает, сколько шагов разделяет пару. Метки действий и награды для этой части обучения не нужны.
Модель учится отличать настоящие временные пары от ложных, где второе наблюдение выбрали независимо. В результате она оценивает, насколько вероятнее цель встретится после исходного состояния, чем просто попадётся в наборе данных. Это отношение важнее обычной близости: точка за стеной может находиться рядом по координатам, но оставаться далёкой по доступному маршруту.
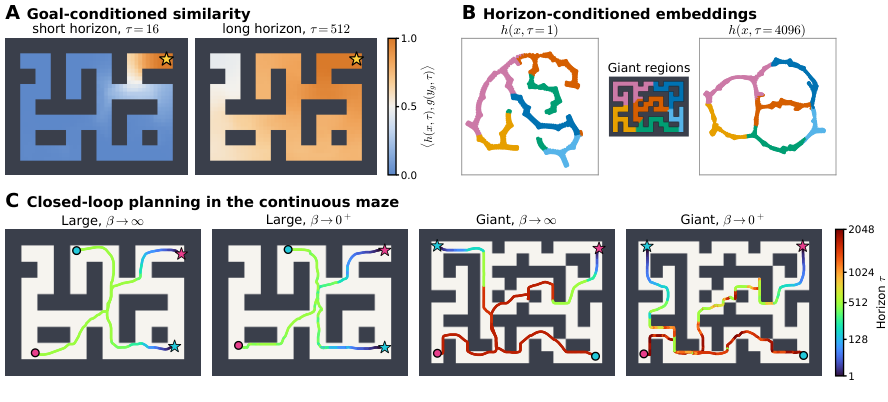
Одна энергетическая модель обслуживает разные горизонты. Для короткого горизонта представление сохраняет локальную геометрию и различает ближайшие проходы. Для длинного оно показывает связи между областями — например, какие комнаты соединяет узкий коридор, — пока случайное блуждание не перемешает состояния и не сотрёт различия.
Выбор действия требует второй модели. Локальная динамика получает состояние и действие, затем предсказывает следующее наблюдение. Дальняя модель оценивает, какой из этих исходов сильнее приближает цель на разных горизонтах. Поэтому обучение без меток действий относится только к карте временных связей: предсказателю следующего шага всё равно нужны переходы с указанными действиями.
Планировщик либо выбирает действие с лучшим улучшением на одном горизонте, либо суммирует улучшения по всем масштабам. После исполнения он берёт фактическое наблюдение и строит план заново. Ошибка локальной динамики не накапливается по длинной цепочке, как при многократном прокручивании модели мира вперёд.
Дальняя навигация зависит и от объёма, и от охвата
Теоретический разбор опирается на симметричное случайное блуждание. При этих условиях короткие горизонты приближают расстояние по кратчайшему доступному пути, а длинные выделяют области, между которыми агент перемещается медленно. Полезный масштаб меняется по дороге: вдали от цели нужен обзор связей между регионами, рядом — точная локальная геометрия.
Эксперименты охватили навигацию в PointMaze Large и Giant по состояниям и изображениям, движение от первого лица в Habitat, а также перенос куба по пиксельным наблюдениям. Основные модели лабиринтов учили на 4 млн случайных переходов. Для манипуляции использовали экспертные и неоптимальные траектории, поэтому метод не требует строго случайного поведения во всех задачах.
Одного посещения каждой области оказалось недостаточно. На Large увеличение длины прогулки с 0,1 млн до 1 млн шагов подняло долю успеха жадного планировщика с 0,45 до 0,91. Отдельные опыты с искусственно урезанным доступом к лабиринту показали, что разнообразие переходов не заменяет покрытие: модель должна увидеть связи между нужными регионами.
Проверки проходили внутри тех сред, по которым собирали обучающие траектории. Работа показывает планирование для новых целей и стартовых точек, но не перенос временной карты в незнакомое помещение. В навигации от первого лица модели также помогали явные координаты: одного кадра иногда недостаточно, чтобы понять положение агента.
Когда схема меняет архитектуру продукта
Работа предлагает отделить знание о достижимости цели от знания о последствиях действия. Вместо единой модели мира с длинными прогнозами можно учить многомасштабную карту по всем наблюдениям, а действия использовать только для локального предсказателя. Такое разделение подходит роботам, складским агентам и симуляторам, где накоплено много исследовательских траекторий, но цели и награды меняются.
Планы стоит пересмотреть, если система сейчас требует отдельного обучения политики для каждой цели. В новой схеме временное представление остаётся фиксированным: при смене цели планировщик просто сравнивает с ней исходы доступных действий. Не требуется и запрашивать симулятор для проверки каждого кандидата перед исполнением — исход предсказывает локальная модель.
Схема не отменяет сбор данных. Случайное исследование должно покрывать переходы между значимыми областями, а локальный предсказатель — достаточно точно различать ближайшие исходы. Слишком длинные горизонты тоже могут навредить: в опытах они начинали доминировать для состояний, слабо представленных при обучении.
Для прототипа разумно разнести проверку на две части: сначала измерить, различает ли временная модель достижимые и недостижимые пары, затем проверить замкнутое планирование на отложенных комбинациях старта и цели. Если среда часто меняется целиком или наблюдение не определяет состояние, работа пока не даёт основания заменять модель мира либо историю наблюдений одной такой картой.
Источники
Иллюстрация: рисунок из статьи «Learning to Plan from Random Exploration», Deqian Kong, Guangyan Sun, Sheng Cheng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


