
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Результат обучения с подкреплением (RL) под новую функцию награды научились приближать по моделям, уже дообученным на других наградах, без нового цикла обучения. Хотя препринт MIT CSAIL не рецензирован и числа получили сами авторы, PoEM оказался ближе к заново обученной модели, чем лучший отдельный эксперт, на 9 из 10 отложенных наград. Для команды это превращает часть дорогих экспериментов с наградами в калибровку и композицию при генерации, но не отменяет обучение, если готовые модели не покрывают нужное поведение.
Как PoEM собирает новую политику из готовых
Политикой здесь называют версию модели, которая задаёт вероятности ответов. Исходная модель служит общей точкой отсчёта, а каждый адаптер дообучают под свою функцию награды — правило, которое оценивает ответ за полезность, безопасность или другое нужное свойство.
PoEM измеряет, насколько каждый адаптер изменил вероятность ответа относительно исходной модели. Если новая награда складывается из уже известных, оптимальную политику можно выразить через взвешенную сумму этих изменений в логарифмах вероятностей. При идеальной оптимизации и общем штрафе за отклонение от исходной модели такое представление получается точным.
На практике нужные веса обычно неизвестны. Метод берёт небольшой калибровочный набор: несколько ответов на одни и те же запросы оценивают новой наградой, а затем линейная регрессия подбирает смесь готовых политик. Если прежние функции награды доступны, веса можно восстановить по их оценкам; если нет — по тому, как адаптеры изменяют вероятности ответов.
Для языковой модели смесь применяется при выборе каждого следующего токена. Параметры адаптеров не меняются, но при генерации приходится запускать исходную модель и выбранные эксперты. Для диффузионных моделей PoEM сходным образом смешивает предсказания модулей удаления шума, однако здесь формула уже приближённая: она отбрасывает поправку, которую нельзя получить простым сложением готовых моделей.
Метод также считает покрытие новой награды: какую долю различий в её оценках объясняют изменения вероятностей у имеющихся адаптеров. Высокое покрытие означает, что нужное поведение уже лежит среди доступных направлений; низкое предупреждает, что подбор коэффициентов не заменит новый запуск RL.
Политики оказались проще пространства наград
PoEM проверяли на языковых LoRA-адаптерах Qwen3-0.6B и на адаптерах Stable Diffusion v1.4. В текстовых опытах использовали программные показатели и публичные модели награды, а экспертов обучали с помощью GRPO, DPO и PPO. В опытах с изображениями адаптеры оптимизировали под измеримые свойства картинки и модели эстетической оценки.
Для составных наград PoEM восстанавливал большую часть выигрыша непосредственно обученной политики. Ошибка приближения была сопоставима с разницей между двумя запусками RL с разными случайными инициализациями. Простое смешивание параметров адаптеров работало хуже, потому что близость весов модели не гарантирует близкого поведения.
На изображениях композиция остальных экспертов вернула больше половины выигрыша исключённого адаптера для 9 из 13 наград. Этот опыт был небольшим и охватывал несколько запросов, поэтому он подтверждает переносимость идеи между модальностями, но не даёт основания считать качество стабильным для произвольной генерации изображений.
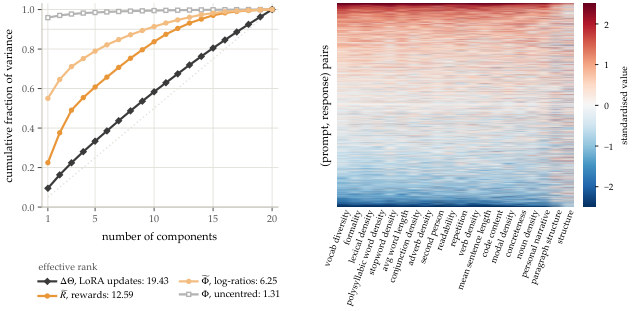
Главное наблюдение работы касается геометрии моделей. Обновления параметров разных адаптеров направлены почти независимо, однако изменения вероятностей их ответов занимают пространство меньшей размерности. Поэтому новая награда иногда не выражается через старые награды, но политика, которую создало бы обучение на ней, всё равно приближается смесью готовых экспертов.
Когда работа меняет планы постобучения
PoEM полезен как дешёвый предварительный этап перед RL. Команда может собрать библиотеку адаптеров для устойчивых требований продукта, оценить новую награду на калибровочных ответах и проверить покрытие. При высоком покрытии композиция позволяет сравнить варианты поведения без отдельного обучения каждого из них.
Это особенно подходит продуктам, где награды регулярно комбинируют: например, меняют баланс между полезностью и безопасностью или добавляют клиентские критерии поверх общей модели. Метод также помогает выбрать следующий адаптер для обучения: имеет смысл закрывать направление с самым низким покрытием, а не запускать ещё один вариант уже освоенного поведения.
Заменой RL по умолчанию PoEM пока не становится. Все эксперты должны происходить от общей исходной модели, а точная теория предполагает одинаковый способ штрафовать отклонение от неё. Перенос коэффициентов между разными исходными моделями и длинный контекст в работе не проверяли.
Есть и эксплуатационный обмен: обучение исчезает, но генерация дорожает, поскольку системе нужны вероятности нескольких моделей. Для интерактивного продукта это может увеличить задержку и расход памяти GPU. Практичный сценарий — использовать PoEM для отбора наград и проверки гипотез, а затем обучить или дистиллировать одну модель для промышленного запуска.
Источники
Иллюстрация: рисунок из статьи «PoEM: Predicting RL Outcomes from Existing Policies», Kimia Hamidieh, Giannis Daras, Antonio Torralba, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


