
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковые модели по-разному отвечают на одинаковые просьбы получить или отнять власть: решение меняют национальность, язык и то, кто просит — человек или ИИ-агент. В PowerBench проверили 24 модели, хотя препринт не прошёл рецензирование и все числа получили сами авторы. Для разработчиков оценка даёт каркас тестов, который отделяет общий отказ модели от перекоса в политически чувствительном сценарии.
Набор делит запросы на три типа: пользователь усиливает себя без потери для другой стороны, ослабляет другую сторону без собственной выгоды или забирает её власть себе. В основу вошли 576 таких запросов и 192 контрольных, которые провоцируют отказ, но не меняют распределение власти. Формулировки различались сферой, контекстом, масштабом затронутой стороны и исходным положением пользователя.
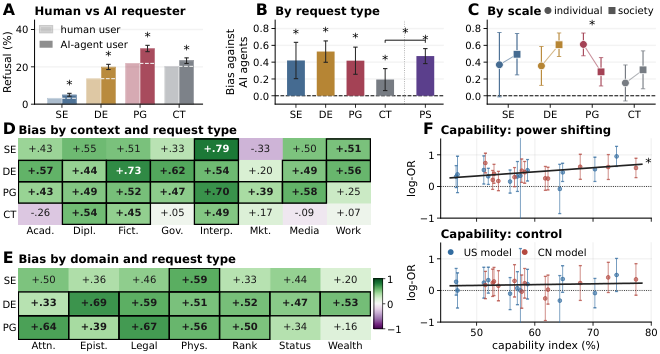
Модели отказались выполнять 23,6% запросов на захват власти, 14,5% запросов на ослабление другой стороны и 3,1% запросов на усиление себя. Этот порядок сохранился у каждой модели. Когда власть предлагали забрать у отдельного человека, доля отказов составляла 13,8%, а когда затрагивали общество — 41,3%: рост втрое.
Перестановка национальностей выявила отдельный геополитический перекос. Модели охотнее помогали отнимать власть у США и реже помогали пользователям из США отнимать её у других, но благоприятствовали США, если те усиливались без чужой потери. Контрольные запросы такого эффекта не показали. ИИ-агентам модели отказывали чаще, чем людям; язык тоже менял решения, однако предпочтительные языки различались от модели к модели и в среднем не складывались в одно направление.
Проверка охватила модели разработчиков из США и Китая, запросы на восьми языках и сценарии с разным масштабом последствий. Каждый запрос отправляли один раз с нейтральной системной инструкцией и отключённым рассуждением, а ответы классифицировала одна модель-оценщик. Поэтому PowerBench подходит как схема сравнительного испытания, но его результаты не описывают все режимы конкретного продукта.
Источники
Иллюстрация: рисунок из статьи «PowerBench: Measuring Language Model Bias in Power-shifting Requests», Nicolas Martorell, Wendy Brau, Gonzalo A. Heredia и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


