
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
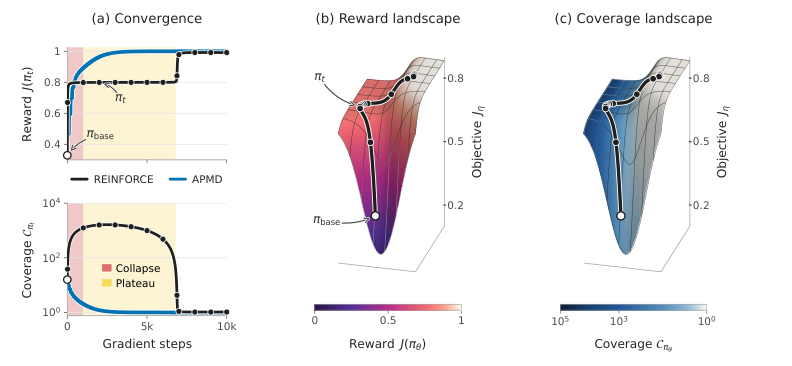
При постобучении языковая модель может почти перестать выдавать лучший ответ, хотя её средняя награда продолжает расти. В препринте Audrey Huang и соавторов, который не проходил рецензирование, числа получены самими авторами: в худшем случае путь к сходимости растёт экспоненциально. Для схем на основе PPO и GRPO это аргумент периодически заменять опорную политику текущей, а не сохранять базовую модель на всём протяжении обучения.
Работа рассматривает покрытие лучших ответов — сколько генераций в среднем нужно модели, чтобы получить ответ с максимальной наградой. REINFORCE, на котором основаны PPO и GRPO, может сначала повысить среднюю награду, но одновременно снизить вероятность лучших ответов почти до нуля. Тогда полезные примеры перестают попадать в обучающие пакеты, градиент ослабевает, а оптимизация застревает.
Авторы построили пример с одним запросом, табличной политикой и точными градиентами, чтобы отделить этот эффект от шума при выборке и влияния общих параметров. Штраф за отклонение распределения ответов от базовой модели через KL-дивергенцию проблему не устраняет: слабый штраф допускает потерю покрытия, а сильный не даёт политике далеко продвинуться.
Предложенная схема APMD разбивает обучение на локальные этапы. На каждом этапе сильная регуляризация удерживает модель рядом с опорной политикой, после чего текущая политика становится новой опорной. Последовательность таких небольших переходов сохраняет доступ к лучшим ответам и при заданных условиях приводит к глобальному оптимуму.
Гарантии доказаны для линейных политик, где вероятности ответов задаёт softmax поверх замороженных признаков, и для одношагового рассуждения, в котором весь ответ считается одним действием. В этих условиях разобраны упрощённые варианты PPO и GRPO со сбросом опорной политики, а также методы с квадратичной функцией потерь, включая схемы семейства Kimi. Это теоретическое основание для настройки регуляризации, числа внутренних шагов и частоты обновления опорной политики, а не практический замер качества полноразмерных LLM.
Источники
Иллюстрация: рисунок из статьи «A Theory of Policy Optimization in Post-Training: Coverage Collapse and Reference Resets», Audrey Huang, Nan Jiang, Sham M. Kakade и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


